开发者改造开源听写应用Handy,让其读取屏幕内容实现离线上下文感知听写
来源标题:Offline context-aware dictation without screenshots, LLMs or fine-tuning
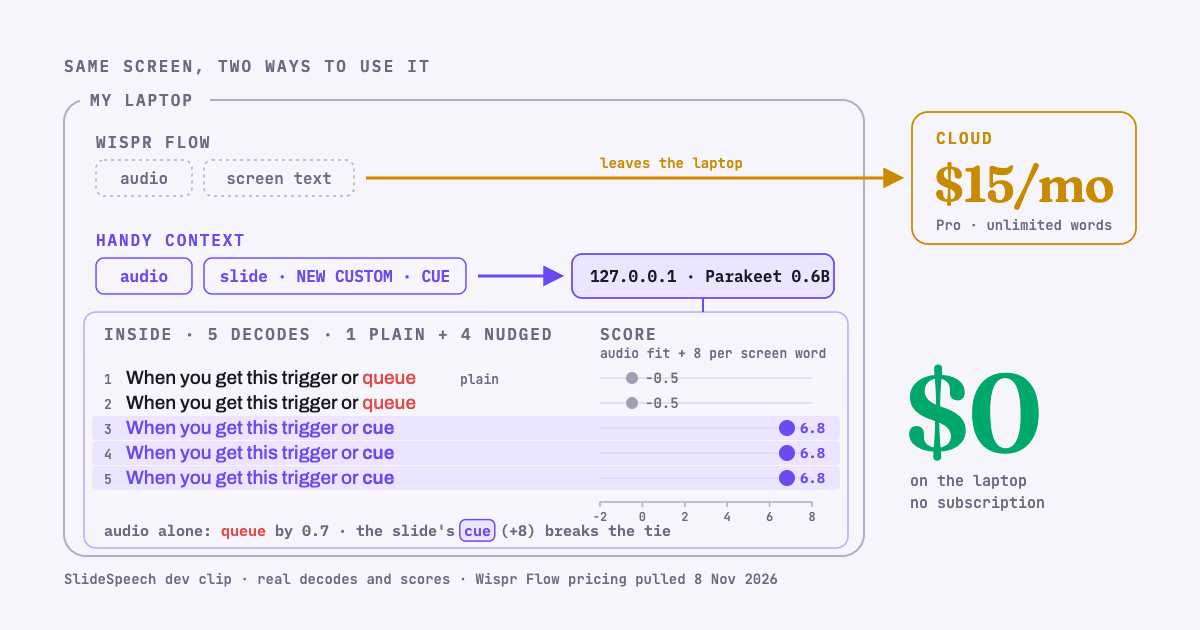
开发者基于开源离线听写应用Handy分叉出Handy Context,通过屏幕阅读辅助纠正同音词和专有名词,无需截图、LLM或微调。该方案利用系统辅助功能权限读取前台窗口文本,与VoiceInk对比测试,但仍存在屏幕内容覆盖正确听写词的风险。原版Handy免费且离线运行,而Wispr Flow Pro无限听写月费15美元。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Wispr Flow 最出色的功能是能正确拼写名字,因为它会从你的屏幕上读取这些名字。但它也会把你的音频和那些文本发送到它的云端。Pro 版的不限量听写每月 15 美元,按年付费则是每月 12 美元(截至 2026 年 11 月 8 日)。
既然这些组件本来都是免费的,我不想为此付费。Handy 是 cjpais 开发的一款离线运行的开源听写应用。它推荐的模型 Parakeet 采用开放权重。操作系统本身也允许拥有辅助功能权限的应用读取屏幕上的文本。
于是我把 Handy fork 了一份,教会我的这个副本在我听写时读取前台窗口的内容。我把它叫作 Handy Context。这个应用是 cjpais 的作品,我做的部分是屏幕读取以及背后的转写流水线。我用 VoiceInk 做了对比测试;VoiceInk 是一款开源应用,它通过从词表中换入相近的匹配项来修正转写结果。
下面是同一段音频在有幻灯片文本和无幻灯片文本时的结果。
“Queue”和“cue”发音相同,只有幻灯片才能确定是哪个。像“gut microbiota”这样的术语和 Proscia 这样的名字也是同样的情况。最后一段是我最担心的失败情形:幻灯片覆盖了说话人原本说对的一个词。我花了很多精力来防止这种情况。
没有新模型。Handy Context 改变的是 Parakeet 周围发生的事情。
Handy Context音频 · 自定义词 · 屏幕文本
屏幕文本从不会进入模型。它只改变解码器尝试哪些词序列,以及最终选中哪一个。Handy Context 运行的是 NVIDIA 发布的那个 checkpoint(文件哈希与 Hugging Face 一致),没有做任何微调。Handy 使用的是同一套权重的 8 位副本,在 LibriSpeech 上与原版的得分相差在 0.002 分以内。
每个候选结果都会得到 Parakeet 自身对音频的评分,再加上其中每出现一个屏幕词就获得的小额加分。因此,屏幕词可以在势均力敌时胜出,但无法覆盖音频明确说出的其他内容。VoiceInk 则是不加核对地把任何看起来接近词表的词直接替换掉。
真实的幻灯片需要两条额外规则。匹配会忽略复数和拼写变体,因此幻灯片上写的是“Careers”时,不会把说出的“career”变成“Careers”。另外,任何修正都不能只改变一个词的词尾。
所有数据都不会离开这台笔记本电脑。它需要与 Wispr Flow 相同的麦克风和辅助功能权限。它只读取文本,因此从不截取屏幕。来自 Handy 自定义词列表的词总是被排到列表最前面。
我在下载测试数据之前先写下了预期结果,然后只跑了一次测试。SlideSpeech 是一组带有对应幻灯片的演讲录音。词表来自屏幕上显示的那张幻灯片,或者来自整场演讲的所有幻灯片,以模拟屏幕内容繁杂的情况。
在提供屏幕信息的情况下,Parakeet 在该基准上把屏幕上的词认错的数量减少了约三分之一,把生僻词认错的数量减少了约三分之二。代价很小。整体错误率在只有一张幻灯片时上升 0.04 个百分点,在整场演讲的幻灯片都提供时上升 0.11 个百分点,而当屏幕内容无关时几乎不变。解码工作量最多增加到九倍,这一点在第 04 节讨论。
Handy Context 把屏幕上的词认错的数量比纯 Parakeet 少 35%,比 VoiceInk 的方法少 26%。随着屏幕内容增多,VoiceInk 的方法还会抬高整体错误率,从 Parakeet 的 8.76% 升到整场演讲幻灯片都提供时的 10.70%。
我自己的一项检查没有通过。当整场演讲的幻灯片都在屏幕上时,Handy Context 的整体错误率比 Parakeet 高 0.11 个百分点。其置信区间的上限超过了我设定的 +0.15 上限。
VoiceInk 是在本地运行的未修改版本,没有启用其可选的云端 LLM 步骤。“纯 Parakeet”指的是同一个 checkpoint 在不提供屏幕文本的情况下解码一次。
在这一项的标准基准 Meta LibriSpeech biasing 词表上,差距更大。该基准会把每个句子中的生僻词藏在最多 1,000 个干扰词当中。
这些数字来自核心流水线,是在应用针对真实幻灯片的两条额外规则之前测得的。我为这次测试提出的四项主张全部通过。
我原本以为要靠训练才能达到这个效果,并为此花了将近一天时间尝试。这些尝试没有一个胜过未经训练的流水线。
首先,我在冻结模型之上加了一个指针层,学习复制词表中的词(TCPGen 风格)。第一个版本在词表词上的错误远多于纯 Parakeet。第二个版本好一些,但仍然落后于未经训练的加权提升方法,而且当词表内容无关时会损害准确率。
然后,我训练了一些小型关键词检测器,用来猜测哪些屏幕词实际上被说出来了。它们确实有效,把 1,000 词的列表缩减到约 3 个词,同时保留了 98% 的正确词。但未经训练的流水线得分仍然略好一些,所以它们没有上线。对于内容繁杂的屏幕,它们是我最有希望的方案。
一个小型模型负责在候选解码结果中挑选,但根据训练数据的不同,它要么过于保守,要么过于激进。我从未对 Parakeet 本身进行微调。
把词表交给语音 LLM 也没有帮助。Qwen3-ASR-1.7B 在提供 1,000 个词时,漏掉词表词的频率与不提供时一样高,而且运行速度慢了约 10 倍。给 Whisper large-v3-turbo 加词汇提示反而让整体表现变差,WER 从 3.53% 升到 4.8–5.6%。
VoiceInk 式的替换把真实幻灯片上的整体错误率从 8.25% 抬高到 8.79%。它大约一半的错误替换只改变了词的词尾,比如把“career”变成“Careers”。那两条额外规则正是由此而来。
一段 2–14 秒的听写会在 0.2–0.5 秒内返回结果。内存才是真正的成本。服务端以全精度在 PyTorch 中运行 Parakeet,而 Handy 运行的是同一模型的 8 位构建版本。总内存中约有 2.7 GiB 是 PyTorch 的 GPU 缓存。在每次听写后释放该缓存,并且只在需要时加载 Handy 的备用模型,应该能把内存降到 4 GiB 以下。把流水线移植到 Handy 自己的引擎中,则能让它回到 Handy 的体积。
目前它只支持英语,并且只在一个桌面操作系统上运行。还没有 OCR,因此那些把文本绘制成图像的应用没有可供它读取的内容。内容繁杂的屏幕是主要的未解决问题。下一步是按词条与光标的接近程度进行排序。
代码是私有的,所以这里给出完整的做法。下面的每一项设置都是应用实际运行时使用的设置。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。