分析:自建开源推理引擎出租GPU能否盈利
来源标题:Is hosting an open-source inference engine profitable?
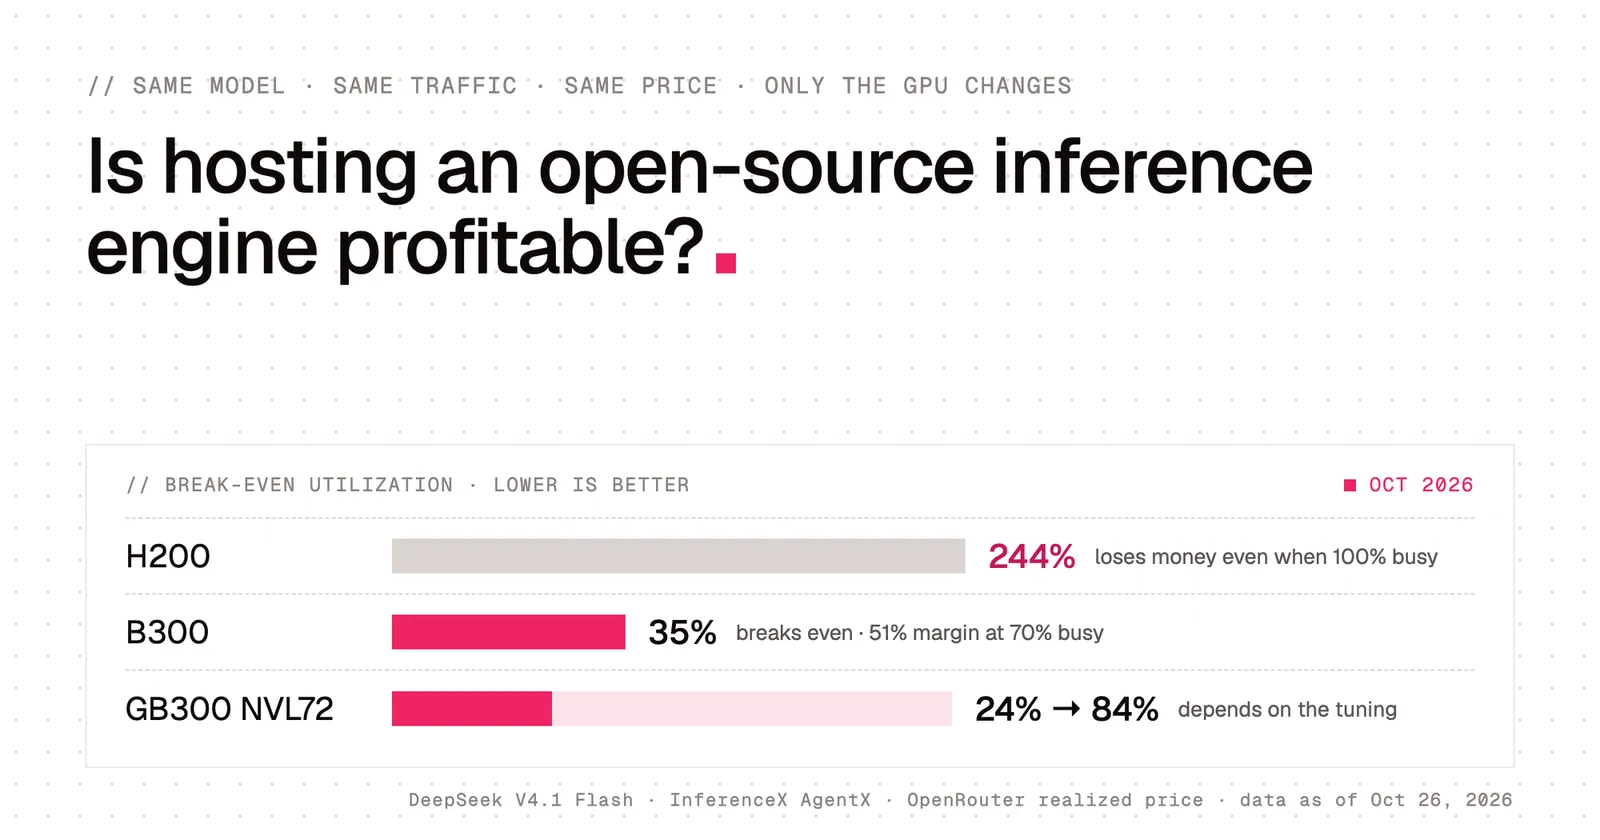
公开数据分析显示,出租GPU跑开源推理引擎能否盈利主要取决于显卡型号而非引擎本身:H200即使满载也亏钱,B300在利用率达35%时即可盈利。分析同时指出,vLLM、SGLang等开源引擎已相当成熟,DeepSeek开源的DeepInfer也被vLLM团队在相同硬件上复现出6%以内的解码吞吐差距。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
TL;DR:H200 即使满载也亏钱。B300 忙碌度达到 35% 就开始赚钱。你租哪张 GPU 卡,比跑哪个推理引擎更重要。
X 和 LinkedIn 上常见一种说法:推理是门轻松的生意,需求旺到只要能租到 GPU,谁都能卖 token 赚钱,不需要自己的技术。本文用公开数据检验这一说法。
先说句公道话:开源推理引擎如今已经成熟。vLLM 和 SGLang 都是生产级,DeepSeek 也刚刚开源了自家 API 背后的引擎 DeepInfer(DeepInfer 部署问答)。vLLM 团队在相同硬件上复现了 DeepInfer 的 decode 吞吐,差距在 6% 以内(vLLM,2026 年 10 月 23 日)。即便如此,我也认识几家自己手写引擎、效果极好的公司。做推理服务的朋友也证实:自己攒的引擎同样能达到那个水平。所以引擎已是解决好的问题,无论你用什么方式拿到它。
另一派则说:这是价格战,利润率顶多 10%,常常是负的。他们指着 OpenRouter 说,那里有 29 家供应商卖同一个 DeepSeek V4.1 Flash,最便宜的输入报价每百万 token 0.056 美元,而大多数在 0.30 美元左右,怎么算都低于成本(Jeff Xiong,2026 年 10 月 23 日;OpenRouter 供应商列表)。OpenRouter 自己的数据说出了那个不便明说的真相:2026 年上半年 V4 的 token 量大约翻了一倍,而它在总支出中的份额几乎没动(OpenRouter Insights,2026 年 7 月)。
两边引用的都是真实数字。“DeepSeek 每 GPU 小时赚 38 美元”那一派(DeepInfer 部署问答,2026 年 10 月)和“OpenRouter 上人人亏钱”那一派,量的根本不是同一件事。
所以本文只用公开数据:GPU 租价、同一模型在每张卡上实测的吞吐、每张卡实际能跑的精度,以及市场实际为每个 token 付多少钱。一个模型、一种流量模式、一个速度承诺、一个价格、一种租价。只换卡。问题很简单:如果你买卡或租卡来托管一个模型,你赚钱吗?
答案是:可以盈利,但只在 Blackwell 上,只在你卡的忙碌度超过三分之一时,且只有你不去打价格战。一台 8×B300 节点在 50–70% 利用率下,毛利率为 31–51%。H200 在任何利用率下都无法回本。
下面的设定全程固定。改动其中任何一项都会改变结论,所以值得精确写明。
模型:DeepSeek V4.1 Flash。它大幅领先,是 OpenRouter 上排名第一的开源权重模型,在 10 月 19–25 日那一周约占全部 token 的 30%(OpenRouter 排名),也是唯一在三张卡上都有公开第三方实测数据的模型。
流量:SemiAnalysis 的 AgentX 工作负载:回放了 393 个真实 Claude Code 会话,输入中位数 142k token,输出中位数 444 token,约 95% 的输入是缓存命中(AgentX 方法论)。这就是 2026 年 OpenRouter 流量的真实样子:前 10 大应用全是编程 agent(OpenRouter 应用),agent 流量是人类流量的 7 倍,约 87% 的 token 由缓存提供(OpenRouter,《缓存至关重要》,2026 年 10 月 8 日)。聊天机器人现在只占一小部分。
速度承诺:每用户 100 输出 token/s。OpenRouter 上供应商的中位数约为 35(SemiAnalysis,InferenceX v2),所以这个要求很严,但这是三张卡都有数据的唯一档位。
吞吐:每张卡在 InferenceX 上最好的公开开源引擎结果(H200、B300、GB300 NVL72),vLLM / SGLang / Dynamo,权重一律 FP4。H200 通过反量化 kernel 跑 FP4 权重;Blackwell 原生跑 FP4。
价格:OpenRouter 供应商今天在这个模型上实际收到的钱:每百万输入 token 0.013 美元(缓存与未缓存混合),每百万输出 token 0.57 美元(OpenRouter,V4.1 Flash 1017 供应商)。按 99/1 的输入输出比,合计每百万 token 0.019 美元。不是标价,不是 DeepSeek 的错峰价,而是市场实际支付的价格。
租价:公开可见的最低按需价格。H200 为 3.99 美元,B300 为 7.40 美元(Hyperstack)。GB300 NVL72 没有公开的整机柜价格,所以我用了 SAVRN 指数中的 15.21 美元(SAVRN GPU 价格指数)。
利用率:你实际卖出的 token ÷ 基准测试表明你能卖出的 token。不是 GPU 忙碌时间。一个没有直客、只靠 OpenRouter 路由的新供应商,落在 10–30%。DeepInfra 称典型的自托管推理在 10–20%(DeepInfra,2026 年 8 月),这与新供应商告诉我们的情况吻合。
一个公式:每 GPU 小时毛利 = tokens/s × 3600 × 价格 × 利用率 − 租金。不含带宽、不含人力、不含冗余容量。如果这样都算不过来,加上那些更算不过来。
按今天市场支付的价格,H200 连租金都覆盖不了,一台 8×B300 节点在 35% 利用率下回本,一台 GB300 NVL72 机柜则视配置不同,在 24% 到 84% 之间回本。
单看吞吐和租金,无法跨卡比较。两者相除,就得到可以比较的数字:满载时每百万 token 烧掉多少租金。市场每百万 token 付 0.0188 美元,这就是要跨过的线。
最后一列用一个数字概括全文。括号里的百分比同时也是盈亏平衡利用率:如果满载时租金吃掉价格的 35%,你就需要 35% 的忙碌度才能覆盖它。
然后是每张卡赚多少。不同卡的租金相差 2–4 倍,所以每 GPU 的美元数不可直接比较,公平的尺子是毛利率:1 − 租金 ÷ 收入。我用 50% 作为门槛:低于这个数,带宽、人力、冗余容量和偶尔的空闲周就会把剩下的吃光。
换算成美元,那两张能赚钱的卡:一台 B300 在 50% 忙碌度下每 GPU 每月净赚约 2,400 美元,70% 时约 5,500 美元;一台调优过的 GB300 机柜分别净赚 12,500 美元和 22,000 美元。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。