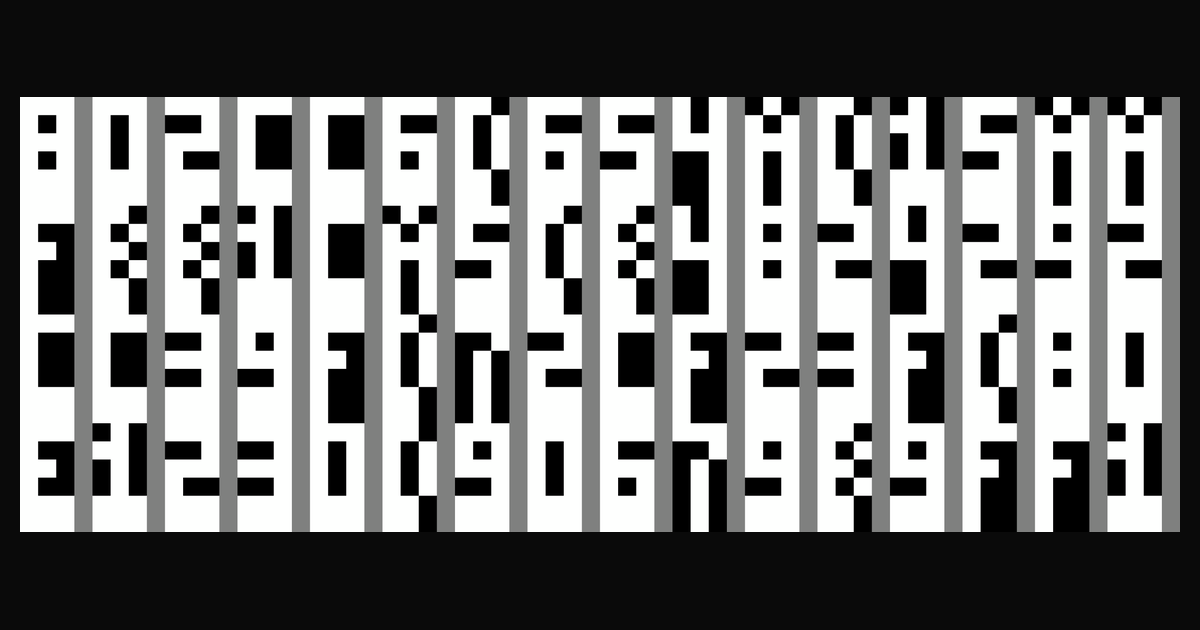
研究人员将 HEIC 解码器改造成 SHA-256 计算器,生成首个 HEIC 哈希奎因图像
来源标题:Turning the HEIC decoder into a SHA-256 computer
研究人员把 HEIC 解码器当作计算引擎,生成了据其所知首个 HEIC SHA-256 hashquine(哈希奎因)图像。该文件大小为 536,870,946 字节,其 SHA-256 值与解码后图像像素中显示的十六进制文本完全一致。HEVC 解码器通过重建 564 幅画面的计算来执行 SHA-256 的完整压缩过程,该项目需要从零编写专用编译器。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在上一篇文章中,我们介绍了如何将 JPEG XL 解码器改造成一台人工 CPU,并用它生成了——据我们所知——第一张 JXL SHA-256 hashquine 图像。这一次,我们用 HEIC 做到了同样的事,生成了据我们所知的第一张 HEIC SHA-256 hashquine 图像。事实证明,HEIC 是一个难度大得多的目标。为了达成这一目标,我们深入理解了该格式,在解码器中寻找能够承载基本计算原语的面,并最终从零编写了一个自定义编译器,而不是修改现成的编码器。
这个精确大小为 536,870,946 字节的文件具有以下 SHA-256:
802cc6d654ad15aafbb1ca5db4824292cc39fd72cf23fd80e1230d90679b9ff1
用 Apple 原版 ImageIO 解码同一文件中的最终图像,其像素拼出:
802cc6d654ad15aa fbb1ca5db4824292 cc39fd72cf23fd80 e1230d90679b9ff1
两个值完全相同。可见文本不是元数据、不是叠加层、不是文件名,也不是事后插入的摘要。HEVC 解码器重建了一个包含 564 帧图像的计算过程。该计算执行了 SHA-256 消息调度和全部 64 轮压缩,完成了前馈,将 256 位摘要转换为十六进制,查询了字体 ROM,并让最后一帧图像显示结果。
创作端是一个自定义编译器。播放端是 Apple 未经修改的解码器。
当一个系统已有的状态转换可以被解释为其设计者并未打算暴露的编程模型时,一台“怪异机器”就出现了。这不一定涉及内存损坏。解析器、解压器、数据包引擎或图像解码器本来就接受一种语言,并根据其输入所选择的规则更新状态。如果这些规则提供了有用的逻辑、存储和顺序,那么一个文件就可以既描述内容,也描述计算。
最著名的例子是 FORCEDENTRY,即 NSO Group 的零点击 iMessage 漏洞利用。用 Google Project Zero 的话说:“利用超过 70,000 条定义逻辑位操作的段命令,他们定义了一个小型计算机架构,具备寄存器和完整的 64 位加法器与比较器等功能。”那台机器由 JBIG2 图像操作构建,并由一个内存损坏漏洞引导启动。而我们的方案完全不需要任何漏洞。
HEVC 帧内预测提供了局部数据移动。残差提供了受控修正。光栅依赖顺序提供了因果性。PCM 提供了输入窗口。帧间预测提供了帧与帧之间的总线。最终的亮度采样就是输出设备。
这是一台有限的、专用用途的计算机。它不需要图灵完备才能有趣或计算 SHA-256。对于这一个固定程序而言,它只需要足够的存储、布尔逻辑、模加法、路由和时间:一次 SHA-256 压缩加上字形渲染大约需要 150,000 个二输入门。
这一区别很重要。“这个解码器能否实现一台无界的通用计算机?”和“一个合法文件能否让这个解码器求值一个特定的 64 轮电路?”是非常不同的问题。我们解决的是后者。
HEIF,标准化为 ISO/IEC 23008-12,是一种构建在 ISO Base Media File Format 之上的媒体容器,与 .mp4 具有相同的嵌套 box 结构。“HEIC”是 HEIF 内容的常见文件扩展名,其图像使用 HEVC/H.265 编码。Apple 在 iOS 11 和 macOS High Sierra 中引入了系统级 HEIF 支持,在 WWDC 2017 上解释了图像项和序列模型,并从此将 HEIC 作为 iPhone 的默认照片格式。在 Apple 平台上,这些文件由 ImageIO 解码,我们正是针对它进行测试。
一个 HEIF 文件可以通过两种方式存放其图像,最终产物使用的是第二种:
正是“任意物理顺序”这一细节让自引用得以成立,我们将在后面看到。
HEVC 从块重建图像。在我们编译器使用的层级上,一个单元是一个 8x8 亮度编码单元,包含四个 4x4 预测单元。帧内编码单元选择一个预测器,读取其北、西或西北方向已重建的采样,然后应用任何编码残差。P 帧则可能使用运动补偿从更早的参考帧复制采样:
我们将解码器固定在一个完全可预测的配置中:使用 cu_transquant_bypass 使残差无损相加,使用 PCM 处理原始字面量,并禁用去块滤波和 SAO 环路滤波器。在这些设置下,每个输出采样都是其参考的精确整数函数,我们的预测器软件模型能够逐位复现解码器的结果。如果解码不是精确的,“像素等于哈希”就永远不可能成立。
那些“北”、“西”和“前一帧”的关系定义了一台物理机器。在一帧图像内,一个块只能读取已经解码的内容,因此信息向东和向南流动。将值向西移动只能每行移动一个单元,而且只有在 Z 序使得右上参考可用时才行。保持一个值存活,需要为它存活的每一行消耗一列。这两个事实——东/南方向便宜,西方向昂贵,以及状态需要支付“租金”——塑造了后续的一切。
编译器直接输出比特流:VPS、SPS、PPS、slice、预测模式、残差系数、运动向量、PCM 块、CABAC bin,最后是 HEIF box 和 sample 表。我们没有修改解码器,最终产物也不依赖于自定义编解码器特性。我们也没有修改编码器:编码器的设计目标是选择使误差最小的模式,而我们需要指定每一个模式、残差和运动向量。
这个项目还意外地成为了一个对编码智能体及其运行框架极为有效的基准测试。在我们自己使用 Codex 中的 GPT-6 Ultra 和 Claude Code 中的 Claude Opus 5.5 进行的尝试中,智能体们反复宣称目标不可能实现。即使在展示了成功的中间产物之后,仍有几个智能体回到了同样失败的单一图像假设上。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。