CI通过不等于代码可靠:绿色构建的局限
来源标题:Does a Green Build Mean the Code Works?
CI通过只说明工作流在特定配置和环境下达到了设定的成功状态,并不代表代码真正可用。其可信度取决于实际运行了哪些检查、在什么环境中运行,以及复用了哪些结果。缺失依赖导致启动失败、关键检查被跳过等情况,往往说明流水线只是按配置执行,而非系统故障。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
一次通过的 CI 运行是有用的证据,但它的意义取决于运行了哪些检查、在什么环境中运行,以及复用了哪些结果。
持续集成本应让一个常见的工程决策变得更简单:这个变更可以合并了吗?
一个 pull request 变绿了。测试通过了,linter 没发现问题,应用也构建成功了。看起来可以合理地合并。但如果应用因为缺少某个依赖而在启动时失败呢?或者某个重要检查被完全跳过了呢?
这些失败并不一定意味着 CI 系统出了故障。通常,流水线只是做了它被配置去做的事。问题出在人们假设它的结果能证明一些它从未测试过的东西。
要判断一次绿色构建应当获得多少信任,我们首先应该理解它验证了什么、它的盲区从何而来,以及在发布前还有哪些额外检查值得运行。
绿色构建意味着某个 CI workflow 针对特定 revision,使用特定的配置和执行环境,达到了其配置的成功状态。
这是一个有用的结果,但它的范围取决于实际执行的工作。一个通过的单元测试证明其断言对它实际覆盖的输入成立。一次成功的类型检查证明类型检查器在其配置规则下接受了代码。一次成功的构建证明构建工具产出了预期输出,且没有报告阻断性错误。
这些检查中的任何一个单独来看,都不能证明应用在生产环境中会正确运行。即使合在一起,它们也只覆盖了实际被执行到的条件和行为。
还有另一个复杂因素:即使某些 job 被有意跳过或被允许失败,一个 workflow 仍然可以成功结束。在把绿色当作发布信号之前,最好先弄清哪些检查提供了证据,哪些没有。
假设某个仓库只在 src/ 下的文件发生变更时才运行 lint。当有人更新文档时,这是一种避免不必要工作的合理方式。
现在设想 lint 配置位于仓库根目录。对该文件的修改可能会影响每个源文件的检查方式,但路径过滤器仍然可能跳过 lint,因为 src/ 下没有任何变更。
workflow 保持绿色。新配置从未针对源代码被测试过。
当被跳过的工作确实不必要时,跳过 job 是有用的。问题在于,让某个对本次变更而言必需的检查从证据中消失,却没有人注意到。
反过来也可能发生。如果某个必需的 job 因为依赖安装失败而无法启动,红色结果首先告诉我们的是执行问题,而不是源代码的问题。良好的 CI 报告能让这种区别可见。
考虑一个带有如下 import 的 Python 包:
import yaml
该包需要 PyYAML,但它的依赖清单没有声明它。在开发者机器上或长期运行的 CI runner 上,PyYAML 可能已经安装好了。在那里导入这个包可以正常工作。
格式化工具可以在不执行 import 的情况下通过。Python 字节码编译也可以成功,因为编译模块并不会执行其 import 语句。如果测试从未走到那条 import 路径,那么所有配置的检查都可能通过。
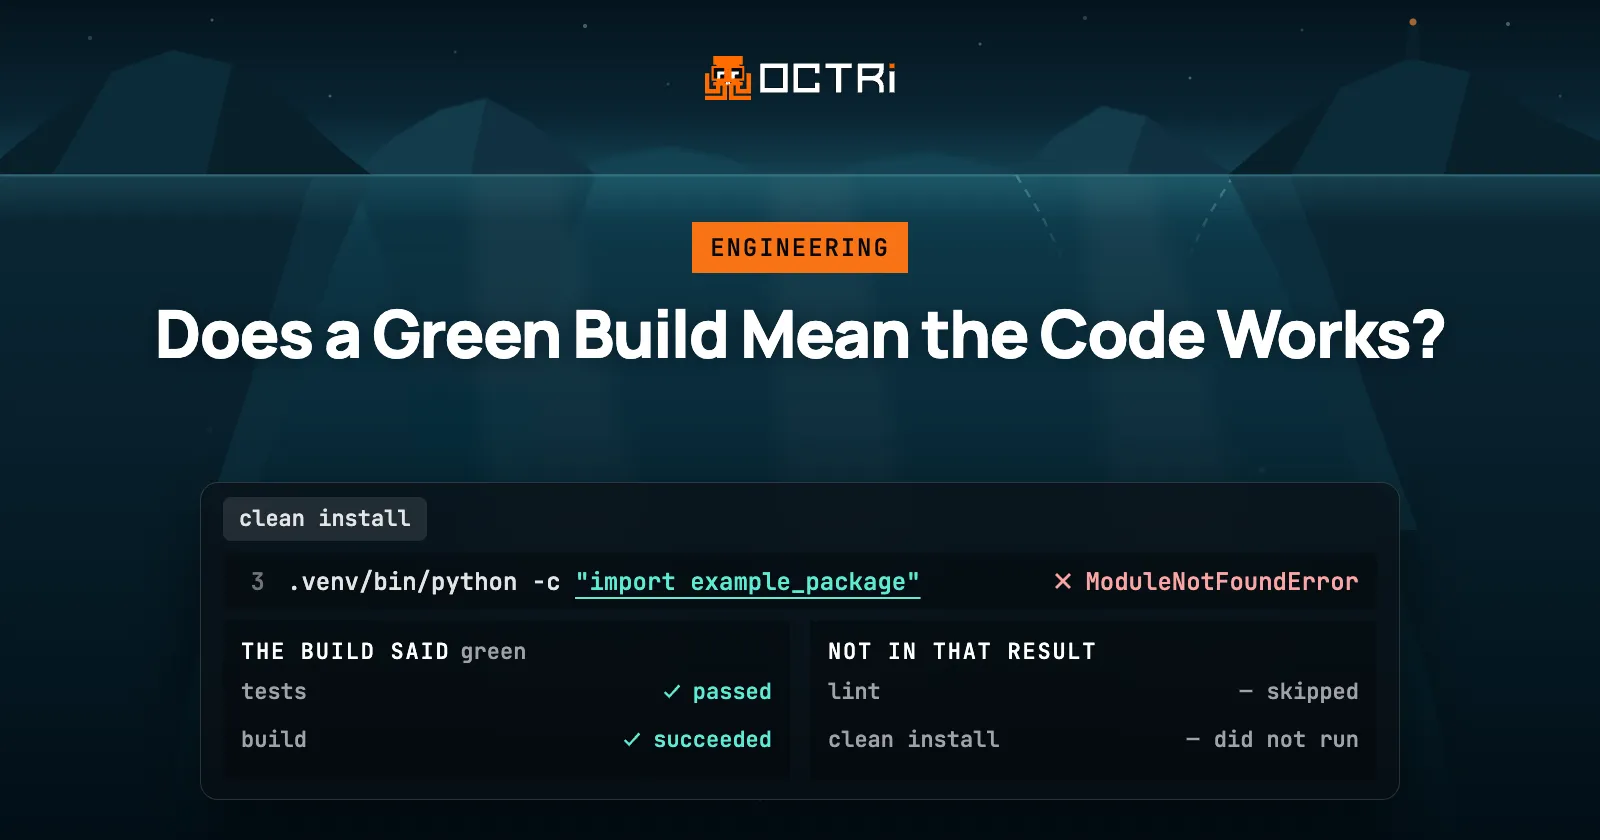
现在在一个全新环境中安装这个包。import 会以 ModuleNotFoundError 失败。
源代码在这些运行之间没有变化。可用的依赖变了。
干净安装的冒烟测试检查了先前流水线遗漏的一个假设。对于 Python 包,基本思路大致如下:
python -m venv .venv
.venv/bin/python -m pip install .
.venv/bin/python -c "import example_package"
这里,example_package 代表被测试的包。关键在于,环境启动时不包含无关的包,并且从项目自身的声明中安装依赖。
这个测试不会证明每个运行时行为都正确,但它能捕获一类部署失败,而格式化、编译和隔离的单元测试可能永远遇不到这类失败。
环境也可能让正确的代码失败。
Composer 可以生成 classmap,PHP 用它来定位类。如果新增了一个类,而某个 fixture 保留了旧的 classmap,测试可能会报告 Class not found,即使该类在源代码中存在。重新生成 autoloader 就能解决这个问题,而无需修改源代码。
缓存的编译器输出、生成的文件和依赖元数据也可能导致类似的失败。在每种情况下,测试使用的都是从先前版本的输入创建出来的产物。
每次提交都从头重建一切是浪费。缓存能节省真实的时间。但只有当决定结果的那些输入仍然匹配时,结果才可复用。这些输入可能包括依赖版本、编译器版本、构建标志和配置,以及源文件。
如果一次干净构建后失败消失了,就要调查先前的构建复用了什么。如果一次令人意外的成功依赖于缓存,就在没有缓存的情况下重新运行相关检查。这两种对比都有助于确定结论是否属于当前代码。
通常不需要。文档编辑可能不需要与依赖升级相同的验证。测试矩阵可能包含多个产生相同输出的配置。重复所有这些工作会拖慢反馈,却不会增加有意义的覆盖。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。