研究显示前沿大模型可直接读写神经网络权重
来源标题:Astra can read and write weights to improve Qwen
当前一代前沿大模型在自然语言中已能理解并构造神经网络权重,以自然语言目标直接读写权重来改进Qwen。研究指出,此前业界主要用LLM优化提示词、程序及训练代码和超参数,而人类几乎无法手工完成权重层面的优化。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
如果让你手工设计一个会下围棋的神经网络,你会怎么做?如果直接把神经网络的原始权重交给你,让你预测它的行为,你该从哪儿下手?对几乎任何人来说,这都基本不可能。
如今,权重的生成方式有三种:通过优化得到,由专门训练来生成权重的定制网络写出,或者由编译器从形式化程序编译而来。在这篇文章中,我们发现,当前这一代前沿 LLM 在原生自然语言环境下使用时,正开始令人不安地擅长围绕自然语言目标去理解和构造神经网络权重。
这几年,我们一直在用 LLM 优化文本类产物,比如 prompt 以及围绕 prompt 构建的程序。最近,我们又开始用它们优化整个 harness,以及训练 ML 模型的训练代码和超参数。
我们常常为这些方法辩护,理由是我们不知道还有其他有原则的方式能在文本产物上做爬山搜索——不像更新可微神经网络的权重那样有明确方法。毕竟,人类可以手工“优化”代码,所以让 LLM 来做这件事是合理的;但人类无法手工“优化”神经权重,所以这块基本还停留在符号算法的范畴。
在这篇文章中,我们分享一些非常早期的结果,借此可以论证:推理驱动的优化范式,现在也开始降临到可微神经网络上了。
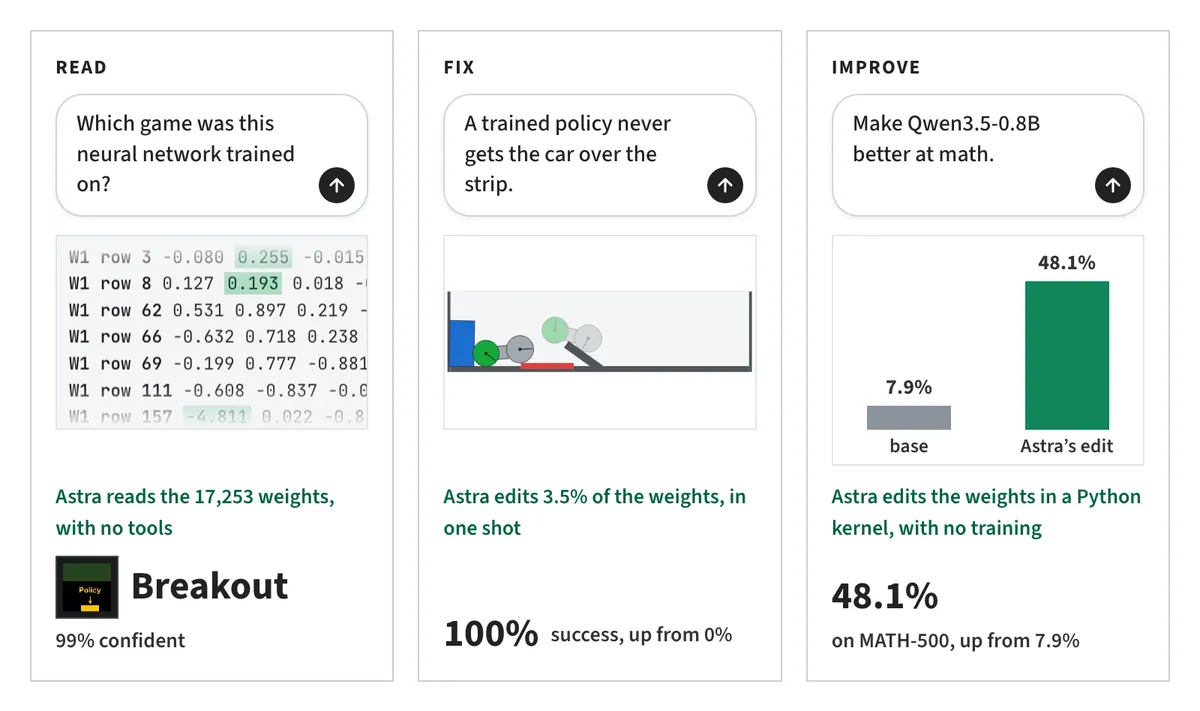
在 Weight-Space Programming 中,一个通用 LLM 围绕某个自然语言规格,直接读写网络的权重(也就是说,不经过优化器,尤其不借助梯度下降),有时甚至完全没有环境反馈。
用自然语言,已经有可能“直接让”LLM 原生地在神经网络权重中找到隐藏特征或故障、修复该故障,或者从零写出一个新网络。下面我们报告在每一方向上的早期且令人兴奋的结果,先从小网络开始,然后甚至扩展到真实语言模型:
我们先做一个小规模实验,看看 LLM 能否理解连续权重空间——它本质上就是一串数字。
在最初的实验中,我们用某种算法训练一个神经网络。如果 LLM 仅凭权重就能说出它的行为,那将非常令人兴奋。
我们用 PPO 训练神经网络策略来玩四个电脑游戏。四个网络输入通道相同、动作空间相同、网络维度完全一致,因此除非读取权重,否则无法区分。
对每个网络,我们把它原始权重作为 prompt 传给 Astra,并问:这个神经网络是在哪个游戏上训练的?即使没有给出候选游戏列表,Astra 仍然能为全部四个网络说出正确的游戏。这尤其令人兴奋,因为世上游戏那么多,Astra 可选的答案范围极大。
看起来 Astra 仅凭权重的特征,就能推断出每个网络是为玩哪个游戏而构建的。例如,每个输入通道的第一层权重集中在哪里(比如 Breakout 中,智能体的权重集中在底行,也就是挡板),以及输出层区分哪些动作。
接下来,我们想看这是否能泛化到其他任务和模型。
我们训练扩散模型(DDPM)分别生成圆形、三角形和正方形图像。然后问 Astra,能否仅凭权重判断这些 DDPM 被训练来生成什么。我们不允许它使用工具或做前向传播。
Astra 仅凭权重就能说出每个模型生成什么。它在输出层找到了形状——每个隐藏单元的权重画出形状边缘的一小段,而它只画这些边缘。有趣的是,它把每个形状都画成轮廓,忽略了实际模型生成的是实心形状。这个错误某种程度上说明它并不依赖计算前向传播,而是真的在读取权重的结构/几何。
在上面的前两个实验中,Astra 并没有真正看整个网络,只读第一层或最后一层就能过关。对于更大的模型(尤其是语言模型)以及我们真正关心的问题,这不是可扩展的策略,因为它们处理和思考输入的过程往往发生在中间层。所以接下来,我们去掉第一层和最后一层,只把中间层留给 Astra。
我们训练三个小语言模型(7.2M 参数)做下一字符预测,分别基于 Python 代码、日语罗马字和英语。然后我们移除输入层和输出层,只给 Astra 中间四个 transformer block。没有这两层,权重里没有任何信息说明哪个字符是哪个,模型也无法在任何文本上运行。Astra 可以用 Python 分析权重,但不能在任何输入上运行网络或其任何层。
我们问:这个网络是在哪种语言上训练的,以及它的 24 个注意力头各自在做什么。Astra 在两次尝试中都为全部三个网络说出了正确的语言。它还找出了每一个复制头(induction head)——即让模型重复之前见过文本的注意力头——并且没有把其他任何头误判为复制头。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。