AI逆向工程演示:反编译器输出可能误导,需用机器指令交叉验证
来源标题:Reverse Engineering with AI: Your Decompiler Can Lie to You
一项XRef 0.4.0逆向工程演示表明,反编译器给出的伪C代码分支可能与实际机器指令不符,所有结论都需对照指令和调用点核验。公开示例中有2000个诱饵函数写入与真实函数相同的字段偏移,仅凭字段写入评分无法区分。真正函数因与序列化器共享调用者main而多出10分,诱饵函数则没有任何调用者。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
一个字段名、2000个长相相同的函数,再加上一个错误的伪C分支:这是一次XRef走查,其中每个结论都要对照机器指令核验。
TL;DR。序列化后的字段名可以带你找到它们的偏移量。更难的问题是:究竟是哪段代码在修改这些字段——在一个公开示例中,有2000个诱饵函数写入的偏移量与真实函数完全相同。真实函数和展示出来的诱饵函数,在“写这些字段”这一项上得到相同的40分。真实函数多拿10分,是因为它与序列化器共享同一个调用者main;而那些诱饵函数根本没有调用者。接着,候选函数还要对照它的指令和调用点进行核验。这次走查使用XRef 0.4.0,以及一个合成的C与汇编程序;它演示的是一种方法,并不是基准测试。
在0.4.0发布之前,有一次xref字段查询返回了not_found_under_limits:没有匹配的布局。响应中标记出在其分析限制下发现不完整,但它没有提供任何办法来判断工具究竟看到了哪些键,或者在哪里丢失了与这些字段的关联。这个案例记录在issue 76中。
返回空列表很容易让人做出下一步错误举动:随机扩大搜索范围、断定结构不存在,或者开始手工拆解整个二进制文件。我真正需要的,是回答一个窄得多的问题:哪些观察能把一个字段名引向修改它的代码?
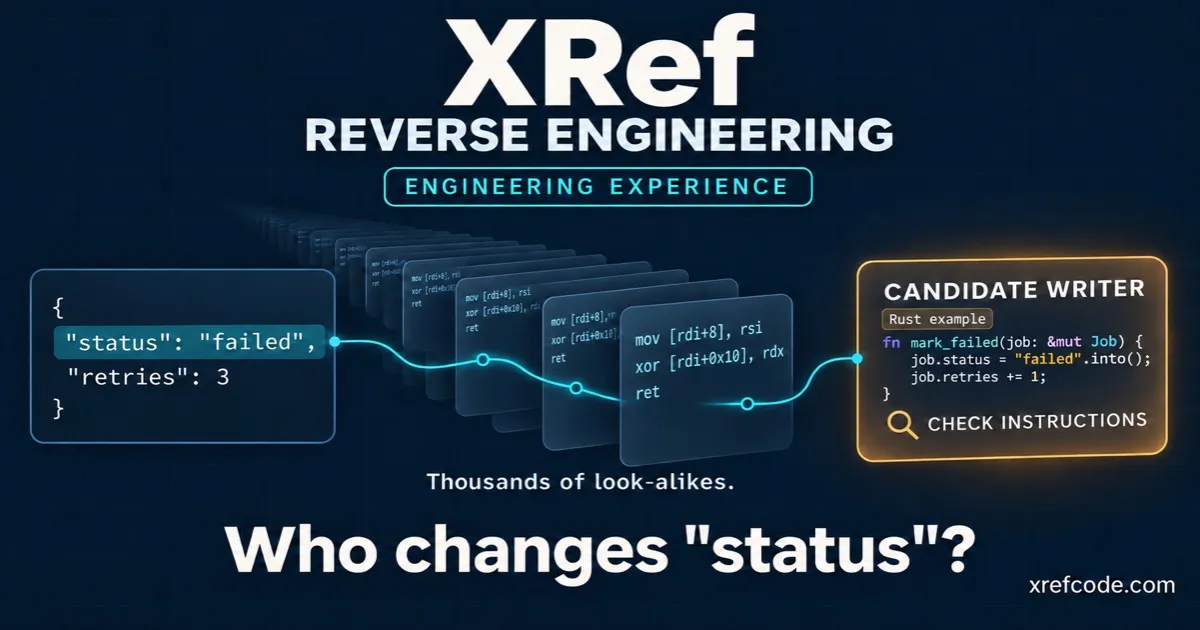
用更熟悉的说法讲:程序报告“status”: “failed”——是哪个函数修改了那个字段?这只是一种便于说明问题的表述方式。下面记录的示例使用键c、m和e,并原样保留,以便把源码、指令和输出放在一起核验。
当AI agent做这项工作时,它需要和人类一样可核验的证据链。在这套设置中,XRef是一个原生分析器:agent通过CLI或MCP向它提问,并使用返回的数据。找到一个看似合理的函数、理解它的作用、正确阅读它的伪C,是三个独立步骤,而标题正来自第三步:后文展示的一个历史XRef复现器所输出的伪C,如果按字面理解,对于机器码求值为4的输入,它会返回99。下面的记录包含CLI命令及其捕获的输出;最后一节把同一流程整理成agent可以遵循的检查清单。
对于一个没有符号的可执行文件来说,这是一个出奇棘手的问题。你可以知道某个字段的名字,因为它会出现在序列化输出中,但对它在内存中如何布局几乎一无所知。源码类型名没有了,函数名也没有了。一个很小的位移可能出现在成千上万条完全无关的指令中。一次看似合理的反编译,可能早在事实支持之前,就让早期猜测显得很有说服力。
在我开发XRef的过程中,这个问题逐渐变得更清晰:先根据序列化字段的名字找到代码,然后匹配一组相邻的键,并找到写入这些字段的函数。短键暴露了下一个缺口:即使是否定结果,也必须说明工具实际检查到了什么。你可以沿着issue 58、74和76追踪这条路径。
xref field命令把键的使用与相对于传入指针的偏移量关联起来,然后找到候选写入函数并对它们排序。字符串引用、偏移量和匹配函数是不同类型的线索。要把它们变成答案,必须沿着整条链走完,并保留每个结论所依赖的指令。
本文一步一步地处理一个问题:哪段代码会修改与这些键关联的值?在此过程中,它会展示那些错误线索,正是它们使这个问题不能简化为简单地搜索内存写入。
为了把这条链走到底,我使用一个已发布的小型测试程序,其答案是已知的,因此每个结论都能对照源码和机器指令核验。真实世界的任务塑造了工具需要完成的工作;而这次走查本身运行在公开示例上。
现有记录使用已发布的XRef 0.4.0 Linux可执行文件。它生成于2026年11月5日;我在这里复用了它的命令和输出,而不是声称进行了一次新的运行。确切的构建修订版和文件哈希在记录的环境信息中(链接见文末)。
目标程序是生成的C和汇编。其中关键的C代码一屏就能放下:
struct record { uint64_t c, m, e; }; void serializer(struct record *p) { emit(“c”, 1, &p->c); emit(“m”, 1, &p->m); emit(“e”, 1, &p->e); void writer(struct record *p, uint64_t value) { p->m += value; p->e ^= value;
这是完整生成源码中的一段摘录。函数属性和构建标志保留了走查所依赖的调用模式。main先调用writer,再调用serializer。
emit函数只做一件事:把键、长度和给定地址处的值混合写入一个volatile变量。这样就在没有真实JSON编码器或Serde的情况下,复现了机器层面的模式“键 + 值地址 → 共享函数”。这是一个用于研究该机制的合成C与汇编示例。要在真实Rust应用上评估准确性,需要单独的评测。
汇编部分添加了2000个诱饵函数。每个函数都从其第一个参数偏移+8和+16处写入。它们中没有一个被调用过。这正是这个问题无法被简单处理的原因:只寻找匹配偏移量的分析会产生大量看似合理的答案。
该程序使用GCC 13.3.0,以-O2 -g0 -fno-inline -fno-ipa-icf构建,然后通过objcopy --strip-all处理。XRef报告有2007个函数和零个符号;在记录的示例中,这些函数的边界来自.eh_frame,即栈展开数据。分析运行在剥离符号后的文件上;单独参考构建的符号仅用于核验答案。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。