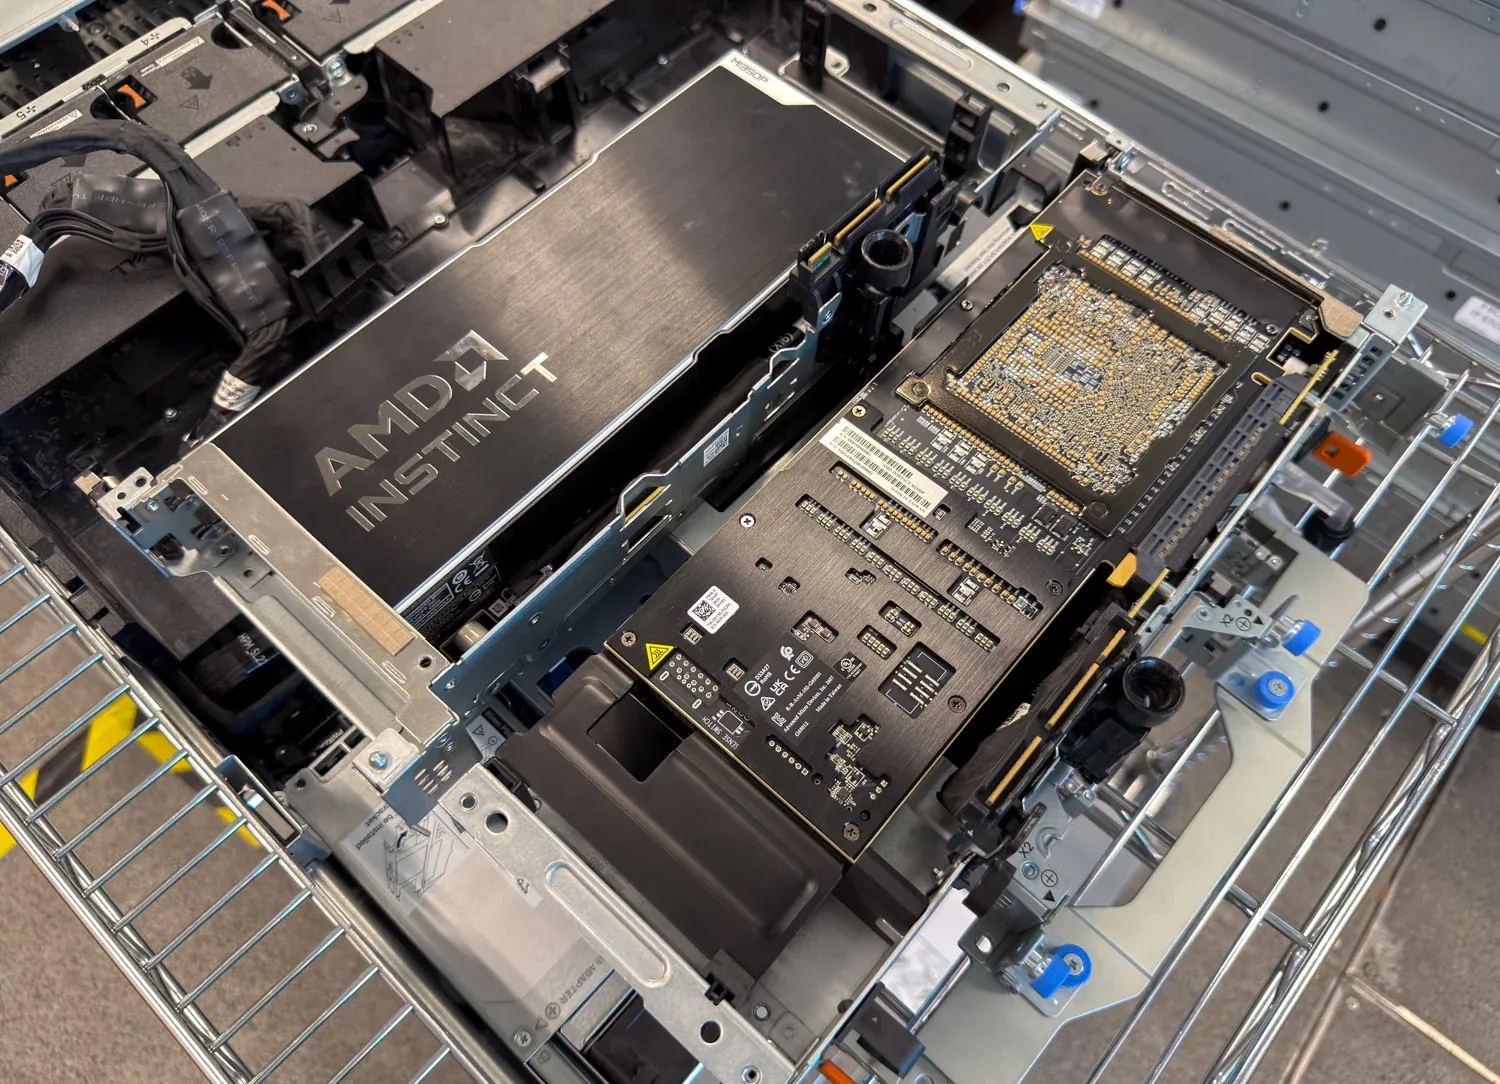
AMD 发布 Instinct MI350P:600W PCIe 卡搭载 144GB HBM3E
来源标题:AMD Instinct MI350P First Look: 144GB HBM3E in a 600W PCIe Card
AMD 推出四年来首款全新 PCIe 接口 Instinct GPU——MI350P,采用 CDNA 4 架构,配备 144GB HBM3E 和 4TB/s 带宽。该卡为双槽 600W 风冷设计,MXFP4 性能最高 4.6 PFLOPS,让客户无需采用更大的 OAM 平台即可部署 Instinct GPU。AMD 还在 IFA 2026 展示了搭载四块 MI350P 的 Threadripper Halo Station 原型机。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
AMD Instinct MI350P 是 AMD 四年来首款全新的 PCIe Instinct GPU,上一款是 2022 年的 MI210。它把公司的 CDNA 4 架构带到了常规的附加卡形态上,提供最高 4.6 PFLOPS 的 MXFP4 性能、144GB HBM3E 和 4TB/s 内存带宽。所有这些都塞进了一张双槽、600W 的风冷卡里,让客户在不必转向更大的 8 GPU OAM MI350/5X 平台的情况下,多了一种部署 Instinct GPU 的方式。
AMD 还在 IFA 2026 上通过其 Threadripper Halo Station 原型机展示了 MI350P,原型机中的同款加速器采用液冷。这一工作站概念最多支持四块 MI350P 搭配一颗 96 核 Threadripper PRO 处理器,单机可提供 576GB 的 HBM3E 总容量;AMD 在 10 月更新的产品页面现在将该系统列为 2027 年推出。这让我们可以从两个角度来看 MI350P:作为服务器的 PCIe 加速卡,以及作为更大尺寸桌面级 AI 系统的构建模块,与 GB300 DGX Station 这类机器竞争。
本次首测采用服务器视角,因此对要选型 PCIe 加速卡的买家来说,真正有意义的对比对象是 NVIDIA RTX PRO 6000 Blackwell——它处于相同的功耗级别、使用相同的插槽;而 H200 NVL 也出现在图表中,作为在内存带宽决定结果的工作负载上 NVIDIA 最强的附加卡。单台 GB300 DGX Station 则代表桌面级视角;它属于不同级别的机器、价格也不同,放在这里是为了展示一颗完整的 Blackwell Ultra GPU 比任何 PCIe 卡高出多少。
AMD 公布的数字把 MI350P 的重心放在低精度上:MXFP4 和 MXFP6 下 4.6 PFLOPS,FP8 下 2.3 PFLOPS,FP16 或 BF16 下 1.15 PFLOPS,全部为 dense 数值。内存系统是这张卡的另一半:144GB HBM3E,4096-bit 接口,4TB/s,背后是 128MB Infinity Cache,下文中的单流结果正依赖于此。板卡功耗为 600W,另有 450W 可配置模式;我们的评测样品运行在 450W。
MI350P 使用与更大、更高功耗的 MI350/5X GPU 相同的 CDNA 4 架构。可以把 MI350P 理解为实际上相当于半个 MI350X。要理解原因,有必要看看更大的 GPU 是如何组装的。
MI350X 是基于台积电 CoWoS(Chip-on-Wafer-on-Substrate)封装打造的 3D 堆叠 chiplet 设计,没有单一的单体 die。八个加速计算复合 die(XCD)位于两个 I/O die 之上,每个 I/O die 上方有四个 XCD。AMD 的 Infinity Fabric 连接各 chiplet,八组 HBM3E 堆栈提供 GPU 的内存。CoWoS 描述的是封装层面的集成;计算 die 叠在 I/O die 之上的布局则是该设计的垂直 3D 堆叠部分。
MI350P 取用了这一布局的一半:四个 XCD、一个 I/O die 和四组 HBM3E 堆栈。每个 XCD 有 32 个活跃计算单元,因此这张卡共有 128 个 CU,而 MI350X 为 256 个。内存资源同样减半:144GB HBM3E 对 288GB,4TB/s 带宽对 8TB/s,128MB Infinity Cache 对 256MB。
600W 是上限,AMD 允许将卡配置低至 450W,我们的 2U 主机中它就以该功耗运行。H200 NVL 在 R770 中同为 450W,但 RTX PRO 6000 在 XE7740 中以完整的 600W 运行,因此在与它的每次对比中,NVIDIA 这张卡都多出 150W 的功耗预算。满功耗的结果要等有能压制 600W 被动散热卡的机箱后再测,戴尔 XE7745 技术指南列出了八块 600W 的 MI350P。
另一点:单个 12V-2×6 供电接口和 10.5 英寸双槽板型,正是这一点让这张卡可以装入目前用于 RTX PRO 6000 或 H200 NVL 的同一批 riser。
下表将 MI350P 与我们图表中的三款 NVIDIA 系统并列:RTX PRO 6000 Blackwell Server Edition,它与 MI350P 共享插槽、功耗范围和 PCIe 5.0 x16 主机链路;H200 NVL,这款 Hopper 卡拥有与之匹敌的内存带宽;以及 GB300 DGX Station,一颗 Blackwell Ultra GPU 通过 NVLink-C2C 与 Grace CPU 配对。
首先该看的是内存容量——MI350P 的 144GB 是三款 PCIe 卡中最大的,比 H200 NVL 多 3GB,比 RTX PRO 6000 多 48GB;然后是内存带宽——其 4TB/s 介于两者之间;以及 FP4 一项——AMD 给出的是 dense 数值,NVIDIA 给出的是 sparse 数值。
与 RTX PRO 6000 相比,MI350P 的内存子系统是最直接的差异。它的 GPU 内存多 50%,内存带宽约为 2.5 倍。对于无法舒适地装进 96GB 的模型,额外的容量可能决定它是能跑在单块 GPU 上,还是需要分布到多块 GPU 上。
不过,RTX PRO 6000 服务的工作负载范围更广,除了 AI 能力外还有图形、光线追踪和视频硬件。这个选择权衡的不只是两个峰值算力数字,还取决于系统还需要做哪些其他事情。
在高内存 PCIe 加速卡中,H200 NVL 是 MI350P 更直接的对比对象;更大的 Blackwell 数据中心 GPU 属于另一个级别。内存容量几乎相同,144GB 对 H200 的 141GB,两者都使用 HBM3E,而 H200 的内存带宽高出 20%,达到 4.8TB/s。两者的扩展方式也不同:三款 PCIe 卡都通过 PCIe 连接主机,但 H200 NVL 通过 NVLink 桥接增加了专用的 GPU 到 GPU 连接,最多可连接四块 GPU。
更大的 MI350X 和 MI355X 是为对抗 Blackwell 而打造的,但 MI350P 将这套硬件配置砍半。这使它在内存属性和整体定位上更接近 H200 NVL。MI350P 仍然独树一帜的一点是原生支持 MXFP4 和 MXFP6,随着推理向更低精度迁移,这一点愈发重要。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。