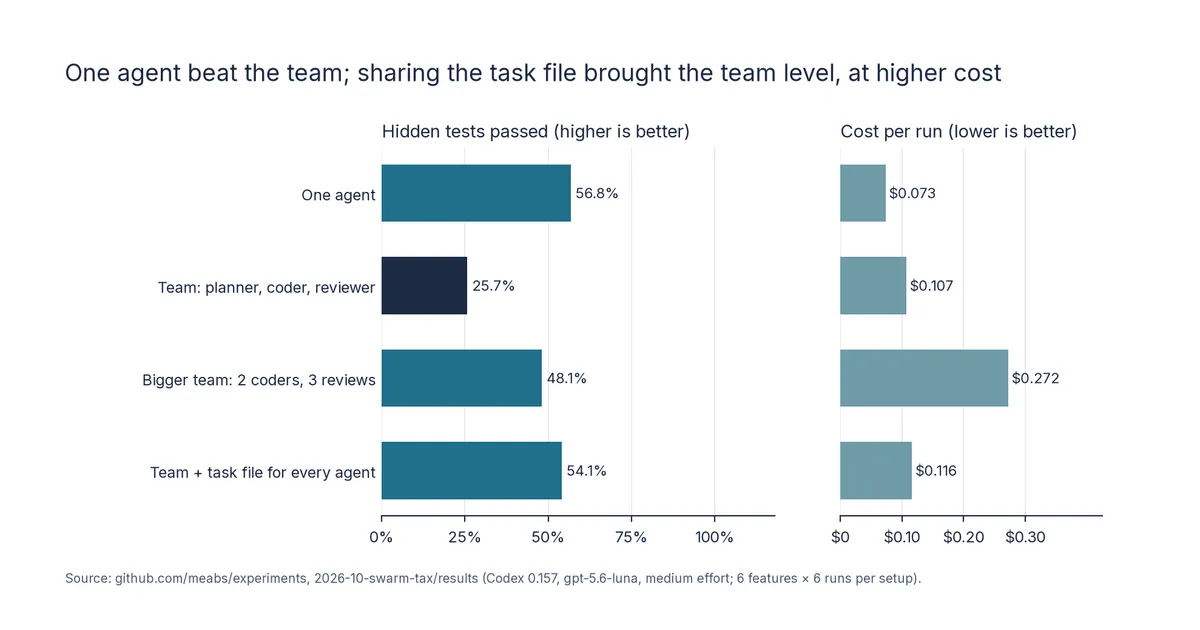
测试显示Codex单智能体通过率56.8%,规划-编码-审查团队仅25.7%
来源标题:Does a team of coding agents beat one agent?
在六项功能任务测试中,单个Codex智能体通过56.8%的隐藏验收测试,而由规划、编码和审查三个智能体组成的团队仅通过25.7%,且成本更高。原因是任务交接时只有规划者看到完整任务,其摘要丢失了细节。让每个智能体都能访问任务文件后,团队通过率升至54.1%,与单智能体持平,但成本仍约为其1.6倍。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
我给 Codex 布置了六个功能任务,分别让它单独完成,或以团队形式完成:一个规划者、一个编码者和一个审查者。单 agent 通过了 56.8% 的隐藏验收测试;团队只通过了 25.7%,而且成本更高。原因出在交接环节:只有规划者看到了任务,而它的总结丢失了细节。把任务文件交给每个 agent 后,团队追平了单 agent(54.1%),但成本仍然更高。
主题:评审、测量、安全与成本、并行
由规划者、编码者和审查者组成的团队,是否比单 agent 把功能做得更对?如果给单 agent 同样的预算,这种优势是否还在?
规划者–编码者–审查者团队通过了 25.7% 的隐藏验收测试;单 agent 独自通过了 56.8%,且花费更少
局限:单一模型、单一 effort 级别、单一 Java 代码库中的六个功能、团队指令由我编写
95% 区间:−40.8 个百分点到 −21.9 个百分点;任务内 bootstrap 95% CI;单侧置换检验(团队更好),Holm p 1.0
指标:通过的隐藏测试占比(越高越好),团队减单 agent,六个功能的均值
把任务文件交给每个团队成员后,团队通过的隐藏测试从 25.7% 提升到 54.1%,与单 agent 持平,成本约为其 1.6 倍
局限:在主结果之后、运行之前设计;比主运行晚几小时运行
95% 区间:+18.4 个百分点到 +38.2 个百分点;任务内 bootstrap 95% CI;单侧置换检验,Holm p < 0.0001
指标:通过的隐藏测试占比(越高越好),有任务文件的团队减团队
每次 agent 审查者批准一个改动,该改动都未通过隐藏验收测试:24 次批准,24 次失败
局限:隐藏测试比要求审查者检查的内容更严格;审查者被要求运行相关测试,但没有任何 agent 写过测试
指标:给出批准的最终审查数,以及其中未通过隐藏测试的改动数
多 agent 编码被宣传为单 agent 之后的下一步:规划者拆分工作,编码者编写,审查者检查。演示通常显示团队表现更好,但很少固定预算。团队花费的是相当于多个 agent 的 token,而单 agent 只用一个 agent 的量。
简版结论:在六个真实功能上,团队比单 agent 做得更差,而且成本更高。主要原因是交接。只有规划者看到了任务,编码者需要的细节在它的总结中丢失了。当每个 agent 都能自己读取任务时,团队追上了单 agent,但从未超过它。而 agent 审查者每次批准时,批准的都是有问题的代码。
在运行之前,我发布了设计和三个假设(README.md):
后续实验(给每个 agent 任务文件)是在主结果之后、运行之前设计的,带有自己的两个假设和预先固定的结果判读规则。
有任务文件的团队仍然会拆分工作:规划者规划并传递下去。唯一的变化是需求不会在途中丢失,就像人类团队中每个开发者仍然能读到工单一样。
任务:六个功能,每个都写成需求,并固定接口(网址、JSON 字段、状态码、规则):折扣码、数量价格阶梯、愿望清单、补货提醒、带审核的商品问答,以及购物车限制。每个功能有 13 到 16 个 agent 从未见过的隐藏验收测试,以及我编写的、能全部通过的参考实现。
评分:代码通过某功能隐藏测试的比例。越高越好:100% 表示功能按任务要求工作。每种设置每个功能 6 次运行:108 次运行,外加后续实验的 36 次。
发现 SWT-1 到 SWT-3 位于页面顶部。
按功能统计通过的隐藏测试占比(越高越好):
团队按指示行事。每次团队运行都启动了编码者和审查者,没有规划者编辑文件,并且在 36 次运行中有 34 次,规划者把审查者发现的问题发回进行一轮修复。但它构建的每个功能仍少于单 agent。
更大的团队在全部六个功能上都优于小团队(+22.4 个百分点),但在四个功能上仍低于单 agent,每次运行成本是 3.7 倍。
团队的代码能编译,但破坏了任务明确规定的接口。在一次商品问答运行中,公共列表返回的是普通数组,而任务要求的是 {"count": …, "items": […]};未知问题返回 400,而任务要求 404。在每个任务声明的字段名和状态码中,单 agent 的代码包含 84%,团队包含 63%。有四次运行中,审查者在其副本上级文件夹中搜索它从未获得的任务描述。
Codex 会加密存储 agent 之间的消息,所以我无法读取规划者传递了什么。于是我做了测试:同一个团队,任务也放在仓库中供每个 agent 读取。编码者和审查者在全部 36 次运行中都打开了它。团队从 25.7% 提升到 54.1%(+28.5 个百分点,95% 区间 +18.4 到 +38.2),弥补了约十分之九的差距。与单 agent 相比,差异为 −2.7 个百分点(−13.7 到 +8.2):没有可测量的差异。
每次 agent 审查者以“批准”结束时,改动都未通过隐藏测试:三种团队设置合计 24 次批准,24 次失败。主运行的 108 份最终报告中有 107 份说它们的检查已通过。其中 104 份未通过隐藏测试,通常只检查了代码能否编译。
在所有 144 次运行中,没有任何 agent 添加过一个测试,尽管每个任务都描述了测试可以固定下来的行为。这就是为什么“单 agent,把团队预算当作两次尝试”并不比单 agent 更好:每次尝试都能编译,而没有测试就无法区分好尝试和坏尝试。如果你能从两次尝试中选出更好的那个(这需要隐藏测试,因此只是上界),分数会升到 68.9%。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。