开发者分享 Air Context 代码搜索 RAG 系统的存储与检索经验
来源标题:Building a RAG Pipeline for Semantic Code Search: A Developer Diary and Field Notes
开发者撰文分享其构建并上线生产级代码搜索 RAG 系统 Air Context 六个月的经验,本篇聚焦存储与检索。团队需解决百万级向量的存储问题,让索引跟上 Git 变化,并在毫秒级返回按仓库、路径和用户权限过滤的检索结果。
以下正文由 AI 翻译自 JetBrains Blog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
第二部分:存储、搜索与 Agent 工具链
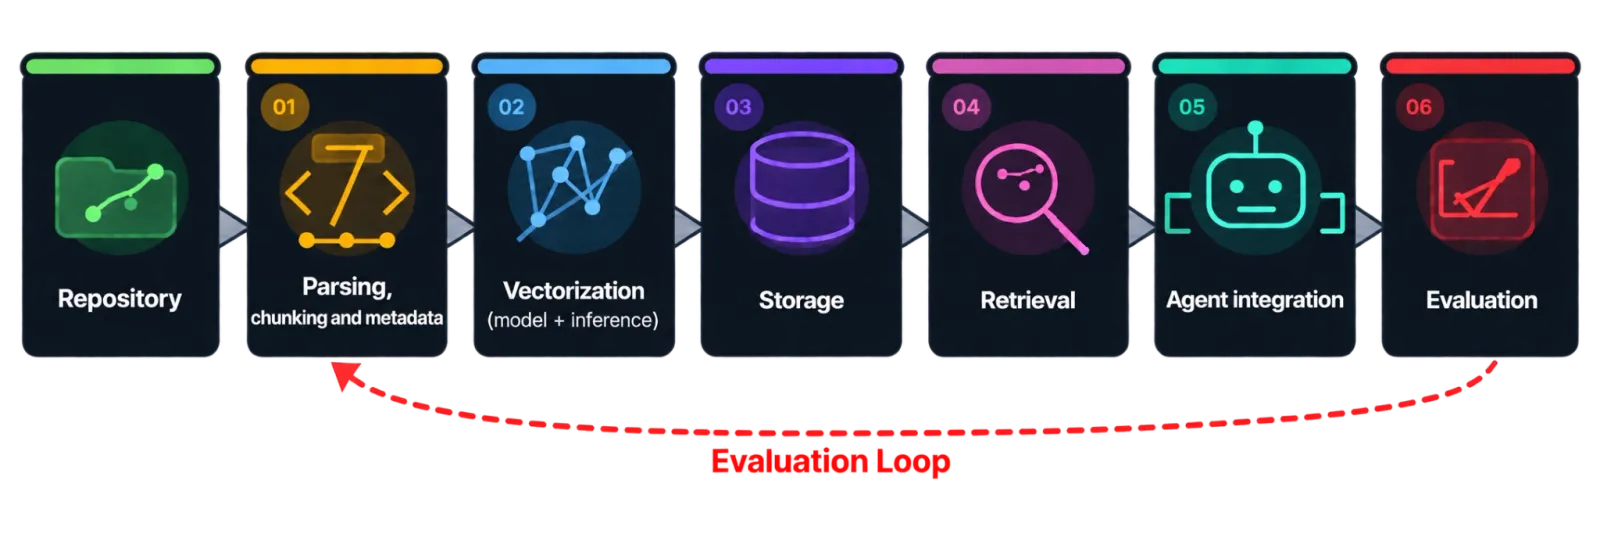
在本系列博客中,我们希望分享过去六个月里构建和部署 Air Context(一个面向代码搜索的生产级 RAG 系统)过程中积累的一些经验。系列的第一篇文章涵盖了分块、解析和向量化。然而,将代码转化为向量只是整个旅程的一部分。
在本文中,我们将讨论任何严肃的生产级 RAG 系统都必须解决的后续问题:如何存储数百万个向量,使索引能够跟上 Git 的变化,以及如何在毫秒级内检索到正确的向量。
存储
当我们完成代码的解析、分块和向量化之后,下一个问题是把这些向量放在哪里。一个真实的代码库可能产生数百万个向量。更麻烦的是,代码库不是静态的。它们不仅频繁变更、同时存在于数十个分支中,而且 Agent 期望在毫秒级内得到答案,并且结果要精确过滤到正确的仓库、正确的路径,以及仅限用户有权限查看的文件。所有这些都要求一个特殊的存储层,能够在给定约束下高效地处理搜索操作。
这个存储层的核心是向量索引。向量搜索需要找到与查询向量最接近的向量。逐一将查询与一百万个向量进行比较实在太慢,因此实践中我们使用近似最近邻(ANN)结构,例如 HNSW 或 IVF。这些结构跳过了大部分比较,返回的结果非常接近最佳匹配,但并不保证一定是最佳匹配。这种速度带来了权衡,涉及实际返回了多少真正相关的结果(也称为召回率)、索引需要多少内存、它应对持续不断的插入和删除的能力如何,以及它是否能够支持过滤。
除此之外,任何健康的代码库都必须支持随着提交落地而进行的多次增量索引更新。为了确保这能在大规模下实现,设计必须避免为共享相同代码的每个分支保留每个 chunk 的独立副本,并且必须保持向量及其描述元数据的一致性。这些能力都不是 embedding 模型所能提供的。没有强大的存储方案,我们辛苦提取的向量根本无法使用。
近似搜索的角色
近似搜索算法牺牲了一定的召回率,但在大规模数据集上运行良好。
我们发现,一种混合方法效果非常好——在初始 ANN 搜索之后,再在一个更有限的向量空间上执行精确搜索。
换句话说,用一次低成本的第一轮搜索将整个语料库缩小到一小群可能的候选者,然后再运行精确比较就变得可以承受了。近似索引负责规模,精确搜索负责最后一公里的精度。这为我们提供了另一个微调搜索的杠杆,因为我们思考的不仅是用什么算法,还包括如何将它们串联使用。
带过滤的 ANN:细节与难点
用于语义相似度的向量搜索对更严格的搜索约束是盲目的,例如将结果限制在某个仓库、分支或特定子文件夹内。此外,安全和权限约束(例如对可查询数据类型的限制)必须被严格执行。这类元数据过滤需要一个确定性的机制,且该机制要优先于任何搜索算法。
将过滤器与 ANN 索引结合确实很难,因为这两种机制会相互冲突。HNSW 图的构建假设你可以在邻居之间自由遍历;一旦你将遍历限制在满足谓词的节点上,图可能变得不连通,游走可能错过有效的候选者。有三种主要策略来应对这个问题:
-
预过滤。这意味着先应用元数据谓词,然后只搜索存活下来的集合。相对于过滤器而言,它提供了 100% 的召回率。然而,它失去了过滤子集上的 ANN 索引,实际上退化为精确搜索。这种策略最适合高度具体的过滤器,例如单个小仓库或狭窄的子文件夹。但当过滤器仍然留下大量待搜索的数据时,成本会变得很高。
-
元数据与向量索引捆绑。最强大的通用方法是一种让过滤成为索引本身一等公民的存储方案。换句话说,文件夹权限或仓库等参数是可搜索的,并且会影响向量距离。Qdrant 和 turbopuffer 就是这样构建的。你保留了 ANN 的大部分速度,同时遵守了过滤器,而无需回退到暴力搜索。对于具有真实 ACL 要求的生产级代码库 RAG 来说,这是一个均衡的选择。
-
后过滤。先运行 ANN 搜索,然后丢弃不满足谓词的结果。问题当然在于,由于 top-K 候选者并非在考虑此过滤器的情况下选出的,大多数或全部候选者可能最终都是无效的,留给你一个短小且质量低劣的列表。pgvector 的迭代扫描模式通过获取越来越多的候选者直到足够多的结果通过过滤器来缓解这个问题,但这会带来延迟成本,且可能不可预测。后过滤被认为是三种策略中最弱的一种。
跟上增量代码变更
在处理大型代码仓库时,RAG 系统无法承受在每次变更时重新索引整个代码库。因此,为了实现可接受的索引性能和数据存储限制,索引必须增量执行。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。