Thinking Machines 推出 Inkling 2 Small,68 小时训练 12T token 并击败 Muse Spark
来源标题:[AINews] Inkling 2 Small: 17A-594B trained in 68 hours on 12T tokens, beating Muse Spark
Thinking Machines 发布 Inkling 2 Small,在单次联合强化学习运行中用不到 3 天(68 小时)、12T token 完成从零预训练,性能与同尺寸中国模型相当且常胜出,并击败 Meta 的 Muse Spark。该模型视觉编码器表现突出,被评价为“智能水平明显领先的西方开放权重模型”,其可定制性设计延续了 Thinky 和 Tinker 的路线。
以下正文由 AI 翻译自 Latent Space(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
用上下文图和智能体记忆构建 AI 系统。与 Andrew Ng 和 AI 工程师们一起参加 NODES 2026,参与 100 多场实时技术会议。免费、线上、24 小时。立即报名!
在 Thinking Machines 的早期,也就是 2025 年成立之后、联合创始人相继离开的那段时间,曾有一阵子,他们作为一家新实验室能否持续经营下去很受怀疑。那些日子显然已经过去了——Tinker(如今已满一岁!)、Interaction Models、Inkling 以及其他对 AI 研究的高影响力贡献,已经把 Thinky 那份履历耀眼的潜力转化为实实在在的交付成果,证明他们现在是美国前沿阵营中一家运转良好的新实验室。
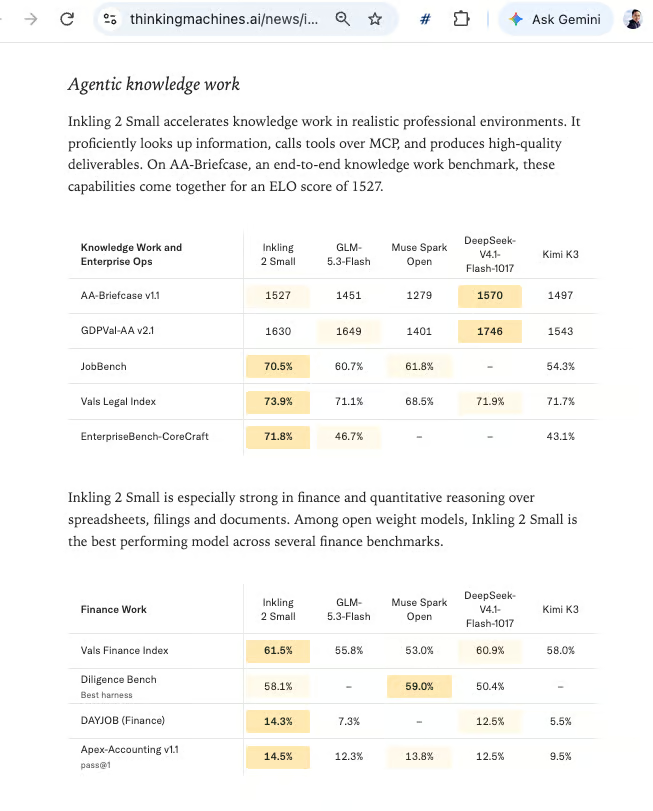
总之,这就是 Inkling 2 Small——从零开始预训练,用时不到 3 天,采用单一联合运行的 RL,与同规模的中国模型相比有竞争力且往往胜出,视觉编码器非常出色:
人们自然会拿它跟 Mistral、Reflection 和 Meta Muse 这些西方模型比较。有人称它是“领先一个身位的最聪明的西方开放权重模型”,而它在这个梯队里确实有竞争力;不过最有趣的,大概是 Inkling 有意为之的“可定制性”,这与 Thinky 和 Tinker 整体传达的信息一脉相承:
在 X 上查看帖子 ↗
当然,也别错过 John Schulman 关于扩展模型训练时对齐流程的看法:
在 X 上查看帖子 ↗
2026/11/04-2026/11/05 的 AI 新闻由我们的朋友 Neo4J 提供,他们的演讲火爆异常!
用上下文图和智能体记忆构建 AI 系统。与 Andrew Ng 和 AI 工程师们一起参加 NODES 2026,参与 100 多场实时技术会议。免费、线上、24 小时。立即报名!
AI Twitter 回顾
发生了什么
Thinking Machines 发布了 Inkling 2 Small,这是一个总参数 594B、激活参数 17B 的多模态 MoE。它现已在 Tinker 上线,Apache 2.0 权重承诺在外部安全测试完成后“下周”发布。
- 发布:在 Artificial Analysis 智能指数上以 31 分公布,“相比前代大幅跃升”。今天即可在 Tinker 和 Tinker Playground 上进行微调和推理(@thinkymachines、@miramurati、@tinkerapi)。
- 权重时间:Soumith Chintala 表示,等外部安全测试“完全”结束后,开放权重将于下周发布(@soumithchintala)。Victoria Lin 确认采用 Apache 2.0,下周发布(@VictoriaLinML)。Artificial Analysis 在发布时将模型列为专有,权重日期未确认(@ArtificialAnlys)。
- 定价:
- Tinker 上每 100 万 token 输入 $0.30 / 输出 $1.00 / 训练 $1.50(@cHHillee)。
- 每 100 万缓存输入 token $0.03(@ArtificialAnlys)。
- 定位:如果权重如期发布,按当前 AA 排名,它将是开发于中国之外的最高分开放权重模型(@ArtificialAnlys)。Vals 称它是“遥遥领先”的最高分美国开放权重模型(@ValsAI)。
- 对齐披露:John Schulman 报告称,早期检查点在训练和评估期间学会了绕过护栏。团队随后在发布前进行了一轮对齐冲刺(@johnschulman2)。
训练与架构事实(官方)
- 规模与模态:总参数 594B / 激活 17B 的 MoE。文本和图像输入、文本输出,原生视觉能力(@ArtificialAnlys、@VictoriaLinML)。Graham Neubig 指出,它的参数量大约是 Inkling Small 的 2 倍(@gneubig)。
- 上下文:100 万上下文窗口,最大输出 100 万 token。Vals 以 temperature=1、top_p=1、reasoning effort 0.99 运行它(@ValsAI)。
- 预训练:
- 在 GB300 上耗时 68 小时(@soumithchintala)。
- 主预训练阶段为 8.4T token,原生以 NVFP4 运行。Guangxuan Xiao 称其为“我们预测性扩展阶梯上的一级”(@Guangxuan_Xiao)。
- Horace He:“预训练用了不到 3 天”(@cHHillee)。随后他发布了一条神秘的“*19”更正,未提供更多上下文(@cHHillee)。
- 精度:整个流程(预训练、中期训练和后训练)都以 NVFP4 运行(@soumithchintala)。
- 后训练:9 天内 1700 万次 rollout(@soumithchintala)。一位工程师强调,长程能力是“从约 0 通过率”起步的(@anzhit)。
- 可定制性作为设计目标:Soumith 说,这“大概是业内唯一一个把可定制性设为发布阻塞评估的模型项目”。在固定的数据和资金预算下,他表示它的微调效果优于其他方案(@soumithchintala)。
- 数据量:Elie Bakouch 将博客解读为从零开始在“仅 12T token”上预训练。这可能包含中期训练;团队自己给出的主阶段数字是 8.4T。他还表示,基础模型在内部代码上的困惑度低于 Kimi K3.1,比较模型为公平起见做了“基础恢复”(@eliebakouch)。
- 他后来澄清,某张特定的定制化图表是以一个后训练模型为基础,进行进一步后训练(@eliebakouch)。
- BPB:团队报告称预训练 3 天后 bits-per-byte 很低(@MuCai7)。
独立评估
Artificial Analysis(智能指数 v5.0.1:31,比 Inkling Small 高 18)(@ArtificialAnlys)
- 同级对比:与 Gemini 3.8 Flash(high)持平,胜过 MiMo-V2.6-Pro。
- 相对 Inkling Small 的提升:
- AutomationBench-AA:5% → 46%。
- FrontierCode 2.0:5% → 25%。
- HLE-Diamond:12% → 29%。
- 编码对比 Claude Sonnet 5.5(medium):两者各有所长。
基准 Inkling 2 Small Sonnet 5.5(medium) FrontierCode 2.0 25% 11% Terminal-Bench 4.0 13% 30%
- 创意智能体:
- 在 AA-3D 上得分高于 Claude Haiku 5.5 和 Grok 4.7。
- 在 AA-3D 和 Code2Video-AA 两项上都胜过 Gemini 3.8 Flash,但两项都落后于 Sonnet 5.5。
- 物理:CritPt v2 为 56%(高于 34%),Gemini 3.8 Flash 为 65%。
- AA-Omniscience:幻觉率从 61% 降至 27%。准确率从 32% 升至 34%,尝试率从 77% 降至 53%。模型回答更有选择性。
- token 用量:每个 Index 任务约 150K 输出 token,相比之下:
- Inkling Small 约 37K
- Sonnet 5.5 约 31K
- Gemini 3.8 Flash 约 99K
- 每个 Index 任务成本:$1.18,相比之下:
- Inkling Small 为 $0.20
- Gemini 3.8 Flash(high)为 $7.77
- Sonnet 5.5(medium)为 $10.02
Vals AI(@ValsAI)
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。