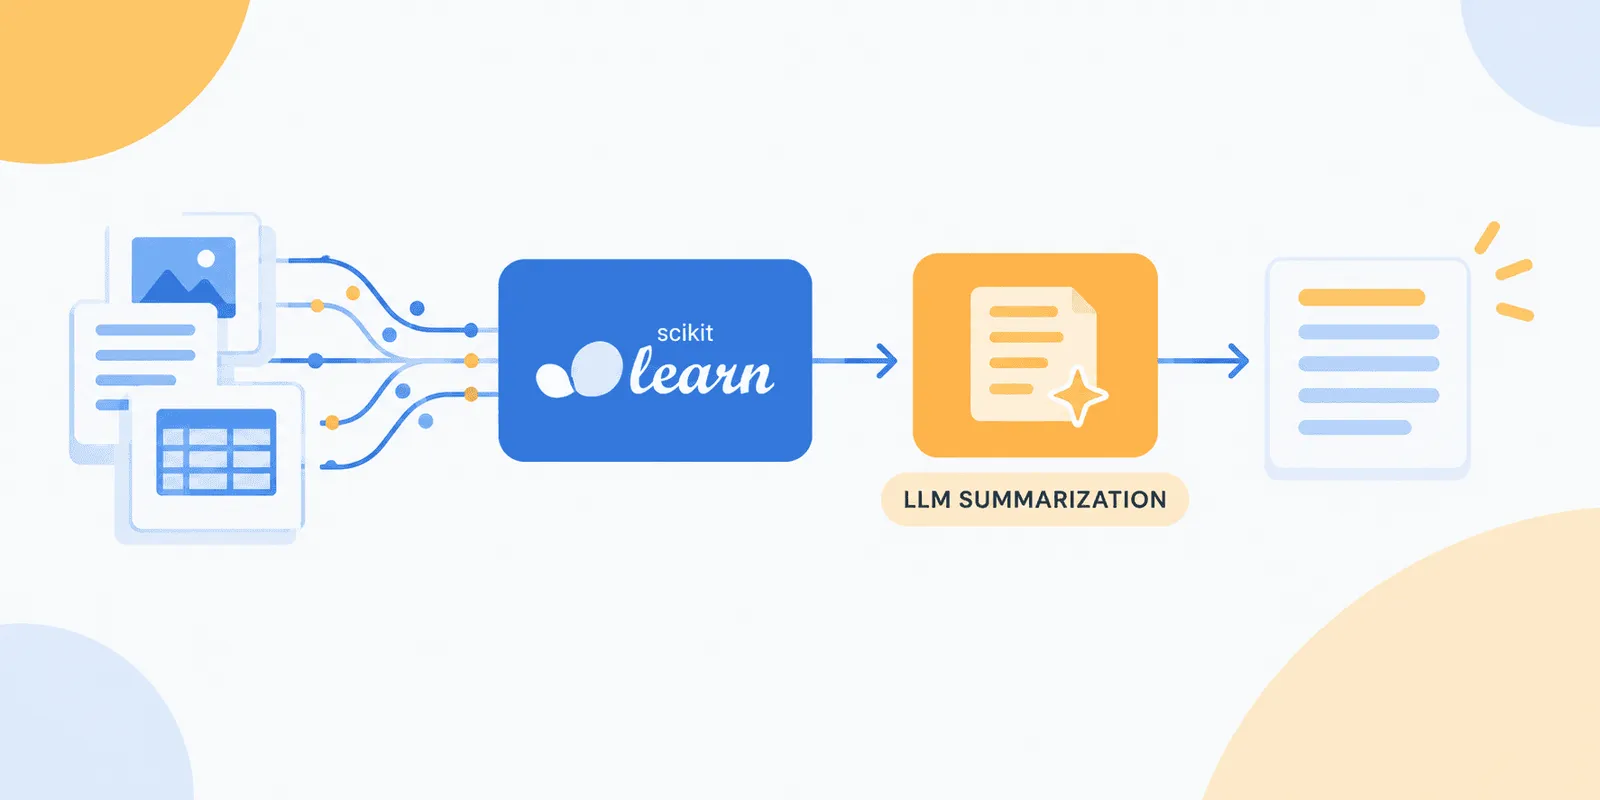
教程:用 Scikit-LLM 将大模型摘要功能接入 scikit-learn 流水线
来源标题:Using LLM Summarization in Your Scikit-Learn Pipelines with Scikit-LLM
一篇教程演示如何把 Scikit-LLM 的文本摘要估计器与 scikit-learn 传统方法整合进同一条流水线,先由 LLM 摘要原始杂乱文本再交给分类模型。示例可在 Google Colab 中完整运行,并使用 Groq 的免费模型 API,需自行注册获取 API key。
以下正文由 AI 翻译自 KDnuggets(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在使用传统的轻量级机器学习分类器处理文本时,通常需要先把冗长、往往嘈杂的原始文本浓缩成干净信号才能取得好效果。因此,把大语言模型(LLM)用于文本摘要、作为预处理阶段先把更干净的文本交给下游分类模型,这种想法并不离谱。如果我们能把这套流程无缝地作为传统、基于 scikit-learn 的 pipeline 的一部分来做,让 LLM 驱动的摘要与传统的数据预处理、训练和推理共存,会怎样?如果我们还能完全只用免费工具做到这一切,又会怎样?不用再找了。
在本文中,我们将学习如何构建一种架构,把用于文本摘要的 Scikit-LLM 估计器与传统的 scikit-learn 方法融合到单一、统一的 pipeline 中,对原始、杂乱的文本进行摘要和分类,兼取两者之长:LLM 与经典机器学习模型。
这个示例可以完全在 Google Colab notebook 中运行。它使用 Groq 的 LLM API,从而完全依赖免费模型。前提是访问 Groq 网站、注册并生成你自己的 API key。生成之后,小心复制你的 API key(它只显示一次),并把它作为新的“Secret”变量粘贴到 Google Colab 中,位置在 Colab 左侧的钥匙图标处。把这个 secret 变量命名为 GROQ_API_KEY。
之后,我们通过安装 Scikit-LLM 来开始 notebook: !pip install scikit-llm -q
现在进入 Python 代码。第一步是配置 Scikit-LLM 周围的环境,把我们的请求改为经由 Groq 的 API 路由,而不是默认的 OpenAI API。这将帮助我们利用 Groq 免费、友好且高效的预训练模型,绕过按 token 计费的成本。 from google.colab import userdata from skllm.config import SKLLMConfig
Retrieving API key and routing to Groq's free-tier OpenAI-compatible endpoint
groq_key = userdata.get('GROQ_API_KEY') SKLLMConfig.set_gpt_url("https://api.groq.com/openai/v1") SKLLMConfig.set_openai_key(groq_key)
接下来,我们定义“训练”数据。它由一小组初始文档及其对应标签组成。这些文档故意写得冗长、有些嘈杂且啰嗦,就像许多真实场景中那样。如果不先做摘要从文本中提取相关信号,直接从这些文本获得数值化、机器学习友好的表示,不可避免地会传播噪声:
Raw, lengthy documents and their corresponding class labels
X_long_texts = [ "The new solar panel technology efficiency has increased by 15% due to the novel perovskite layer, significantly lowering the barrier to entry for residential use and driving green energy adoption by making installations cheaper and faster than ever before.", "Financial markets saw a sharp downturn today following the central bank's unexpected interest rate hike, leading to massive sell-offs in the tech sector and triggering volatility indices to reach their highest points in over three years.", "The clinical trial for the new arthritis medication showed promising results, reducing joint swelling by 40% in the control group without severe side effects, awaiting FDA approval which could bring relief to millions suffering from autoimmune disorders." ] y_labels = ["Energy", "Finance", "Healthcare"]
与 few-shot 分类类似,我们只需要一小套有代表性的训练示例,就能让我们稍后加载的 LLM 知道如何进行推理。LLM 本身并不会发生真正的训练。
下一步可以说是最关键的一步:我们定义由 LLM 驱动的摘要作为前置、机器学习驱动的分类组成的三步 pipeline,从而将 Scikit-LLM 在预训练 LLM 上适配特定任务的能力整合进更广泛的机器学习 pipeline。下面的代码使用一个 GPTSummarizer 对象来封装一个兼容 Groq 的摘要模型,即 openai/gpt-oss-20b。然后它把摘要步骤嵌入 scikit-learn pipeline,随后用词频-逆文档频率(TF-IDF)获得摘要文本的文本表示,而不是原始的长文本。最后,它使用之前定义的标签集定义并训练一个逻辑回归分类器。 from sklearn.pipeline import Pipeline from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.linear_model import LogisticRegression from skllm.models.gpt.text2text.summarization import GPTSummarizer
THREE-STEP MACHINE LEARNING PIPELINE FOR TEXT CLASSIFICATION, PRECEDED BY SUMMARIZATION
1. Summarizer: Condenses long documents using the compatible model on Groq
2. Vectorizer: Converts the concise summaries into numerical TF-IDF vectors
3. Classifier: Learns to classify the TF-IDF vectors using standard Logistic Regression
text_pipeline = Pipeline([ ('summarizer', GPTSummarizer( model="custom_url::openai/gpt-oss-20b", max_words=20 )), ('vectorizer', TfidfVectorizer()), ('classifier', LogisticRegression()) ])
Fitting the entire pipeline end-to-end
text_pipeline.fit(X_long_texts, y_labels)
你可能会想,X_long_texts 中只有三个训练实例,怎么足以训练最后阶段的逻辑回归分类器。这并不是因为分类器真正学会了“Energy”“Finance”和“Healthcare”这些宽泛概念。相反,它之所以成功,是因为两种 pipeline 机制协同工作:LLM 首先充当精确的过滤器,把嘈杂文本浓缩成“规范”关键词。之后,下游的向量器自然将其整个词表限制为剩下的那几个词,从而把分类任务变成一个相当简单、基本是微不足道的关键词匹配游戏。
接下来,我们查看为三个训练示例生成的摘要,以验证它们是否合理:
Inspecting the summaries of "training" examples, accessing the 'summarizer' object
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。