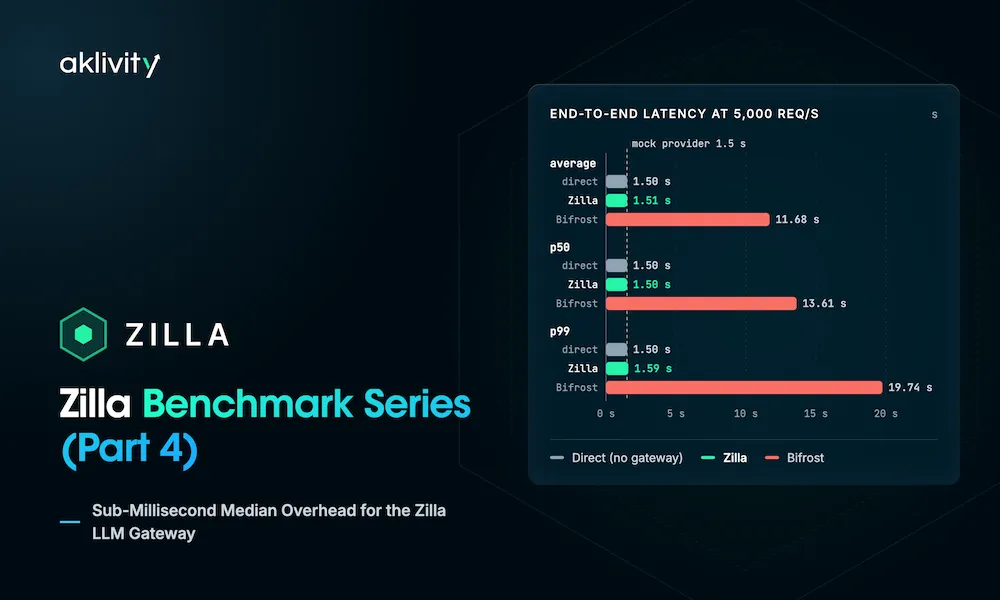
Zilla 开源 LLM 网关实测:5000 请求/秒下中位开销 0.27 毫秒
来源标题:Open-Source LLM Gateway with Sub-Millisecond Median Overhead
Aklivity 在 5000 请求/秒场景下测试了 Zilla 作为 LLM 网关,所有请求均得到响应,中位请求开销为 0.27 毫秒,其中模型路由仅耗时 17 微秒。测试使用开源 LLM 网关基准测试仓库的负载生成器和模拟提供商,运行在 AWS 同一可用区的三台实例上。网关仅由三个绑定组成:接收 OpenAI 请求、按模型路由、转发至兼容 OpenAI 的上游提供商。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在每秒 5,000 个请求的负载下,Zilla 响应了每一个请求,中位请求耗时 0.27 ms,其中模型路由耗时 17 µs。 本系列的第 1 部分、第 2 部分和第 3 部分测量了位于 Apache Kafka 前面的 Aklivity Zilla。 本文测量 Zilla 作为 LLM 网关的表现。客户端向 Zilla 发送 OpenAI 兼容的 chat completion 请求,Zilla 按模型将这些请求路由到上游提供商。 我们使用一个开源 LLM 网关基准测试仓库中的负载生成器和 mock 提供商,运行了每秒 5,000 个请求的场景。 所有运行都使用 maximhq/bifrost-benchmarking 的 Aklivity fork。该 fork 为负载生成器和 mock 提供商增加了 Zilla Gateway 和 HTTP/2 明文支持。 每次运行都在同一个 AWS 可用区中使用三台同类型实例,通过私有 IP 连接: 对于直连基线,网关实例保持空闲,负载生成器通过相同的协议和连接直接向 mock 提供商发送请求。 完整配置位于基准测试仓库中的 zilla/zilla.yaml。 LLM 网关本身由三个 binding 组成:一个接收 OpenAI 请求,一个按模型路由请求,一个将请求发送给 OpenAI 兼容的提供商: north_llm_server: type: llm kind: server options: dialect: openai exit: north_llm_proxy north_llm_proxy: type: llm kind: proxy routes:
- when:
- model: [ "gpt-*" ] exit: south_llm_client_openai south_llm_client_openai: type: llm kind: client options: dialect: openai server: ${{env.MOCKER_URL}} exit: south_http_client 要将另一个模型路由到不同的提供商,只需增加一条 route 和一个 client binding。 两次运行都使用 c7i.xlarge 实例、HTTP/2 明文和 0.36 KB 响应,负载生成器使用四个连接。 图表显示了 p50、p99 和最大端到端延迟,其中包括 mock 提供商的 1,500 ms。 在没有网关的情况下,负载生成器、mock 提供商和网络在 mock 提供商的 1,500 ms 之上增加了 0.9 ms 的 p50 和 2.5 ms 的 p99。通过 Zilla 时,相同负载在直连基线之上测得的 p50 增加了 1.0 ms,p99 增加了 85 ms。 该端到端差异包括额外的一跳网络以及 Zilla 的两条连接。下面的分解直接测量了 Zilla 内部的时间。 Zilla 配置是一条 binding 链,每个 binding 处理请求的一个阶段,例如 HTTP、OpenAI 解析或路由。Zilla 在其 engine directory 中记录所有在 binding 之间传递的消息:内存映射的环形缓冲区,每个 engine worker 一个。 中位请求在 Zilla 内部耗时 0.27 ms。 在其 1,502 ms 的端到端时间中,mock 提供商和网络占用了 1,501.0 ms。请求路径从请求体到达时开始计算,即请求流之后 99 µs,响应路径从提供商的最后一个字节开始计算。 所有计时均针对 0.36 KB 响应;更大的响应需要更长的解析、重新编码和发送时间。 *OpenAI server、模型路由器和 OpenAI client:提供商之前 33 µs,之后 45 µs。不包括任何网关都需要的 HTTP/2 解码和编码以及网络写入。仅路由(按模型路由加上经路由器返回)耗时 17 µs。 这里使用的基准测试仓库是 Bifrost 的仓库,Bifrost 发布了针对相同每秒 5,000 请求场景的 t3.xlarge 基准测试。 已发布的页面没有说明 Bifrost 版本、测试持续时间、负载生成器和 mock 提供商运行的位置,也没有说明并发设置。其 1.50 s 的 HTTP 请求时间与我们的 mock 提供商的 1,500 ms 延迟相符。 我们在与 Zilla 相同的三主机布局和工作负载上运行了 Bifrost: 结果并排展示,每列注明实例类型和协议。三者都使用 0.36 KB 响应: 我们使用已发布的 pool 和 buffer 大小以及仓库默认的 0.36 KB 响应运行了 Bifrost v2.3.2,小于已发布的 10.32 KB。 平均延迟为 11.7 s,而已发布的数据为 1.61 s;峰值内存为 7.6 GB,而已发布的数据为 3,340 MB。由于每个请求耗时如此之长,负载生成器不得不同时保持多得多的请求处于打开状态,并且在测量窗口内应完成的 150,000 个请求中只发送了 106,679 个。 我们最初使用 HTTP/1.1,即基准测试仓库的负载生成器和 mock 提供商所使用的协议,然后将 Zilla 两侧都改为 HTTP/2 明文。 因此,上面的 Zilla 和 Bifrost 结果并非基于相同的 HTTP 版本。 为了在相同协议上进行比较,我们还在两侧使用 HTTP/1.1 运行了 Zilla,在 c7i.xlarge 上使用相同的工作负载,上游 HTTP client 设置为 versions: [ http/1.1 ],worker capacity 提高到 16,384,engine directory 位于 tmpfs)。Bifrost 如上所述在 t3.xlarge 上运行。 在 HTTP/1.1 上,Zilla 的 p99 比 Bifrost 低约 8 倍。只有 Zilla 的运行是干净的: 有两个设置让 Zilla 能够在 HTTP/1.1 上承载此负载所需的大约 22,000 个连接: 通过这两项设置,Zilla 平均使用 400% CPU 中的 263%,峰值内存为 6.3 GB。 在 HTTP/2 上,Zilla 不需要这两项设置:它使用默认设置、通过四个客户端连接,以相同的速率响应了全部 150,000 个请求。 Zilla 和 Bifrost 都接受 OpenAI chat completions 和 Anthropic messages,并在提供商使用另一种方言时转换请求。上述运行将 OpenAI 请求发送给 OpenAI 提供商。为了覆盖转换场景,我们使用 JSON 响应运行了所有四种客户端和提供商组合: 所有运行都响应了发送的每一个请求。CPU 是网关进程的 CPU 占用,在 4 vCPU 主机上总共有 400%。 大多数 LLM 流量是流式的。聊天界面和编码代理会在文本到达时显示文本,因此首个事件的时间就是用户感受到的延迟,网关每延迟一个事件都会增加这种延迟。流式响应还会在整个响应期间保持请求打开,因此网关承载的进行中工作比单个 JSON 回复更多。 为了测量流式传输,我们使用流式响应重复了跨方言运行: Zilla 的流在 p99 下于 2.1 s 内完成,而 Bifrost 的流最长耗时 9.3 s。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。