AI爬虫机器人涌入大学图书馆,威胁公共访问
来源标题:University libraries are being swarmed by AI bots, putting public access at risk
全球多所大学图书馆的在线资源正被大量AI数据抓取机器人冲击,导致网站变慢甚至崩溃。圣何塞州立大学的Jill Strykowski表示,这些机器人不断涌入,试图尽可能多地抓取资料。图书馆的学术、历史和政府文档等馆藏正因此被挤占,影响学生、研究人员和公众的正常访问。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
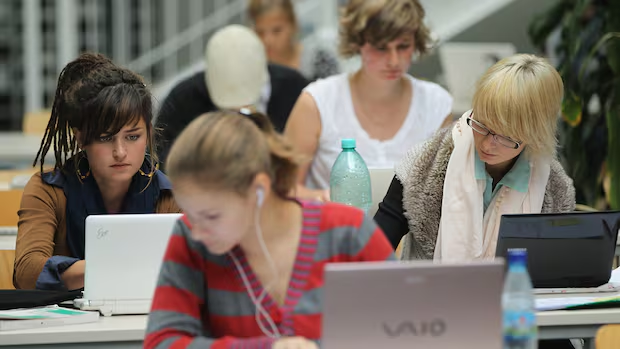
收听本文 预计时长 6 分钟 本文音频版本由基于 AI 的技术生成,可能会出现发音错误。我们正与合作伙伴共同持续审核并改进生成结果。 2011 年 9 月 20 日,学生们在柏林自由大学教育学图书馆使用笔记本电脑学习。全球各地学术图书馆的在线资源正日益受到搜寻内容的 AI 机器人干扰。(Sean Gallup/Getty Images) 社交分享 学术图书馆正在抵御成群的数据抓取机器人——这些机器人导致面向学生、研究者和公众的网站变慢甚至崩溃——与此同时,AI 公司仍在持续搜寻内容来训练其大语言模型。 大学图书馆表示,大量不受约束的机器人持续尝试访问其馆藏档案,导致整个馆藏资源间歇性下线,这些档案包括学术、历史和政府文件。 “它们就在互联网上四处活动,不断对我们发起请求,试图尽可能多地抓取资料,”圣何塞州立大学编目与政府文件负责人 Jill Strykowski 在接受 CBC News 采访时表示。 这些机器人被 AI 公司和第三方公司用来扫描网站并获取数据,通常用于训练 Claude、Gemini 和 ChatGPT 等 LLM。 图书馆、博物馆及其他文化遗产机构之所以成为主要目标,是因为它们拥有经过审核的高质量信息,而且这些信息通常并未藏在付费墙或登录验证之后。 Strykowski 表示,这些机器人“给每一家从事数字化工作的机构、每一家试图让信息开放获取的机构,都带来了大量额外工作和头疼问题”。 研究人员发现,此类报告从 2024 年末开始在北美洲、欧洲和大洋洲陆续出现,专家告诉 CBC News,这一问题还在持续恶化。 《星期日杂志》23:41 探寻全球竞相开发可能杀死我们所有人的 AI 的内幕 不列颠哥伦比亚省维多利亚大学图书馆馆藏与数字基础设施主任 Dean Seeman 表示,新的挑战还在不断出现。 “有时候机器人流量严重到会让网站完全宕机一段时间,”他说。 Seeman 表示,这给公众访问带来了“真正的问题”。 安大略理工大学可信人工智能加拿大研究主席 Peter Lewis 表示,如今普通用户使用图书馆网站时,实际上是在与来自机器人农场的无限流量竞争。 “这是又一个例子,说明大型私营公司在以一种非常掠夺性的方式利用公益性质的公共利益机构,想当然地认为这些资料可以免费获取——然后利用这些资料来构建高度商业化的模型,再反过来卖给公众,”他说。 2022 年 3 月 24 日,在内罗毕 Eastland 图书馆的一次数字化作业中,工作人员正在录入麦克米伦纪念图书馆一份旧文件的数据。图书馆及其他文化遗产机构是 AI 机器人的主要目标。(Patrick Meinhardt/AFP/Getty Images) Project Gutenberg 是一家总部位于美国的志愿者组织,致力于数字化和存档文化作品并分发电子书。其执行主任 Eric Hellman 去年在博客中写道,这些机器人——他称之为编程拙劣的“怪物”——正在“摧毁”互联网上的“开放获取”。 他告诉 CBC News,自那篇博客发表以来,“一切都变得更糟了”。 Hellman 表示,问题归结为良性机器人和恶意机器人。 他解释说,Google 等搜索引擎和 Internet Archive 等存档网站使用的机器人会遵守 robots.txt——这是网站上的自愿性指令集,告诉机器人哪些可以做、哪些不可以做,以便它们在收集信息时不干扰网站运行。 而 AI 抓取机器人有时会无视这些规则,使网站不堪重负——在某些情况下每秒请求数千份文档,并以所有可用格式下载。 这是学习人工智能的年轻人正在思考的问题——在 AI 的未来占据头条之际 9 月 14 日|时长 隐藏字幕 2:16 AI 的发展,以及公司和开发者对该技术未来的警告,再次成为头条新闻。但在温莎,有一些年轻人正在学习这项技术。CBC 的 Jacob Barker 采访了他们,听取他们的看法。 例如,北卡罗来纳大学教堂山分校去年报告称,同一天收到了来自数千个不同 IP 地址的超过 11,000 次芬兰音乐搜索请求。该校表示,由于机器人流量,其图书馆目录会定期将学生、教职员工拒之门外。 而且,由于一家公司或一个机器人农场可以从数千个 IP 地址发起操作,Hellman 表示,过去那种封锁问题 IP 的老办法已经不再有用。 Michael Weinberg 是 GLAM-E 的联合主任,该合作项目专注于文化机构的开放获取政策,他正致力于保护公众的信息获取权。(Michael Weinberg 提供) 他表示,Project Gutenberg 乐于让其资料被用作 AI 训练数据,甚至提供一键下载其全部图书馆藏书的功能,“但那些机器人太笨了,不会用。” “我们的资料几乎全部属于公有领域,正是它们应该用来训练的那类资料,”他说。“我们只是希望它们能以尊重他人的方式进行,不要把网站搞垮。” 一些图书馆已经设置了 CAPTCHA 验证或其他验证系统来筛除机器人。 问题在于,这些措施也可能把良性机器人一并筛除,Michael Weinberg 表示。他是 GLAM-E 的联合主任,该学术合作项目由纽约大学法学院和华威大学共同发起,专注于文化机构的开放获取政策。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。