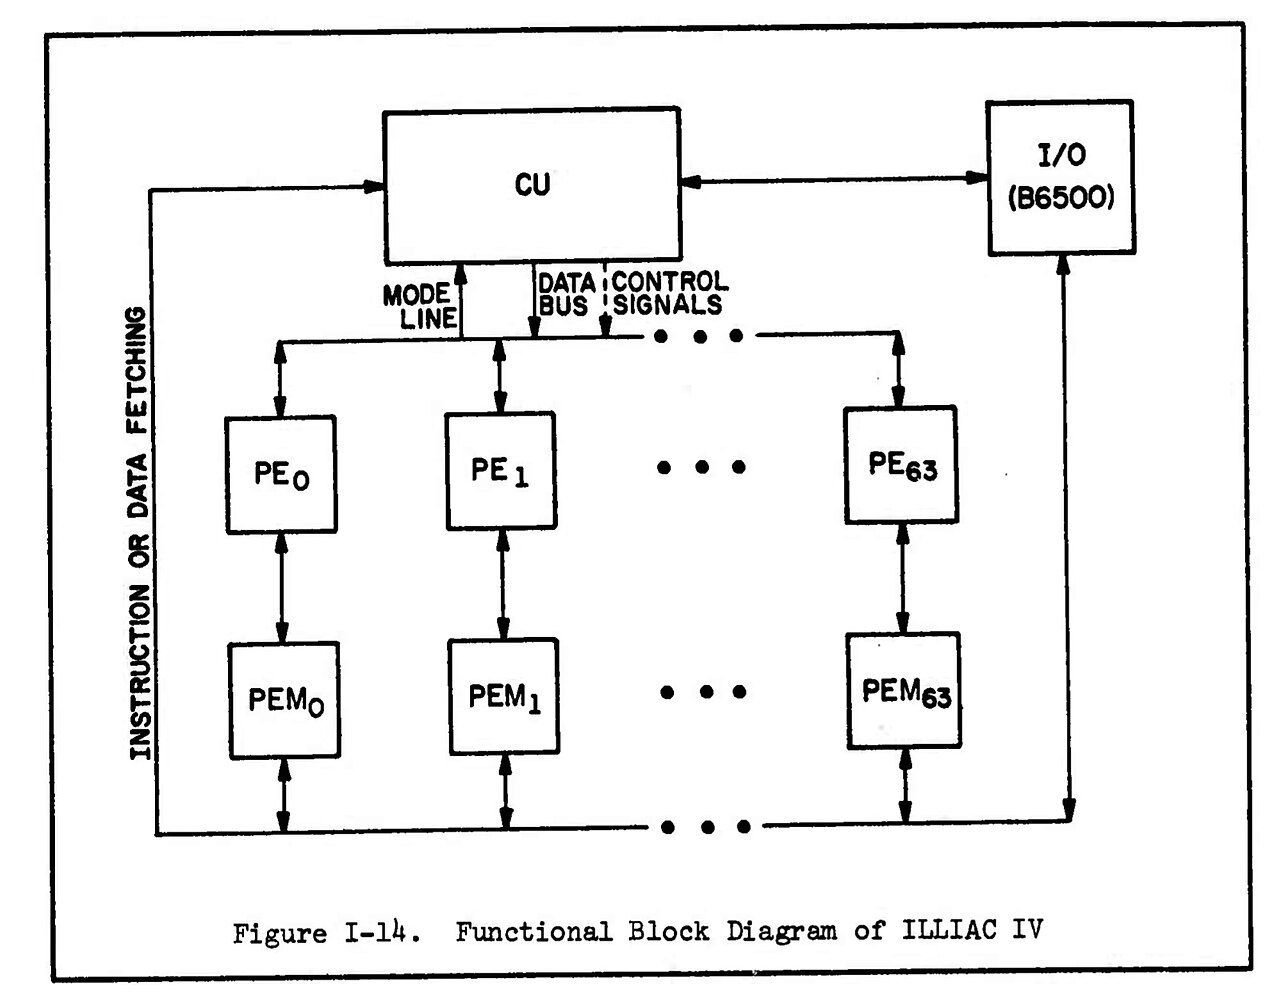
SIMT 执行模型:单控制单元向多处理单元广播指令的并行计算方式
来源标题:Single instruction, multiple threads (SIMT)
SIMT 是一种并行计算执行模型,由单一控制单元向多个处理单元广播同一指令,各处理单元可选择是否同时同步执行。每个处理单元拥有独立的数据与地址寄存器及独立内存,但整个阵列中没有处理单元拥有程序计数器,因此在 Flynn 1972 年分类中属于 SIMD 的变体,称为阵列处理器。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
单指令多线程(SIMT)是一种用于并行计算的执行模型,其中单个中央“控制单元”向多个“处理单元”广播一条指令,使它们能够可选地同步且完全独立地并行执行该指令。每个处理单元都有自己独立的数据寄存器和地址寄存器,以及自己独立的内存,但阵列中没有任何处理单元拥有程序计数器。在 Flynn 1972 年的分类法中,这种安排是 SIMD 的一种变体,称为阵列处理器。
SIMT 执行模型已在多种 GPU 上实现,并且与图形处理器通用计算(GPGPU)相关,例如一些超级计算机将 CPU 与 GPU 结合使用:在 ILLIAC IV 中,那个 CPU 是一台 Burroughs B6500。
SIMT 执行模型仍然只是一种向程序员呈现本质上仍是谓词化 SIMD 概念的方式。程序必须在设计时考虑到谓词化 SIMD。由于指令发射(作为同步广播)由单个控制单元处理,SIMT 在设计上无法允许线程(PE、lane)通过分支发生分歧,因为只有控制单元拥有程序计数器。因此,如果可能的话,应避免分歧。[2] [3]
理解 SIMT 的最简单方式是想象一个多核(MIMD)系统,其中每个核心都有自己的寄存器文件、自己的 ALU(包括 SIMD 和标量)以及自己的数据缓存,但与具有多个独立指令缓存和解码器以及多个独立程序计数器寄存器的标准多核系统不同,指令是由单个单元同步广播到所有 SIMT 核心的,该单元具有单个指令缓存和单个指令解码器,使用单个程序计数器读取指令。
SIMT 与 SIMD lane 的关键区别在于,SIMT 阵列中的每个处理单元都有自己的本地内存,并且可能拥有完全不同的栈指针(因此对完全不同的数据集进行计算),而 SIMD lane 中的 ALU 本身对内存一无所知,也没有寄存器文件。ILLIAC IV 说明了这一点。每个 SIMT 核心被称为一个处理单元(PE),每个 PE 都有自己的独立内存(PEM)。每个 PE 都有一个“索引寄存器”,它是指向其 PEM 的地址。[4][1]
在 ILLIAC IV 中,Burroughs B6500 主要处理 I/O,但也向控制单元(CU)发送指令,然后由控制单元处理向 PE 的广播。此外,B6500 作为 I/O 处理器,可以访问所有 PEM。
此外,每个 PE 可以被激活或停用。如果某个 PE 处于非活动状态,它将不会执行控制单元广播给它的指令:相反,它将保持空闲直到被激活。可以说每个 PE 都是谓词化的。
同样重要的是要注意 SIMT 与 SPMD(单程序多数据)之间的区别。SPMD 与标准多核系统一样,具有多个程序计数器,而 SIMT 只有一个:在(一个)控制单元中。
在 Flynn 的分类法中,Flynn 的原始论文引用了两个被称为“阵列处理器”的 SIMT 处理器的历史例子:SOLOMON 和 ILLIAC IV。[1]
SIMT 由 NVIDIA 在 Tesla GPU 微架构中以 G80 芯片引入。[5][6] ATI Technologies(现为 AMD)稍晚于 2007 年 5 月 14 日发布了竞争产品,即基于 TeraScale 1 的“R600”GPU 芯片。
SIMT 处理器在单个中央单元的控制下,以锁步方式执行多个“线程”(或“工作项”或“SIMD lane 操作序列”)。该模型与 SIMD lane 具有共同特征。[7]
ILLIAC IV 广泛记录了其“分支”机制,这是现代谓词掩码的前身。
由于所有广泛使用的 RAM 类型(例如 DDR SDRAM、GDDR SDRAM、XDR DRAM 等)的访问时间仍然相对较高,产生了一种称为内存墙的效应,工程师们想出了隐藏每次内存访问不可避免带来的延迟的想法。如 ILLIAC IV 的设计所示,各个 PE 以比标准 CPU 更慢的时钟速率运行,但通过大规模并行运行更多这样的 PE 来弥补时钟速率的不足。结果是每个 PE 较慢的速度与 RAM 的速度更好地匹配。该策略之所以有效,是因为 GPU 工作负载本质上是并行的,一个例子是分块渲染。
SIMT 旨在限制指令获取开销[8],即内存访问带来的延迟,并在现代 GPU(如 NVIDIA 和 AMD 的 GPU)中与“延迟隐藏”结合使用,以在内存访问操作存在相当大延迟的情况下实现高性能执行。与 SIMD 一样,另一个主要优势是许多数据 lane 共享控制逻辑,从而导致计算密度增加。一个控制逻辑块可以管理 N 个数据 lane,而不是将控制逻辑复制 N 次。
SIMT 执行的一个缺点是,由于只有一个程序计数器,“谓词掩码”是控制每个 PE 执行的唯一策略,导致在复杂算法中利用率不佳。
NVIDIA GPU 有一个线程组的概念,称为“warp”,由 32 个以锁步方式执行的硬件线程组成。AMD GPU 中的等价物是“wavefront”,尽管它由 64 个硬件线程组成。在 OpenCL 中,warp 和 wavefront 的抽象术语称为“sub-group”。CUDA 还有 warp shuffle 指令,使线程组中的并行数据交换更快[10],OpenCL 通过扩展 cl_khr_subgroups 允许类似的功能支持。[11]
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。