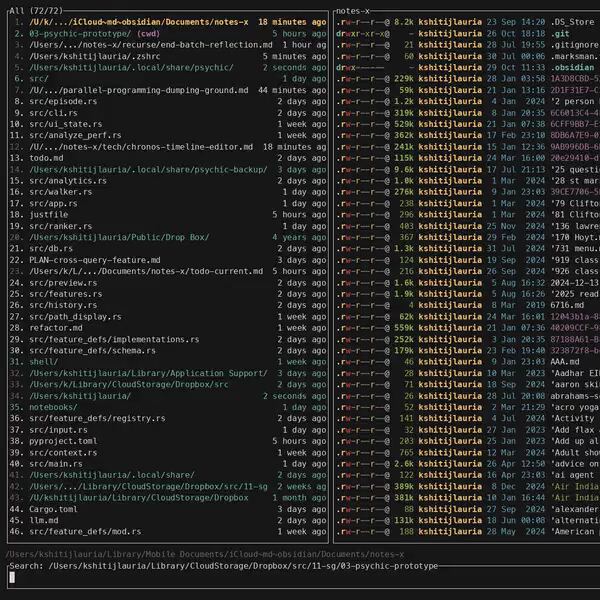
Psychic:基于用户行为学习的终端文件浏览器
来源标题:Psychic: Like fzf but learns from your actions
开发者推出终端文件浏览器 Psychic,它通过记录用户常去的目录和打开的文件,训练轻量级机器学习模型对结果排序。其设计以速度优先,界面渲染时间低于 16ms,按键后一帧内即可更新结果。该工具已通过 Homebrew 分发。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
大多数时候,我都在终端里 cd 进各个目录、在编辑器里打开文件。一周下来,用到的基本是同样的文件和目录,因为我在做的还是那几个项目。我烦透了得记住文件都放在哪儿,也厌倦了一遍遍对同样的几条路径按 Tab 补全。我的电脑本该已经知道我想打开哪个文件!
于是就有了 psychic,一个快速的终端文件浏览器。它会记录你进入过的目录,记住你打开过的文件。它在你自己的数据上训练一个轻量级 ML 模型,并用这个模型给结果排序。它把交互性和速度放在第一位:结果随输入实时更新,UI 渲染时间控制在 16ms 以内。
它的全部实现都源于一个关键的设计决定:必须快到在按键后的一帧之内完成更新。我宁愿在几秒之内做 10 次快速搜索,也不要 1 次耗时好几秒的智能搜索。
只要我坐在电脑前,就会用 psychic。它已经成为我在文件系统里穿行的主要方式。一些数据:自从 2025 年 10 月开始使用它以来, (这些数字来自内置的 psychic stats 命令,你也可以在自己的历史记录上运行它!) 它已经上了 homebrew:brew install kshitijl/tap/psychic。
左边是搜索结果,右边是当前选中文件或目录的预览。你在底部输入查询,结果就会被过滤和排序,每敲一个字母都会变化。如果对文件按 Enter,它会在同一个窗口里打开你的终端编辑器,并在后台等待;如果选中的是目录,它就会在该目录内重新开始搜索。它记住了你打开过的每一个文件和目录,shell 集成还会记录你在 psychic 之外 cd 进入的每一个目录。所有这些都会纳入每一次搜索。
它就像 fzf 和 zoxide 的孩子,外加一个小巧的 ML 模型来学习你的使用模式和偏好。它是在你自己的数据上做广告优化,帮你更快地在电脑里穿行。
你所有的搜索和点击都会写入电脑上的一个 sqlite 数据库。psychic 在这些数据上训练一个 LightGBM 模型。模型学会根据你的搜索查询,预测你会打开哪些文件。psychic 用这个模型对搜索结果排序。每次按键后,psychic 都会重新运行模型并重新对所有结果排序。
更多细节见仓库里的 README。
我用的模型是 LightGBM,一种梯度提升树实现。它小巧、快速,几秒钟就能训练完成。它能学到依赖阈值取值的规则。例如,它可以学到这样一条规则:“大于 1 MB 的文件,只有最近 24 小时内被修改过才会被打开”,比如日志文件。LightGBM 还有出色的 LambdaRank 目标函数,正是为这类排序任务专门设计的。
延迟预算排除了任何非本地的模型:一次网络调用很容易就超过 10ms,甚至更糟。它也排除了 LLM 或任何 transformer 模型。线性回归和逻辑回归又太简单,效果比 LightGBM 差得多。
每次你打开 psychic 时,模型都会从头重新训练。这意味着它始终反映你当前的使用模式。训练在后台进行,完成后把模型写入磁盘。我们不会在你正看着结果的时候切换到新模型,因为应用这样做的时候体验很割裂。相反,我们会等到你不看屏幕的时候,比如你在编辑器里打开文件、或点击某个目录的时候,再切换到新模型。我为这个精心安排的小配合感到自豪。
当用户刚开始使用 psychic 时,没有足够的点击数据用于训练。我们用一个简单模型,奖励最近的点击、最近的修改时间,以及查询与文件名之间的模糊匹配。最终得分是简单模型和 ML 模型的加权和。点击少的时候,简单模型占主导;随着点击数据积累,ML 模型的得分权重越来越高,直到基本上变成 1。
我精心挑选了一组特征,用来预测你会打开哪个文件。有些特征很简单:你上次在 psychic 里点击它距今多久、它的修改时间、文件名是否以查询开头、查询与文件名之间的模糊文本匹配得分。下面是一个调试面板,展示了这些特征和一些性能统计:
这个调试面板在早期对弄清楚奇怪的结果或卡顿非常有帮助。现在 psychic 已经相当稳定,但我有时还是喜欢打开它看看。
有一个特征是“最近点击过、且与当前文件处于同一目录下的文件数量”。这个特征帮助模型提升当前活跃项目中的文件。
“针对此查询的点击次数”这个特征,帮助模型把特定查询与特定文件关联起来,而不必真的记住文件名和查询文本。这样一来,虽然模型并不直接看到文件名,它仍然能记住这些关联。
每次训练运行都会写出一份带一些统计数据的 pdf。这里可以看到一条训练曲线和每个特征的增益。
一个 episode 定义为从打开 psychic(或从上一次点击)到点击某个条目之间发生的所有事情。所以单个 episode 会包含一连串查询,包括按退格和尝试新查询。“此 episode 中含该查询的交互次数”这个特征,统计的是在包含当前查询的某个 episode 中,你在任意时刻点击某个文件的次数。所以如果你总是输入“es”,最后点了“bayesian-estimate.md”,模型就能看到这个关联。下次你输入“es”时,模型就会把那个文件放在列表顶部。
这里是 SHAP 值和一张点图。它们帮我理解一个特征对模型输出的影响有多大,以及解释模型为什么会有这样的行为。例如,点图显示模型偏好最近修改过的文件,而不喜欢大多数大文件。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。