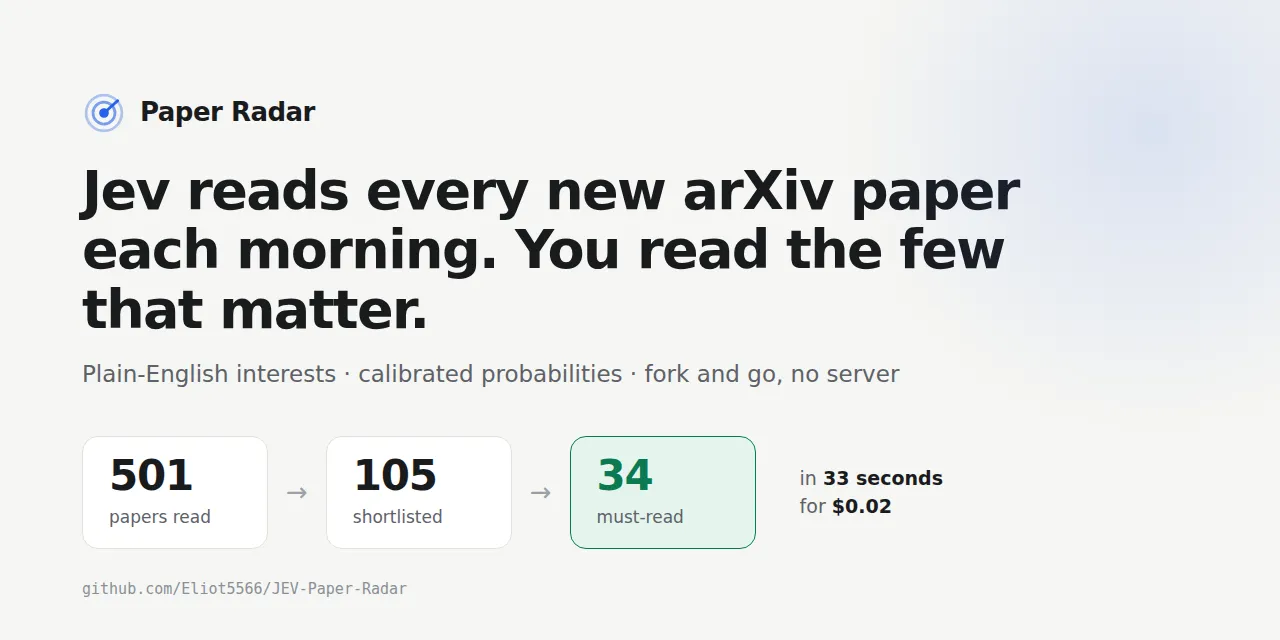
Paper Radar 每日筛选 arXiv 论文,现支持 Claude Haiku
来源标题:Show HN: Paper Radar – daily ArXiv triage, now runs on Claude Haiku too
Paper Radar 推出基于 Claude Haiku 的运行模式,提供与原有 Jev 模型相同的每日论文筛选页面。该系统用是非题判断每篇论文是否匹配用户兴趣并返回概率,覆盖全部 arXiv 新论文每天成本约 6 美分。一次实测中,Jev 在 5 秒内以 0.002 美元判断了 50 篇新论文。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Jev 每天早上读完 arXiv 上所有新论文,你只需要读其中真正重要的那几篇。它现在也能跑在 Claude (Haiku) 上——同样的每日页面、自报概率、首轮校准。用大白话描述兴趣 · 经过校准的概率 · 覆盖整个 arXiv 每天约 6 美分 · fork 即用,无需服务器。快速开始 · 试用演示 · 工作原理 · 基准测试 · 繁體中文。
一次真实运行:50 篇新 arXiv 论文由 Jev 在 5 秒内判定,花费 $0.002。没有 API key?paper-radar demo 可以离线展示同样的页面。
arXiv 现在每月收到超过 30,000 篇论文(2026 年 6 月为 32,040 篇),每个工作日公告约 1,500 篇。已经没人再逐条读列表了。关键词提醒会漏掉用了不同措辞的论文,embedding 推荐器会悄悄丢掉任何不像你过往阅读记录的东西,而每天用聊天 LLM 跑整个信息洪流既慢又费钱。
大多数 AI 工具读完一篇论文会给你写一段摘要。Paper Radar 什么都不写。它向 Jev——TypeSafe 的 System One 模型——每个兴趣问一个 yes/no 问题,拿回一个概率:引入了一个 agent 基准,0.97。这个数字意味着什么,由你仓库里的代码决定。
用判断代替文字,正是这套算术成立的原因。没有东西需要解析,也不会编造标签,而且一次判断的成本只是生成一句话的零头——便宜到足以读完所有 1,500 篇论文,而不是只看预筛过的一小把,而关键词提醒和 embedding 推荐器恰恰就在这一步弄丢了你真正想要的那篇。
- 实测而非估算:2026-09-23 的一次真实运行读了 50 篇论文,耗时 5 秒,46,584 个输入 token,花费 $0.0020(每篇 932 token,jev-1.13.0)。整个 arXiv 每个工作日约 1,500 篇,算下来约每天 $0.06。输出 token 免费。每次运行都会把自己的 token 和花费记录到
data/runs.jsonl;paper-radar check会在你花钱之前先估算你的配置。已对照真实审稿人验证,而非只是口头声称:在四篇它从未见过的 Cochrane 综述上,筛查 19,447 条记录,复现了审稿人纳入研究中 96.9% 的结果,同时减少了 78% 的阅读量,花费 $0.60。过程中那些预测错误的记录也一并公开了——见基准测试。
每个工作日这里都跑着七个 radar。取走你所在领域的 RSS 链接——无需安装、无需 key、无需账号:https://eliot5566.github.io/JEV-Paper-Radar/public/ 每一个都只是 radars/ 下的普通配置文件。Fork 这个仓库,你的配置会更窄,也会有用得多。
GitHub Pages 上的网页:must-read 和 maybe 列表、near misses,以及被你的排除条件过滤掉的内容。一个 RSS feed(feed.xml),可用于任何阅读器,包括 Zotero(File → New Feed),让精选结果直接落在你的文献库旁边。可选的 Slack、Discord、Telegram 或邮件摘要。可选的一句话 TL;DR,用你的语言、由任意 LLM 撰写,仅针对前 10 篇论文。一份审计记录:每一个决策、概率和模型版本都提交到 data/ 下。
快速开始(5 分钟,无需服务器):Fork 这个仓库。然后打开你 fork 的 Actions 标签页,点击 enable workflows(GitHub 会在新 fork 中关闭它们)。在 radar.toml 中描述你的兴趣:每个兴趣一条大白话描述。在 Settings → Secrets and variables → Actions 下添加一个 key:TYPESAFE_API_KEY,来自 console.typesafe.ai;或者如果你还在 TypeSafe 的等待名单上,用 OPENROUTER_API_KEY,在 radar.toml 中设置 backend = "openrouter" 和 model = "typesafe/jev-1.13"——OpenRouter 提供 Jev,无需等待名单;或者用 ANTHROPIC_API_KEY 改用 Claude 来判定(见下文),在 radar.toml 中设置 backend = "claude"。开启 Pages:Settings → Pages → Source: GitHub Actions。运行它:Actions → Paper Radar → Run workflow(在 limit 中填 50 做一次便宜的首次测试)。
改用 Claude 代替 Jev:如果你已经有 Anthropic API key,Claude 也可以做判定——同样的流水线、同样的校准步骤,无需等待 Jev。两条诚实的警告。第一,Claude 的概率是自报的,不是校准过的:Jev 返回的是经过校准的数值;Claude 返回的是它写进 JSON 的一个数字。先在几十篇论文上运行 paper-radar label,再运行 paper-radar calibrate,把阈值拟合到 Claude 上,然后再信任一次运行——radar.toml 里的 Jev 阈值不会迁移过去。第二,本 README 中的基准数字仅适用于 Jev:Cochrane 筛查结果(96.9% 召回率,19,447 条记录上节省 78% 工作量)是用 Jev 测得的,不适用于 Claude。API 也与 Claude Pro/Max 订阅分开计费,且每篇论文比 Jev 更贵;把 jev.price_per_mtok 设为约 0.15 以估算 Haiku 成本,如果你在较低的 API 层级,调低 jev.requests_per_minute。
现在 Claude 后端有了首轮校准——见 docs/claude-calibration.md。在 2026-11-11 arXiv 列表的 49 篇论文上(6 篇相关),Claude Haiku 5.5 的 Brier 分数为 0.040,ECE 为 0.081,建议的 Claude 阈值为 must_read 0.65 和 maybe 0.35,而 Jev 的阈值是 0.80 / 0.50。在信任这些数字之前,请先阅读该文档中的来源警告:标签是由 Muse 根据标题和裁剪过的摘要生成的,而不是由用户打的——这是一次首轮查看,不是用户验证过的校准,并且并未声称 Claude 是经过校准的。为公平起见:用户也从未为 Jev 标注过论文——Jev 阈值是仓库首次提交时的默认值,仓库中唯一的地面真值测量就是那个筛查基准——所以这是任一后端在每日 radar 上的首次带标签测量。
之后它会在工作日 UTC 02:00 运行,正好在 arXiv 每日公告之后。你的 radar 位于 https://<you>.github.io/<repo>/,feed 位于 /feed.xml。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。