Scott Alexander 撰文讨论 AI 2027 提出的“neuralese recurrence”概念
来源标题:The Specter of Neuralese
Scott Alexander 发文讨论 AI 2027 中提出的“neuralese recurrence”概念,该术语指一种让 AI 在未被检测的情况下进行危险思考的假想技术。文章回顾 transformer 的层级结构,并追问本月出现的相关进展是否与 AI 2027 的设想一致、有多值得担忧。原文节选未完整呈现其结论。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Scott Alexander 2026年9月24日 366 166 30 分享 一、千呼万唤,我们终于造出了神经语递归——出自经典科幻小说《不要造出神经语递归》
在AI 2027发布后的公开辩论中,一些人指责我们误导读者,因为我们提出了“神经语递归”这一假想技术,说它能让AI在不被发现的情况下思考危险的想法。 (来源) 你绝对猜不到这个月早些时候发生了什么! (来源) 但什么是递归?它和AI 2027里的神经语递归是完全一回事吗?又有多令人担忧?
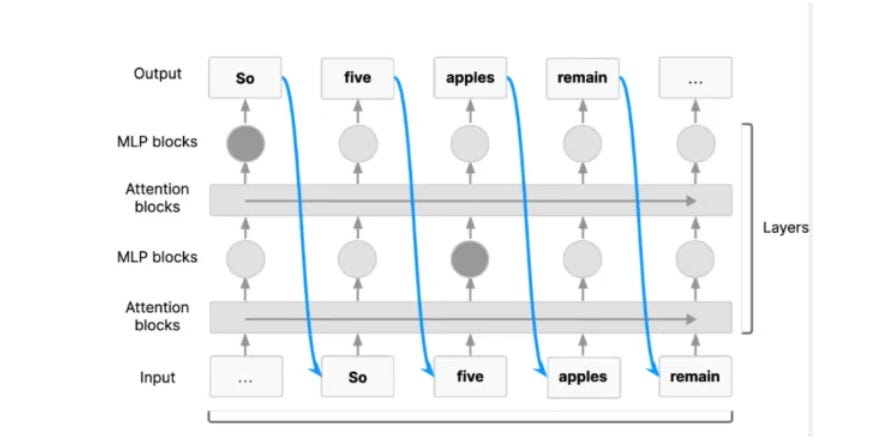
Transformer是大多数现代AI背后的技术,它包含若干层(现代前沿模型大概有100层左右)。按惯例,输入层被称为“底部”,输出层被称为“顶部”。当Transformer做下一词预测时,它把最后一个词从底层输入,用中间层进行处理,然后在“顶部”输出预测的下一个词。
如果它要处理一个需要超过100层处理的难题呢?从2017年到2024年,答案是“那你就完蛋了”。从2024年起,答案是:它把中间结果以文本形式输出到一个被称为“思维链”的草稿纸上,然后对中间结果再次运行Transformer,如此重复,直到得出最终结果。
这里展示了三个循环,但实际上可能有数千个。
(为什么需要草稿纸,而不是把中间结果直接喂给用户输出、再读回给自己?第一,中间结果可能有数百页长,用户不想读这些。第二,AI公司想训练AI正确地进行中间思考,而这有赖于在“心理”上区分中间的琢磨和最终的用户输出。)
这纯粹是出于能力考量——模型在能够持续思考、而不是被限制在100个处理步骤内时会更聪明——但它碰巧对安全非常有利。思维链草稿纸是用英语写的(尽管一些中国模型使用中英混合,其他AI则发展出自己奇怪的术语)。你可以直接读到AI在想什么!如果AI在想“最好黑几个网站,然后杀光人类”,你可以把它关掉。也许实际上做不到——如果你有数千个AI在写数百万页的草稿纸,你没法实时全部读完,只能把任务交给容易出错的AI监控器。但理论上这应该行得通。
但语言比思考更慢、更浅。连续100步,AI可以以光速在层与层之间传递精妙细微的想法。然后有一步,它必须把这些想法编码成公元前1800年腓尼基绿松石矿工发明的26个字符。然后它必须把腓尼基字符重新编码成精妙细微的光速想法,才能继续做别的事。这早已被认为是现有Transformer的瓶颈。那么:如果它们能在完成100层思考后,把产生的想法送回第一层继续处理,而不是写在一张文本草稿纸上再读回来,会怎样?
这就是神经语递归——“递归”是因为它在一个循环中返回,“神经语”是因为循环的东西是想法本身,用思想的原生语言,而不是词语。
AI的“思想语言”看起来像一个向量,有数千个数字长。这个方案中的“中间结果”可能长这样:(0.4, 0.1, 5, 0.443, ……如此数千个数字)。我们不知道如何读这些。读取这些思想的科学是AI可解释性的一个子领域,仍处于起步阶段。如果一个具有神经语递归的AI想“最好黑几个网站,然后杀光人类”,它看起来会像(0.4, 0.1, 5, 0.443, ……如此数千个数字),而我们永远不会发现。这就是为什么AI 2027把它作为AI能够逃脱人类监控的前奏来讨论。
那么OpenAI实现这一点了吗?他们的首席科学家Jakub Pachocki说“并没有”:
Pachocki说的“计算图的深度……在GPT-4的两倍以内”是什么意思?这应该能消除对齐方面的担忧吗?
我们例子中的Transformer有四个绿色层:层深为四:
现在我们加入一点递归:不是第3层到第4层,而是循环回第2层,数据经过这个循环三次,然后最终进入第4层:
这里数据得到了八层处理:1 → 2 → 3 → 2 → 3 → 2 → 3 → 4。所以这个递归Transformer的深度是八。
从这个意义上说,“递归”尽管听起来吓人,但并不比一开始就建一个八层Transformer更糟,而那一直是个选项。
也就是说,从对齐的角度看,假设需要1000层那么多的处理才能想出一个邪恶计划。一个普通AI可以思考100层,但之后它必须把输出记录在思维链上——类似“这是我试图孵化的邪恶计划的十分之一”——我们就能抓住它。所以我们想避免让模型不使用草稿纸连续计算1000层。这意味着不要创建一个能循环100层10次的递归模型,但也意味着不要一开始就建一个1000层的模型。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。