OpenAI、Citadel Securities与Sequoia举办的Castle Challenge揭晓,参赛者两局均获第一
来源标题:1st place in the OpenAI × Citadel Securities × Sequoia Castle Challenge
一位参赛者在OpenAI、Citadel Securities与Sequoia于2026年11月合办的No Limit Castle Challenge策略解谜比赛中,两个游戏均排名第一,共有约6000份参赛作品。该比赛采用Colonel Blotto博弈形式,选手需将100名士兵分配至五个分值不同的城堡。作者指出Head to Head第一名为共享,Four-Way因随机分组每次重算排名会有变化。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
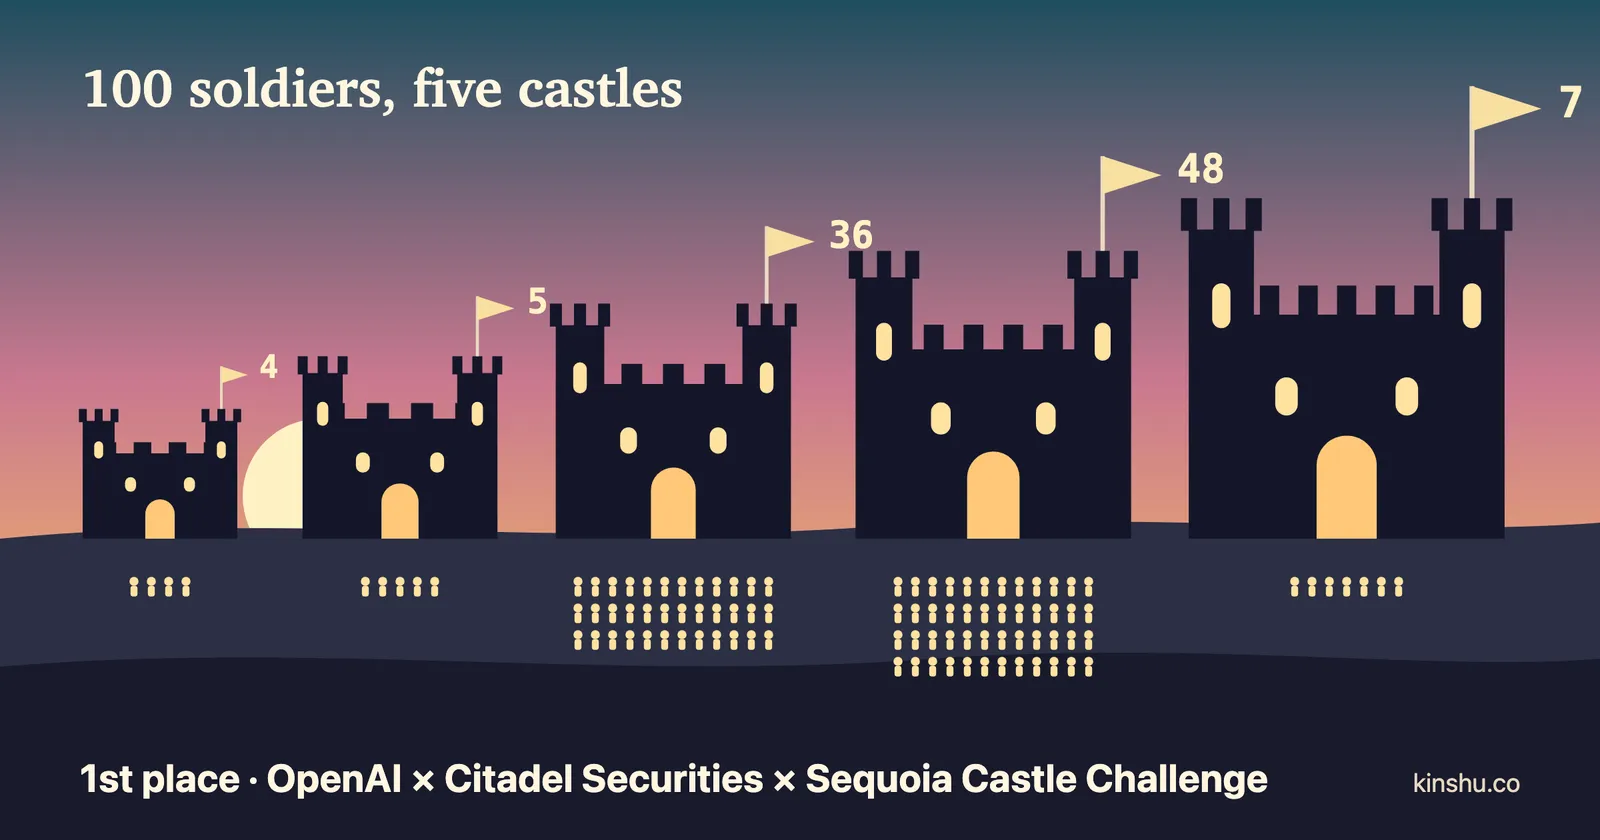
我在2026年11月由OpenAI、Citadel Securities和Sequoia联合举办的策略谜题No Limit Castle Challenge的两个游戏中均获得第一名,参赛作品约六千份。 排行榜每15分钟重新计算一次,只要有变化就会重新发布。这些计数涵盖了我的参赛作品出现后45小时内发布的105个版本,截止到波士顿截止时间前的最后一次更新。 有两点需要说明。在Head to Head中,第一名是共享的:其中一个是我的测量用参赛作品(下文会解释),后来又与五个复制了该分配的参赛作品并列。Four-Way按随机抽取的组来评分,所以每次重新计算排行榜时,参赛作品的排名都会变化。我的作品在第一次榜单上排第三,之后成为第一的次数比其他任何参赛作品都多(第二名的最好成绩是29次),并且从未低于第十名。 这是一个Colonel Blotto游戏。你有100名士兵,要分配到五座价值分别为1、2、3、4和5分的城堡上。每个人为两个游戏各提交一个分配方案。 Head to Head。你的分配会与所有其他参赛作品各对战一次。每座城堡归投入士兵更多的一方,平局则平分该城堡的分数。你的得分是对每个对手所得分数的平均值,满分为15。 Four-Way。你的分配会和另外三个参赛作品分到一组。每座城堡归四人中在该城堡投入士兵最多的那一个。四人按城堡得分排名,并按名次获得奖励,平局则平分: 主办方从参赛池中随机抽取1,000,000个四人组,你的得分是你的平均奖励,满分为9。 任何分配都会输给某个其他分配:在城堡4上放48名士兵,就会有人用49拿下它,并把差额用在别处。最优分配取决于实际提交的参赛作品。 这些参赛作品来自人们相互揣测对方的推理,通常被称为level-k思维:level-0玩家平均分配或把兵力堆到大城堡上,level-1对level-0做出最佳回应,level-2对level-1做出最佳回应,依此类推。 形式化地说,参赛池是一个经验联合分布(P),定义在将100名士兵分配到五座城堡的(\binom{104}{4} = 4{,}598{,}126)种方式上,任务是找到在面对从该分布中抽取的对手时期望得分最高的分配。(P)并不公开:排行榜只显示每个参赛作品的得分,完全不显示其分配。问题是要从得分推断出(P)。Head to Head对(P)的依赖仅通过它的五个边缘分布,每座城堡一个:参赛池向该城堡投入多少士兵,忽略每个参赛作品的其他部分。 城堡1 1分 4 城堡2 2分 5 城堡3 3分 36 城堡4 4分 48 城堡5 5分 7 0 10 20 30 40 50 60 70 向该城堡投入的士兵数 每座城堡的分布形状就是参赛池,由下文描述的模型拟合得到。标记是我的参赛作品。 探针 排行榜显示得分,隐藏分配。但我提交的任何参赛作品的分配我都知道,所以我自己的每个参赛作品都是关于参赛池的一个精确事实:这个分配得到这么多分。我把为此目的提交的参赛作品称为探针。 Head to Head的收益是可分离的:它是每座城堡一项的求和。令随机变量(X_c)为对手向城堡(c)投入的士兵数。分配(a = (a_1, \dots, a_5))的得分为 其中(F_c(x))是参赛池中在城堡(c)上被(x)名士兵击败的比例,平局按一半计算: (F_c)接近城堡(c)边缘分布的累积分布函数。区别在于平局:CDF,(\Pr[X_c \le x]),把平局完全计入,而(F_c)把平局算作一半,因为平局会平分该城堡。得分对参赛池的依赖仅通过(F_1, \dots, F_5)。一个只在一两座城堡上投入士兵的参赛作品,会在其公开得分中隔离出一个或两个(F_c)的值。 五个探针各自把全部100名士兵放在一座城堡上。在11月7日03:06 UTC、截止时间前两小时的排行榜上,放在城堡5上的那个探针得分为5.613。它的得分有两部分。 五个全押参赛作品中的每一个都给出一个这样的方程。一个参赛作品的方程会略去它自己的城堡,所以没有任何单个参赛作品能给出任何(z_c): 五个方程,五个未知数。联立求解可得到参赛池向每座城堡投入零名士兵的比例: 每个(F_c)的其余部分来自第二类探针:士兵放在一座城堡上,其余停在城堡1。例如,59-0-0-41-0得到4.501分。 这是一个含两个未知数的方程。把59名士兵停在城堡1几乎总能拿下它,但并非总是如此:大约5%的参赛池会投入更多。所以单个探针本身并不能给出(F_4(41))。它把(F_4(41))与(F_1(59))联系在一起。 大约八十个这样的参赛作品覆盖了全部五座城堡,每一个都是这种形式的方程。下一节的模型将它们联立求解。它给出(F_1(59))为0.95,(F_4(41))为0.72:城堡4上的41名士兵击败了72%的参赛池。 每个探针都是关于参赛池的一个方程,而不是对它的直接读取。为了联立求解这些方程,并在它们之间填补空白,我拟合了一个(P)的模型,该模型与每个探针以及公开得分都一致。 该模型是一个约290,000个粒子的群体:从所有可能的分配中均匀随机抽取的分配。粒子(i)有一个分配(b_i = (b_{i,1}, \dots, b_{i,5}))和一个权重(w_i),即它在参赛池中的份额。权重之和为1,初始时相等。 均匀抽取不对人们如何玩做任何假设。我的第一个先验做了假设:整数分配以及一个人可能合理选择的几种形状。它的预测很糟糕。一个每座城堡放20名士兵的参赛作品被预测得分为7.8,实际得分为6.13。然后我在三个未参与拟合的已知参赛作品上比较了八种先验。均匀先验的误差为0.11,而七种人类形状先验的误差为0.33到0.60。先验假设越少,预测越好。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。