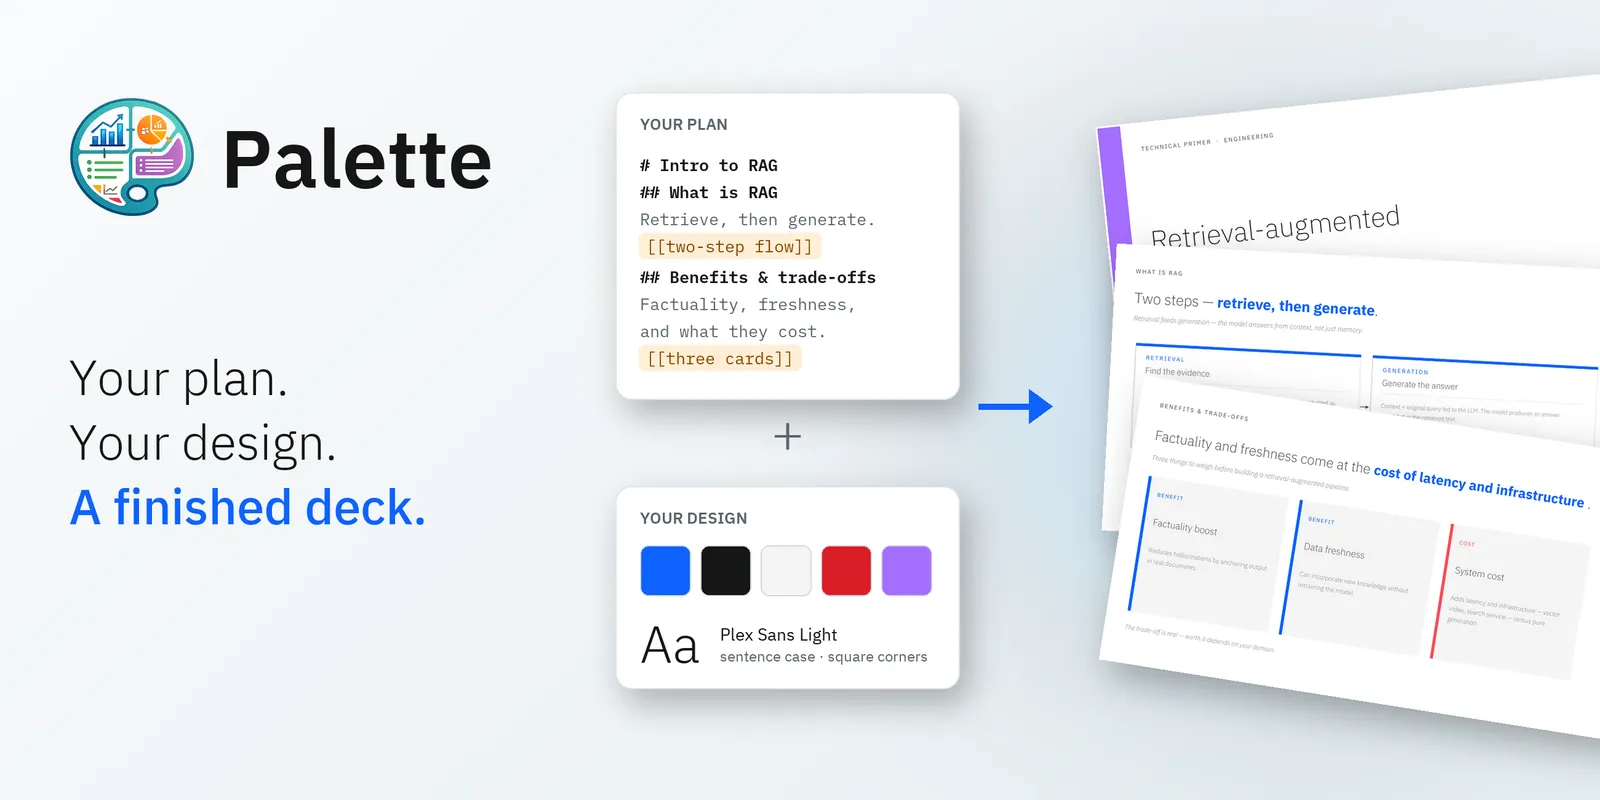
IBM 研究团队推出 Palette:让小模型按企业设计语言生成演示文稿
来源标题:Palette: teaching a small model to build decks in your design language
IBM 研究团队发布 Palette,通过训练小型开源模型,使其能按企业自有设计语言生成整套演示文稿。该方法把设计师与编码员的分工方式引入模型流程,并支持用自然语言调整演示文稿风格,同时通过校验与修复机制保证质量。团队称这解决了前沿模型风格趋同、以及机密内容无法外传的问题。
以下正文由 AI 翻译自 Hugging Face Blog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
回到文章列表 Palette:教一个小模型按你的设计语言构建演示文稿 企业文章 已发布 2026年11月3日 点赞 - Praveen Venkateswaran praveenv 关注 ibm-research Anupama Murthi anupamamurthi 关注 ibm-research Hamid Adebayo harmedox 关注 ibm-research 为什么演示文稿对小模型来说很难 像人一样构建:设计师与编码者 合成演示文稿及其推理过程 用自然语言引导演示文稿 构建检查与修复框架 评估 下一步 我们学到了什么 让前沿模型做一份幻灯片,你会得到一份不错的成品。让它做十份,它们就开始变得千篇一律:同样雅致的默认样式、同样的品牌风格、隐约透出一股“AI生成演示文稿”的味道。这本身没问题,直到你希望演示文稿看起来像你自己的模板。前沿模型有自己的品牌风格,无论怎么提示都无法阻止它们滑回那种风格。而且有时候内容属于机密,根本不能离开你的系统。 这两点都指向一个你自己拥有的模型:开放权重、运行在你自己的基础设施上、按你自己的设计语言训练。问题在于,小型开放模型——你真正会自托管的那种——在这方面表现很差。它们做出来的演示文稿是坏的:标题消失在背景里、文字跑出幻灯片、形状层层叠叠堆在一起。 Palette 验证的是一个赌注:一个小型开放权重模型,用你设计语言下的合成数据训练,并由一个框架进行检查,能否与前沿系统竞争,同时让你保留对结果的所有权。我们微调了一个 20B 模型,让它像人一样构建演示文稿:由设计师规划整份文稿,由编码者绘制每一页幻灯片。它的训练数据遵循 IBM Design Language,在 PresentBench 上,它在我们测量的三个领域中的两个上排名第一。本文介绍我们如何合成数据、训练模型,并在其周围构建一个框架。 为什么演示文稿对小模型来说很难 幻灯片看起来简单,但制作一份幻灯片要求模型做三件小模型不擅长的事。 它在看不到幻灯片的情况下进行布局。模型并不直接绘制幻灯片;它编写代码,把每个元素放到特定的 x、y、宽度和字号上。一个 75 字符的标题在 56pt 下能否排进两行,是模型在脑中做的算术,而它只有在代码渲染之后才会发现自己算错了。小模型经常在这上面出错,重叠的形状和跑出幻灯片的文字就是这样来的。 它同时做两类决策。决定每页幻灯片说什么以及如何呈现(用图表还是表格?删掉什么?)是编辑判断。精确地放置它则是几何问题。单次生成必须在 10–20 页幻灯片上同时完成这两件事,同时保持配色、字体和布局的一致性。 没有数据展示演示文稿是如何被制作出来的。成品演示文稿大量存在,但设计选择背后的理由或生成它们的代码并不存在。 像人一样构建:设计师与编码者 没有人能一次性做出演示文稿。你先决定故事(多少页、每页说什么、哪页用图表、哪页用表格),然后才构建每一页。Palette 以同样的方式拆分工作,分成两个角色,由一个 LoRA 适配器承担: 现在每个角色只做一类决策:设计师负责编辑判断,编码者负责几何布局。两者之间的简报可读可编辑,因此人或 agent 可以修改某一页的布局,而不必重新生成整份文稿。而且由于每页幻灯片的上下文在任何代码编写之前就已固定,编码者的调用可以并行执行,每页一个,这使得编码阶段快了约 6–7 倍。 我们用 LoRA 而非全量微调来训练该适配器:它在能力强大的基础模型之上教授一种格式和一项技能,而不扰乱基础模型已知的东西,并且让每次实验成本很低。一个教训:编码者示例的长度约为设计师示例的 5 倍,因此朴素的混合方式会让设计师训练不足,直到我们将其示例过采样 5 倍。 合成演示文稿及其推理过程 不存在公开的规划、设计决策和幻灯片代码语料库,所以我们用一个大开源教师模型生成了一个。每份演示文稿都从一个配方开始,配方设定其体裁、长度、布局和任何用户指令,因此我们能控制数据的覆盖范围。规划范围从整齐的大纲到原始的内容堆砌,让模型学会删减和压缩。我们生成了约 1000 份演示文稿,覆盖约 10,000 页幻灯片。 每个示例还带有其背后的推理,以反事实的形式书写:推理轨迹会权衡一个替代方案并说明为何被拒绝,因此模型学到的是选择背后的规则,而不只是选择本身。设计师对内容和形式进行推理。例如: “四个季度的营收,有一个清晰的上升趋势。我考虑过用表格,但这页的重点是趋势,而不是精确数字,所以柱状图能让人一眼看到。” “标题有 62 个字符。在 44pt 下它会折成三行并撞到下方的图表,所以我设为 36pt,这样能排进两行,并在图表上方留出空间。” 仅有教师模型并不能让数据变好;围绕它的循环才行。每份合成的演示文稿都会被渲染,并由推理时框架所使用的同一个检查器检查重叠和溢出。损坏的幻灯片会被修复,其推理会被重写成同类的反事实,涵盖原布局错在哪里以及修复为何有效。检查器捕获的每个错误都成为一个更好的训练示例。 最难的问题是忠实性。最严重的失败是幻灯片包含输入中不存在的事实,我们发现提示规则无法防止这一点。如果一份简报要求一个六乘五的表格,但只带三条要点,编码者就必须编造其余内容。 解决它的是参考演示文稿,而不是规则:固定一份参考能可靠地改变教师模型的输出,而添加一条规则很少能做到。教师模型在提示中看到几份参考演示文稿,模仿它们的程度远高于遵循指令。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。