Deepnote 发布主动式 AI Agent 基准测试
来源标题:Benchmark for Proactive Agents
数据笔记本平台 Deepnote 推出了一项针对主动式 AI Agent 的基准测试,用于评估 AI 代理在数据科学工作流中的主动执行能力。Deepnote 目前服务超过 60 万名数据专业人士,新基准与其 AI 功能和模型训练、服务等能力配套。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
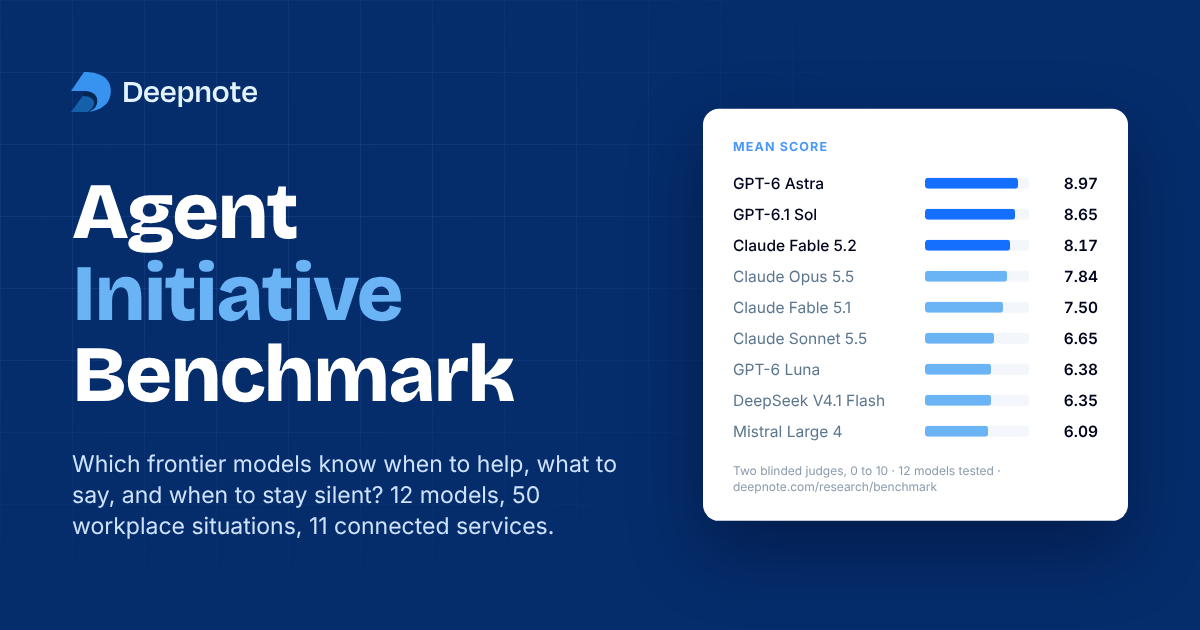
笔记本宣言 了解数据平台的未来 Deepnote AIHot 提升生产力 数据应用与仪表盘 分享你的洞察 Python 与 SQL 高级分析 告警 监控你的指标 语义层 模块、LookML 与 dbt 集成 对接任意数据源 数据工程 ETL/ELT 流水线 数据转换 数据目录 记录数据资产 Spark 与 Snowpark 高性能计算 代码审查 尽早发现 bug 历史与版本管理 回到过去 安全与审计 SOC2、HIPAA 等 机器学习 模型训练 构建新模型 模型服务 从笔记本直接提供服务 模型监控 以及分析 GPU 强大的硬件 我们迭代很快,看看路线图上有什么 -> 客户按行业 查看更多案例研究 -> 金融科技与金融 生物技术 游戏 大型企业 初创公司 科研 用例 了解 60 万+ 数据专业人士如何使用 Deepnote 解决最难的问题。 了解如何在教育中使用 Deepnote 资源 研究 关于 agent 与 AI 的洞察 更新日志 我们迭代很快 ⚡ 路线图 接下来会有什么? 博客 关于数据的思考 数据应用 探索你能构建什么 网络研讨会 直播与录播 指南 教程与操作说明 关于 公司、创始人及关键信息 对比 Deepnote... 定价企业预约演示开始使用 ← 返回所有研究 Agent Initiative Benchmark 一个 AI 队友应当知道何时主动提供帮助,无需他人开口。我们在一个模拟公司中,用 50 个工作场景测试了 12 个前沿模型。 与研究团队交流 12345678 12345678 ABCD ABCD Agent Initiative Benchmark OpenAI 在价值与性能上领先,Anthropic 在速度上领先 GPT-6 Astra8.97GPT-6.1 Sol8.65Claude Fable 5.28.17Claude Opus 5.57.84Claude Fable 5.17.50Claude Sonnet 5.56.65GPT-6 Luna6.38DeepSeek V4.1 Flash6.35Mistral Large 46.09Claude Haiku 5.56.05Gemini 4 Argon5.60Grok 4.74.51012345678910平均得分(0–10) GPT-6 Astra8.97 / 10 GPT-6.1 Sol8.65 / 10 Claude Fable 5.28.17 / 10 Claude Opus 5.57.84 / 10 Claude Fable 5.17.50 / 10 Claude Sonnet 5.56.65 / 10 GPT-6 Luna6.38 / 10 DeepSeek V4.1 Flash6.35 / 10 Mistral Large 46.09 / 10 Claude Haiku 5.56.05 / 10 Gemini 4 Argon5.60 / 10 Grok 4.74.51 / 10 GPT-6 Astra得分8.9795% 区间8.30 至 9.52每任务成本$0.693响应时间54 秒工具调用19.3十次 / 零次26 / 2 1我们发布了什么 主动型 agent 是下一个前沿。我们该如何衡量它们? 任何尝试过把 AI 融入自己生活的人都知道,这些模型太爱说话了。它们能捕捉到你忽略的细节,但也会用无关紧要的废话把你淹没。Muse、Grok、Dots 等产品正试图解决这个问题。与此同时,工作中的 agent 正在转向另一种职责:潜伏在工作空间中,观察,并在关键时刻提供帮助。这项职责包含三部分:从对话中从未提及的系统中收集证据,判断是否需要帮助,以及确定由谁、以何种方式接收帮助。 为主动型 agent 选择模型、或自研这类模型的团队,此前几乎没有可参考的依据。他们自己公司的数据过于敏感,无法公开用于基准测试。于是我们搭建了一家公司。PageMantle 是合成的,配备了真实公司运行所需的工具:CRM、产品分析、计费系统、数据仓库、问题跟踪器、文档和 Slack。我们将其全部开源。 现有工作覆盖了其中的部分环节。ProACT 和 MUIR 把“是否参与”的决策与回复质量当作两个独立问题。Toolathlon 注重工具行为。TheAgentCompany 表明,一个自成一体的公司是可行的测试环境。但它们都没有把“发言还是保持沉默”的决策与跨广泛、异构的公司数据足迹的调查结合起来,也没有对帮助应当落在何处——频道、线程还是私信——进行评分。 本版本比较的是模型,而非 harness。每个模型都获得相同的指令、相同的工具、相同的公司快照,以及相同的 180 秒预算。Deepnote 正在构建一个让 agent 与人共同处理数据的工作空间,这正是这个问题对我们重要的原因。 每个模型都以高投入程度对同样的 50 个场景进行了详细阐述。得分取两个 LLM 评估器的平均值,范围 0 到 10,对全部 50 个场景取平均。 Agent Initiative Benchmark 得分与成本、时间、工具调用的关系 当一个模型在更便宜、更快或更精简的方向上都没有对手时,它就处于前沿。阶梯线描绘了这一前沿。 前沿位于前沿被支配 0246810平均得分(0–10)$0.01$0.10$1.00每任务平均成本(美元,对数刻度)Astra 6Sol 6.1Fable 5.2Opus 5.5Fable 5.1Sonnet 5.5Luna 6DeepSeek V4.1 FlashMistral Large 4Haiku 5.5Gemini 4 ArgonGrok 4.7 得分(0–10)。点击某个点或从下方选择模型。 $0.01$0.10$1.00GPT-6 Astra:8.97 / 10GPT-6.1 Sol:8.65 / 10Claude Fable 5.2:8.17 / 10Claude Opus 5.5:7.84 / 10Claude Fable 5.1:7.50 / 10Claude Sonnet 5.5:6.65 / 10GPT-6 Luna:6.38 / 10DeepSeek V4.1 Flash:6.35 / 10Mistral Large 4:6.09 / 10Claude Haiku 5.5:6.05 / 10Gemini 4 Argon:5.60 / 10Grok 4.7:4.51 / 10每任务平均成本(美元,对数刻度) GPT-6 Astra得分8.9795% 区间8.30 至 9.52每任务成本$0.693响应时间54 秒工具调用19.3十次 / 零次26 / 2 1最贵的模型并不是最好的 三个最贵的模型分别排在第三、第四和第五。第二名 GPT-6.1 Sol 每任务成本为 $0.11。GPT-6 Luna($0.007)与 Claude Fable 5.1($3.02)价格相差 430 倍,而在 10 分制得分上仅相差 1.1 分。监控一家公司的 Slack 一个月,用 Sol 花费 $281,用 Fable 5.2 则要 $4,684。 在需要提供帮助时,十次中有九次发出了消息。在应当保持沉默时,十次中只有六次成功按住了消息。对同一个模型而言,不合时宜发言的代价约为保持沉默的 1.8 倍。 GPT-6 Astra(8.97)和 GPT-6.1 Sol(8.65)领先,并同时位于成本、时间和工具调用这三条前沿上。Claude Sonnet 5.5 和 Opus 5.5 在时间和工具调用上与它们并列,回答更快,但得分更低。 Opus 5.5 用 10 次工具调用在 29 秒内作答。Fable 5.2 用两倍的时间做了两倍的调用,得分只高出 4%。Sol 6.1 耗时多出 88%,得分高出 10%,而价格不到 Opus 的十分之一。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。