Hindsight 发布三款智能体记忆模型,决策模型 hs-decide-1-flash 可替代 LLM 做小判断
来源标题:fine tuned decision model for agent memory
Hindsight 发布三款面向智能体记忆的模型,其中决策模型 hs-decide-1-flash 专门处理记忆系统中的小判断,让 LLM 只负责写作。该模型在 7 个 LLM 中的 6 个上给出更好答案,并在 5 个上成本更低。三款模型均开放权重并提供托管服务。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
LLM 负责写,决策模型负责判断。hs-decide-1-flash 接管 Hindsight 内部的细碎判断:七款 LLM 中有六款回答质量更高,五款成本更低。配套的还有一个专为 agent memory 打造的 reranker 和 embedding 模型,开放权重,也有托管版本。
LLM 负责写,决策模型负责判断。AI 应用向 LLM 提出的大部分请求,其实并不是写作,而是一些细碎的判断:这件事是不是新的?这些里面哪些重要?这些够不够?今天我们发布三个专为 agent memory 打造的模型,先从 hs-decide-1-flash 开始——这是一个直接回答这类判断的决策模型,把写作留给 LLM。
Introducing Hindsight Models: Better Agent Memory, for Less 1:17
判断才是大部分工作
记忆系统里到处都是判断。在存储一条记忆和召回它之间,Hindsight 要问:这个事实是新的,还是已经知道了?它是否改变了我们已有的认知?这些记忆里哪些对当前问题是重要的?这些证据足够回答问题吗?这条新记忆会不会改变那个知识页面?
以前 Hindsight 每次都去问 LLM。每个答案都是一次完整的生成调用:数秒延迟、按上下文的每个 token 计费,还要把自由文本解析回一个是或否。在我们的评测中,由决策模型来回答这些判断后,LLM 的调用次数减少了约三分之一:每个案例 3.1 次,而不是 4.5 次。
决策模型正是为这种形态的问题而生的。你给它状态和问题,它返回一个结构化答案:每个选项带概率的选择、刻度上的一个点,或某件事为真的可能性。它不生成文本,所以回答的时间和价格都只是零头。
我们最初用 TypeSafe 的决策模型 Jev 做了尝试,发现 Hindsight 的很多工作从来就不需要 LLM。于是我们基于 Hindsight 实际做出的判断训练了自己的模型:0.8B 参数、开放权重,并使用相同的 System One 请求,因此为一个模型写的应用只要改一下模型名就能跑在另一个上。
Hindsight 在四个环节询问决策模型。没有决策模型时,每个环节都完全照旧运行。
Recall:为你的 agent 省下一笔账单。每次记忆召回的结果最终都会进入你 agent 的 prompt,而对大多数团队来说,agent 自己的 LLM 就是最大的开销。过去 Recall 不管记忆有没有用,都会填满它的 token 预算。有了决策模型,它可以只把能回答问题的内容交给你的 agent:
更少、更相关的记忆意味着 agent 每一轮都消耗更少的 token,也让 agent 少费力气去越过噪声推理。这两项默认关闭;可以按请求开启("rerank": {"prune": true, "dedup": true}),也可以按 bank 开启。Reflect 和页面刷新都会经过 recall 检索,所以它们也能享受到。(Recall 文档)
Reflect:这些证据够吗?Reflect 通过多轮搜索记忆来回答问题。以前每一轮都由一个 LLM agent 来跑:它选一个搜索工具、写一个查询、读遍所有结果,再决定要不要继续搜索。有了决策模型之后:
如果决策模型失败,reflect 会回退到 agent 轮次。
Consolidation:这个事实是新的吗?Consolidation 把新事实转化为 observation,也就是 bank 当前的信念。以前每条新事实都会连同它可能触及的 observation 一起发给 LLM。有了决策模型,它先处理简单的事实,每条事实问一个问题:只是复述某个 observation 的,作为证据挂上去;闲聊则直接跳过——两者都不调用 LLM。只有那些会改变某个 observation 表述的、带来新内容的、或者它拿不准的事实,才会送到 LLM,由 LLM 写出每个 observation 的文本。
知识页面:这会改变页面吗?重建页面会运行 reflect,因此上面说的好处它都有。真正的节省在于用新内容更新页面。以前每次更新都会对新记忆跑一遍 reflect 并重写页面。有了决策模型,它针对每条新记忆问一句:这会改变页面吗?然后只根据这些来编辑页面;当没有任何一条能改变页面时,这次更新完全不调用 LLM。
这里的每一个数字都在 benchmarks.hindsight.vectorize.io 上:这是 Hindsight 自己的系统评测,在 Hindsight 1.2.0 上通过公开 API 对一台全新服务器运行。每个 LLM 都在相同案例上分别单独运行、以及与 hs-decide-1-flash 一起运行,全部由同一个评审 gemini-3.1-flash-lite 打分(它也是被测的七款 LLM 之一,所以它自己那几行是自评)。
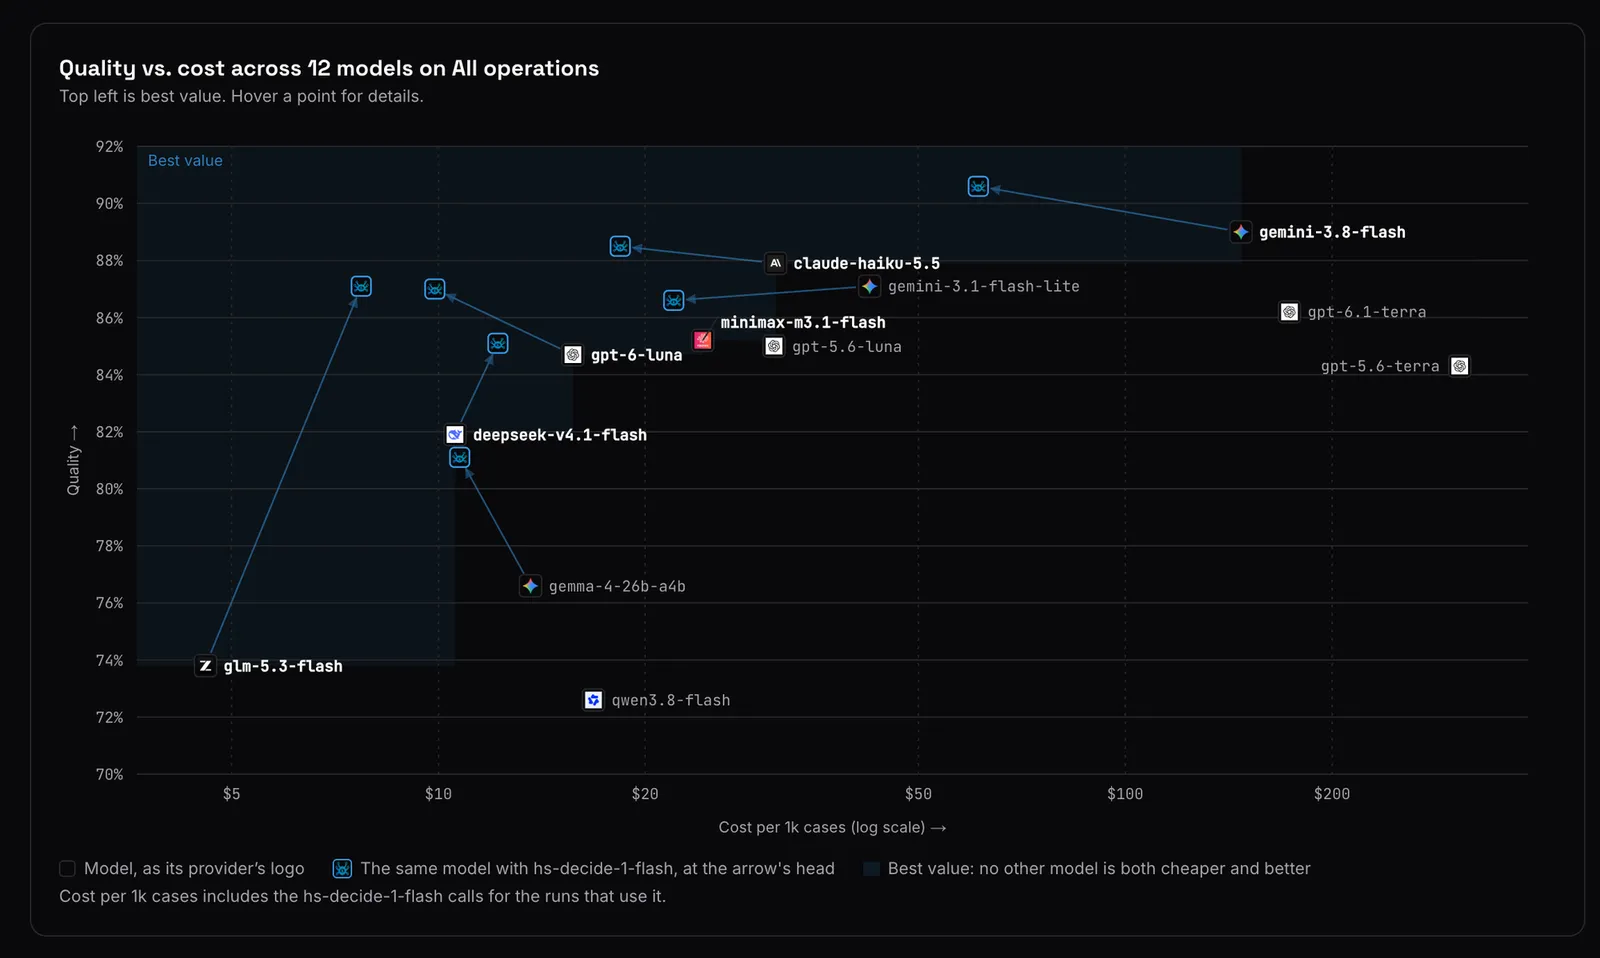
每张图把质量和成本画在一起,每个 LLM 一个点;箭头把一个 LLM 连到带决策模型的同一个 LLM。越靠左上越好。
七款 LLM 中有六款质量上升,提升最大的是最需要提升的那几款(glm-5.3-flash 73.8 → 87.1,gemma-4-26b-a4b 76.6 → 81.1,deepseek-v4.1-flash 81.9 → 85.1),gemini-3.1-flash-lite 则保持持平(87.1 → 86.6)。LLM 的调用次数减少约三分之一,读取的输入 token 减半甚至更少,因此其中五款变得更便宜:gemini-3.8-flash $147 → $61(省 2.4 倍),gemini-3.1-flash-lite $42 → $22,claude-haiku-5.5 $31 → $18,gpt-6-luna $16 → $9.88,gemma-4-26b-a4b $16 → $12。七款模型的模型调用耗时全部下降,从 1.2 倍(gemini-3.1-flash-lite)到 1.9 倍(gemini-3.8-flash)。
Retain 不使用决策模型,所以有没有它成本都一样,而且会拉低上面的总计数字。把它排除在外,只统计 consolidation、reflect 和知识页面这些决策模型参与的操作:在 gemini-3.8-flash 上,它们的成本降低 2.5 倍,模型调用耗时减少 1.9 倍,得分高出 2.2 分。
便宜的 LLM 也能接近前沿配置。glm-5.3-flash 搭配决策模型,每千案例 $7.72 就能拿到 87.1 分;gpt-6-luna 搭配它,$9.88 拿到 87.0 分。gemini-3.8-flash 单独运行是 $147 拿 89.0 分:大约高 2 分,成本却是 15–19 倍。换成更便宜的 LLM 再加上决策模型,是这些结果里最大的节省。
调用更快。决策模型请求的中位耗时是 167 ms(p90 为 350 ms),并且一次性回答关于一个事实或一条记忆的所有问题;它所取代的 LLM 调用,中位耗时在 1 到 7 秒之间,具体取决于模型。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。