开发者发布程序员必知算法可视化综述
来源标题:Algorithms Every Programmer Should Know
开发者 Nick M 发布了一份以可视化为主的算法综述,介绍实际应用中常用的关键算法。文章延续其去年发布的数据结构可视化速查表,从选择排序等基础算法讲起,并注明部分配图来自其他来源。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
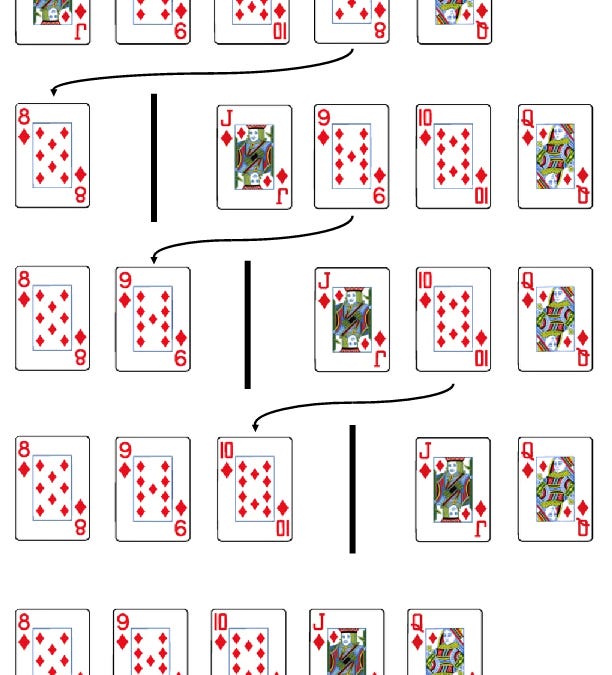
Nick M 2025年3月19日 94 13 分享 在这里,我将以视觉化为主的方式概述一些在现实世界中使用的关键算法。去年,我曾发布过一篇以视觉化为主的关键数据结构概述,你可以在这里找到:Visual Data Structures Cheat Sheet。如果你还没机会看的话——我强烈推荐你去看看。数据以及数据的组织方式,在决定如何高效地解决问题时起着至关重要的作用。一旦你理解了数据,就应该能够顺利地决定如何着手并解决任何问题了。注意到这一点——让我们开始吧。 特别说明:下面提供的一些图示并非由我生成,而是取自其他来源。所有来源都列在参考文献部分。 选择排序 选择排序是一种简单的排序算法,它通过反复找出最小(或最大)元素并将其移动到正确位置,来整理一个未排序的列表。假设我们有一堆卡片,想要按递增顺序排序: 从整叠卡片开始,挑出最小的那张,把它放在左侧(已排序部分的起始位置)。 遍历剩下的卡片,找到下一张最小的卡片,把它移到已排序部分的旁边。每轮操作,左侧的已排序部分就增加一张卡片。 一直这样做,直到未排序的卡片堆里没有卡片为止。 选择排序简单直接,但在大列表上可能很慢,因为它要反复遍历列表来寻找下一个最小项。它最适合小型或接近有序的数据集,因为它的时间复杂度是O(n2)。 你从数组或列表中的第2个元素开始(我们认为第1个元素已经“排好序”了)。 将它与其前面的元素比较,并插入到已排序(前面)元素中的正确位置。 重复这个过程,直到整个数组排好序。 它类似于选择排序,但不是每次都遍历整副牌去找下一个最小(或最大)元素——你只需把左侧的“已排序部分”扩大一张牌,并把新牌移到它的正确位置。不出所料,这种排序算法的时间复杂度是O(n2)。 堆排序使用一种叫做二叉堆的数据结构来组织元素。它类似于选择排序,都是先找到最大元素并把它放到数据结构的末尾。以下是其工作原理的简要说明: 首先,构建一个最大堆(一棵完全二叉树,其中每个父节点都大于其子节点)。这一步将最大元素安排在堆的根部。 将根节点(最大元素)与数组中的最后一个元素交换。然后,将堆的大小减一(忽略最后一个元素),并对根节点进行堆化,以恢复最大堆的性质。 继续将根节点与最后一个未排序元素交换并重新堆化,直到堆的大小减为一。此时,数组已按升序完全排好序。 堆排序的时间复杂度是O(nlog(n))。 一种非常高效的、采用分治策略的算法,由于其平均情况下的性能为O(nlog(n)),在实践中被广泛使用,你可以在这里找到完整的解释。本质上: 你选择一个元素作为基准值(pivot)。 将所有小于基准值的元素放在左边,所有大于基准值的元素放在右边。 对左右两个子数组递归地应用同样的过程,直到整个数组排好序。 快速排序的时间复杂度是O(nlog(n))。 这与快速排序非常相似,但没有基准值元素,并且是稳定的。关于该算法的完整概述可以在这里找到。要执行归并排序: 递归地将数组分成两半,直到每个子数组只包含一个元素。 合并这些子数组,并在合并时对它们进行排序。 继续合并,直到整个数组排好序。 归并排序的时间复杂度是O(nlog(n))。当你需要一个稳定的排序算法、处理链表,或者对可能无法完全载入内存的大型数据集进行排序(外部排序)时,请使用归并排序;而对于大多数内存中的排序场景,通常更倾向于使用快速排序,因为它的平均性能更快、空间复杂度更低,尤其是在处理随机数据时。 Tim sort是一种混合排序算法,结合了归并排序和插入排序。它被设计为在处理现实世界的数据时保持高效,尤其是那些已经部分有序的数据。以下是其工作原理的分解说明: 划分数组:它将数据划分为称为run的小块。每个run使用插入排序进行排序,插入排序对于小型、接近有序的片段来说很快。 合并run:然后将排好序的run以类似于归并排序的方式合并在一起,形成越来越大的有序部分,直到整个数组排好序。 Tim sort针对实际使用进行了优化,是Python和Java等语言中的默认排序算法。不出所料,其时间复杂度为O(n*log(n))。你可以在这里找到一篇极好的概述:Understanding Timsort。 二分查找 一种快速的搜索算法,适用于已排序的数组,时间复杂度为O(log(n))。它因其简单和快速而被广泛使用,其工作原理是不断将搜索空间对半划分。可以把它想象成在字典的中点处翻开,判断我们要查找的词是在左边(小于中间元素)还是右边(大于中间元素),然后不断地重新打开我们新的搜索(或页面)空间。关于该算法的完整概述可在这里找到。 深度优先搜索(DFS)和广度优先搜索(BFS) 这些是基本的图遍历算法,用于网络、寻路和人工智能领域。广度优先搜索会先探索当前“深度”层级的所有节点,然后再移动到下一深度层级的节点。深度优先搜索则会沿着一条分支尽可能深入探索,然后回溯去探索其他分支。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。