Meta用ML系统智能分配算力,广告排序性能提升约10%
来源标题:Intelligent Delivery: Making Every Unit of Compute Serve Better Ads
Meta构建了ML驱动的Intelligent Delivery系统,在服务栈中动态分配算力资源以逼近系统全局最优,自2017年以来在模型与系统改进的基础上额外带来约10%的排序性能提升。该系统通过预测算力的边际效用、多层资源调度机制,并日益借助agentic AI持续检测和响应系统变化。
以下正文由 AI 翻译自 Meta Engineering(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
- 广告排序模型正朝着 LLM 规模快速增长,而运行它们的硬件却跟不上这一速度。额外的一单位算力,对某些广告请求、模型和芯片的影响要大于对其他请求、模型和芯片的影响。难点在于决定把这单位算力分配到哪里,才能让整个系统获得最佳结果。
- 我们构建了 Intelligent Delivery,这是一个由 ML 驱动的系统,它在整个服务栈中分配资源,以逼近系统级最优。自 2017 年以来,它在模型和系统进步的基础上,额外带来了约 10% 的排序性能提升。
- 我们分享 Intelligent Delivery 的几项能力:我们如何构建 ML 模型来预测算力的边际效用,在系统中移动资源的多层机制,以及我们如何越来越多地利用 agentic AI 来持续检测并响应系统变化。
随着前沿广告排序系统朝着更大的模型、更广的候选集和更丰富的投放架构演进,它们对服务效率也提出了更高的要求。算力资源的增长速度跟不上模型和系统复杂度的增长速度。挑战不仅在于如何构建更强大的模型,还在于如何在异构系统中、在有限的服务容量下、在紧张的延迟预算内高效地运行它们。我们最近分享了如何让闲置的推理容量发挥作用。本文介绍我们如何决定每一单位算力该去向何处,以实现全局最优的系统效率。
Intelligent Delivery 是我们应对这一问题的方案。从 2017 年到 2026 年上半年,它在模型和系统进步的基础上,为各大流量场景的广告排序性能额外贡献了约 10% 的提升。它引入了一个由 ML 驱动、日益由 AI 操作的自适应优化层,持续将资源导向边际效用最高的请求、模型、硬件集群和排序阶段。这帮助我们高效地在生产环境中运行先进的广告排序模型,让每一单位算力发挥更大作用,为使用我们应用和服务的用户提供更好的广告。
目标与难点所在
我们的目标之一是构建一个投放系统,无论用户行为如何变化、模型如何演进、服务栈如何变得日益复杂,它都能持续收敛到全局最优。
广告投放系统的三个基本特性使这一目标颇具挑战:
算力的边际影响高度异质且依赖上下文:同样一单位额外算力,可能因产品场景、用户意图、候选质量和系统状态的不同而产生截然不同的回报。仅靠请求感知信号并不足够;要做好分配,意味着对每个请求估算每一个可调系统参数的回报,而每个参数在漏斗的每个阶段表现都不同。我们需要在毫秒内,在庞大的决策空间中为每个请求完成结果计算。
局部最优并不等于全局最优:结果估算只是起点;服务栈还必须可动态控制。广告投放横跨多阶段排序、数百个模型、多代硬件和众多数据中心。如果没有能够考虑整个栈中复杂依赖关系的自适应控制,资源就无法在这些边界之间自由而可靠地移动。
全局最优是一个移动的目标:优化景观在不断变化。每一个新模型、新一代硬件或新架构都会改变这一景观,并可能使此前的最优分配决策失效。系统需要足够快地适应,以保持其最优性。
Intelligent Delivery 包含三项能力,每一项都旨在应对上述一个基本系统挑战。
Intelligent Delivery 的能力
1. 请求理解:面向算力的共享 ML 智能层
有些广告请求比其他请求更能从额外计算中获益。最初,我们通过粗粒度分群来捕捉这些差异:按场景、上下文和广告创意表征等属性对请求分组,由工程师为每个分组制定资源分配策略。这种方法带来了改进,但无法扩展。每增加一个新信号,规则就成倍增加,使这项工作难以为继;而且相互独立的分群无法捕捉数千个信号之间的非线性交互,限制了准确性。
我们将这一问题重新表述为两个 ML 问题:哪些广告请求最有可能从额外算力中获益?不同的资源配置会如何影响它们的结果和投放性能?在主要场景的离线基准测试中,与之前的生产模型相比,我们在识别高影响力广告请求方面取得了约 20% 的提升。
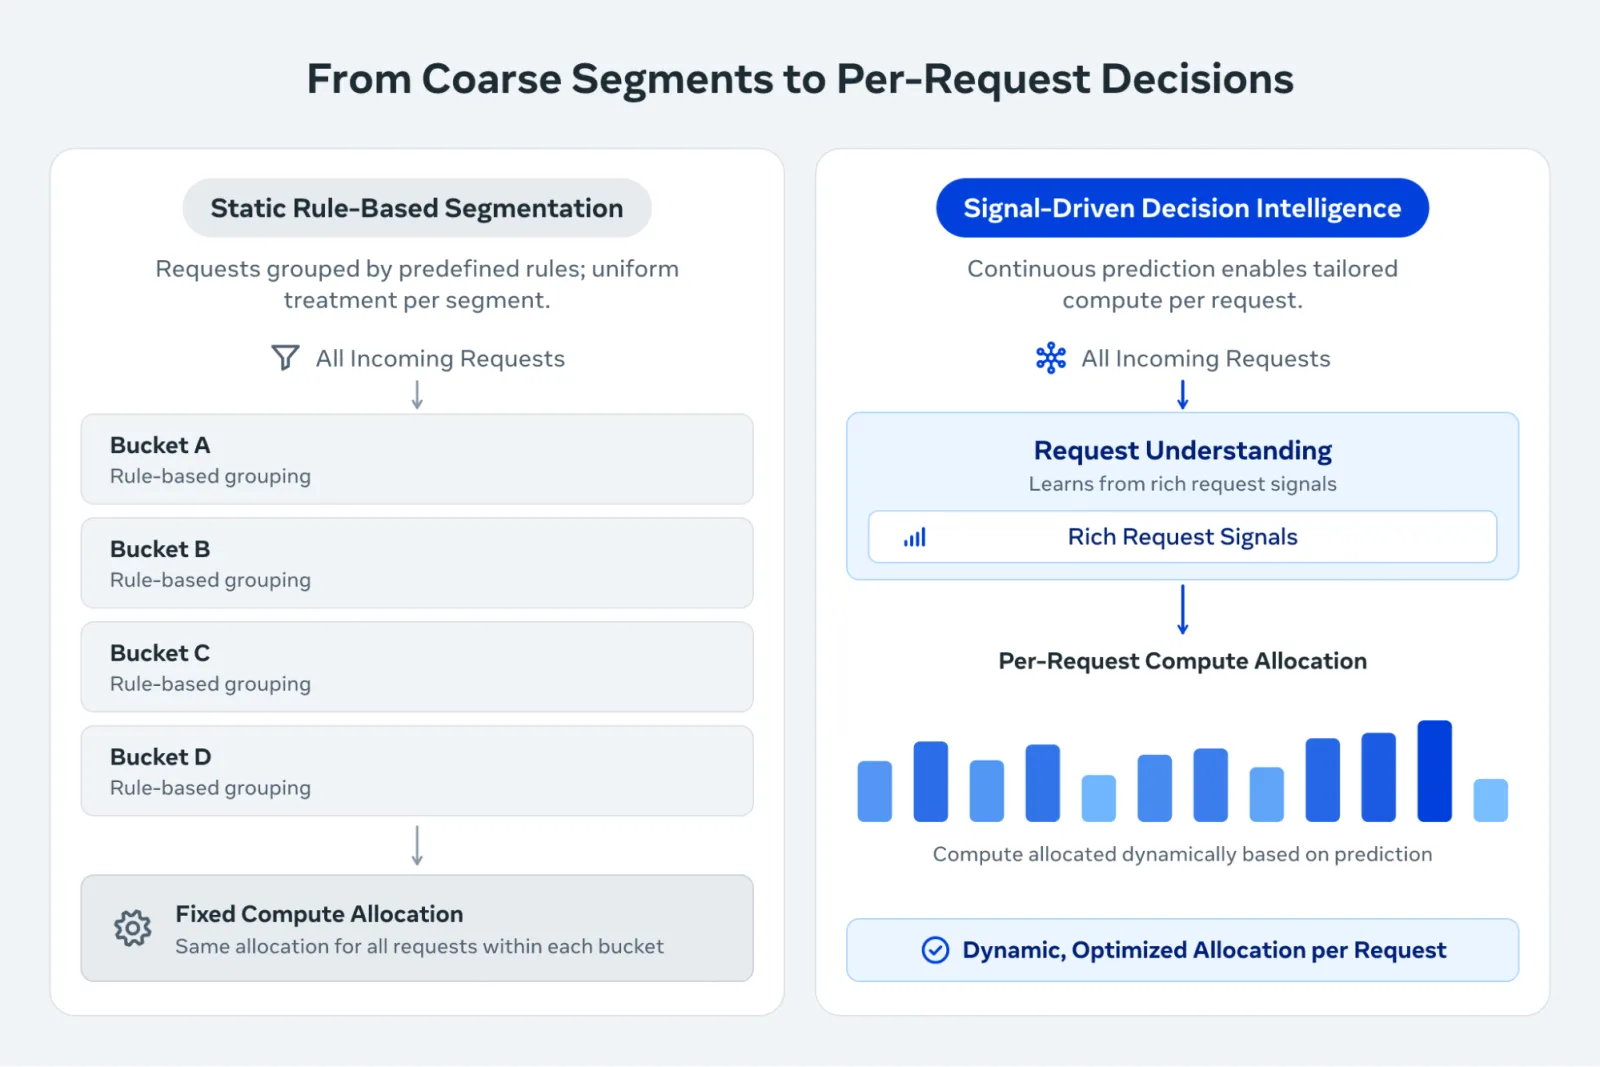
下图并排对比了静态的基于规则的分群(同一分桶中的每个请求获得相同算力)与信号驱动的决策(由 ML 驱动的预测器为每个请求设定算力)。
为了回答第一个问题,我们构建了 Resource Core Model——具有 60 亿稀疏参数和 2000 万稠密参数的深度学习模型,它在候选召回之前运行一次,并在整个投放漏斗中共享。学习到的 embedding 和深层特征交互能够捕捉人工定义分群无法捕捉的细微请求模式。
随后,我们将 Resource Core Model 微调为一组专用模型,每个模型生成关于结果、算力消耗和延迟影响的增量信号。它们共同构成了一个用于资源分配的共享 ML 智能层:Resource Core Model 理解每个请求及其投放行为,而各个机制则决定如何将这些预测转化为行动。
下图是 Resource Core Model 的架构图,展示了稠密和稀疏请求特征如何经过堆叠的交互层,以预测每个请求的结果、算力消耗和延迟影响。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。