Sebastian Raschka 撰文详解现代 LLM 的位置嵌入机制
来源标题:Understanding Positional Embeddings in Modern LLMs
Sebastian Raschka 发表文章,系统讲解大语言模型如何编码和处理 token 位置信息,涵盖 RoPE 等经典与现代方法,并附可视化示例、数学推导和一个小型 PyTorch 实现。文章还梳理了 2026 年开放权重模型采用的位置编码方案,并讨论了现代架构如何调整或省略显式位置编码。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
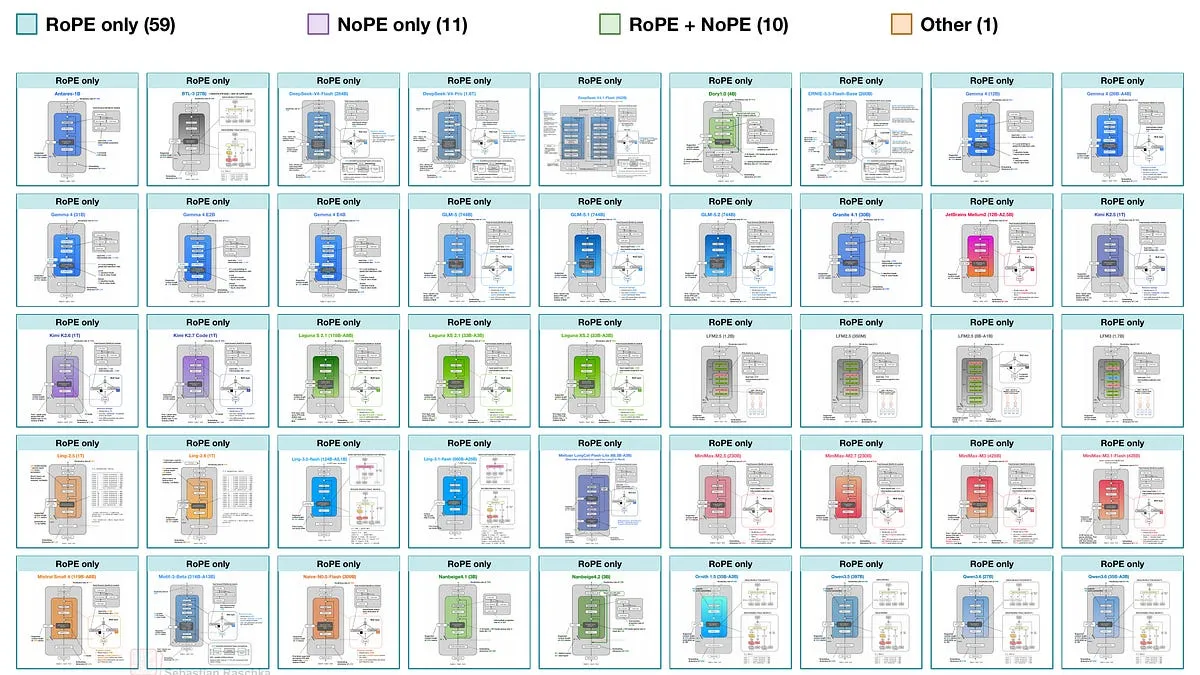
Sebastian Raschka 博士 2026年11月15日 15 1 分享 本文通过介绍 RoPE 等经典与当代方法,解释大语言模型如何编码和处理 token 位置信息。这本质上是一段全面的旅程:我们会借助可视化示例、少量数学推导和一个小型 PyTorch 实现,逐一梳理这些机制。当然,最后我们还会看看现代架构如何适配或省略显式位置编码。 下面你可以看到 2026 年开放权重模型采用了哪些位置嵌入方案的预览。我们会在介绍完底层机制之后再讨论这些选择。 图 1:2026 年架构图库预览,按位置编码分组。架构图取自我的 LLM 图库。 但为什么要花这么多时间写/读这个相对次要的构件呢?大语言模型一直在演进,而在我准备今年最新 LLM 架构趋势的新文章时,我意识到自己至今从未在任何文章中介绍过 LLM 所使用的位置信息方法。所以,与其让另一篇文章变得过于庞杂,我觉得把它作为一篇独立的基础构件文章发布,为即将到来的 LLM 架构与趋势分析做铺垫,可能更合理。 另外,多年来许多读者一直希望我写一篇关于相对位置嵌入(即 RoPE)的教程,作为对 GPT 中所用可学习绝对嵌入的后续补充。这件事在我的 TODO 清单上挂了很久,所以我终于翻出旧草稿,整理出了这篇详解,内容涵盖 近期开放 LLM 使用了哪些方法。 请注意,本文假定读者对基础 LLM 架构有一定了解,很适合作为《Build a Large Language Model (From Scratch)》的后续阅读。如果对注意力内部机制的概念和计算——尤其是 query、key 和 value 向量——还有些模糊,我建议先看看我的自注意力详解作为复习: 理解并编码 LLM 中的自注意力、多头注意力、因果注意力和交叉注意力 2024年1月14日 阅读全文 本文技术性也很强,对一些人来说可能过于详细。不过,我确实希望把这一基础内容发布出来,供今后的文章引用。别担心,下一篇会回到更轻松的風格。 附言:我开始尝试 Substack 新的“perks”系统。作为对支持者的感谢,我已添加了架构图库的图片导出和元数据,供你在自己的分析中使用。 附附言:如果你已经熟悉位置嵌入的工作原理,可以直接跳到第 6 节“现代架构中的位置选择”。 请注意,本文在网页浏览器中阅读可能比在邮件客户端中更好。我推荐查看网页版,左侧还带有导航栏。 让我们从整体架构开始。分词器将输入文本编码为 token ID。接着,LLM 的输入 token 嵌入层将每个 ID 映射为一个数值向量。我们通常把该向量中的这些条目称为“特征”(类似于经典机器学习)。LLM 内部的 transformer 块随后通过注意力和前馈层修改这些向量。最后,模型的输出层为下一个 token 生成 logit 分数(转换为概率)。 下图展示了这一路径在 GPT-2(一个相对经典的 LLM)和 MiniMax-M3(今年发布的一个较新 LLM;可代表大多数其他近期 LLM)中的情况。可以看到,这些架构彼此差别不大,但在进入位置信息部分之前,我们先关注橙色块(token 嵌入层)及其上方的 transformer 块;其他架构差异在本说明中并不需要。 图 2:GPT-2 和 MiniMax-M3 中的 token 嵌入层,以橙色高亮。(旁注:M3 的 60 个前馈层中前三个是稠密层而非 MoE。) 如上图所示,token 嵌入层将每个 token ID 映射为一个向量。位置信息随后被添加。具体来说,正如我们稍后会详细讨论的,GPT-2 在修改后的嵌入进入第一个 transformer 块之前,为每个 token 嵌入加上一个位置向量。另一方面,MiniMax-M3 则在每个 transformer 块内部,通过注意力中一种称为 RoPE 的方法添加位置信息。 我们稍后会详细讨论这些方法,但首先让我们从宏观图景开始,解释为什么需要添加或需要显式位置信息。 以下面两个输入句子作为简单示例: 改变词序会改变是哪只狐狸在跳,如下图所示。 图 3:改变词序会改变哪只狐狸在跳。 为简化起见,本文中的示例将每个词视为一个 token。(如你所知,真实的分词器会将词拆分为更小的子词 token。)那么第一个句子有八个 token 位置,从 0 到 7。 图 4:玩具句子中的 token ID 和位置。
假设以下小词汇表。
真实词汇表通常有 5 万到 20 万个条目
vocab = { "The": 0, "red": 1, "fox": 2, "jumps": 3, "gray": 4, "over": 5, "the": 6, (如果你对词汇表如何构建感兴趣,可以查看我 GitHub 上的分词器资料。) 请注意,输入句子中出现两次的“fox”在两种情况下都得到相同的 token ID 2。而由于它们具有相同的 token ID,与在输入句子中的位置无关,它们会从嵌入层得到相同的嵌入向量。 现在,考虑一个没有位置编码(也没有因果掩码)的常规自注意力机制,其中每个输入 token 都可以关注输入中的其他所有 token。在这种情况下,交换任意两个词,比如“red”和“gray”,每个 token 对之间的嵌入和注意力分数仍然相同。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。