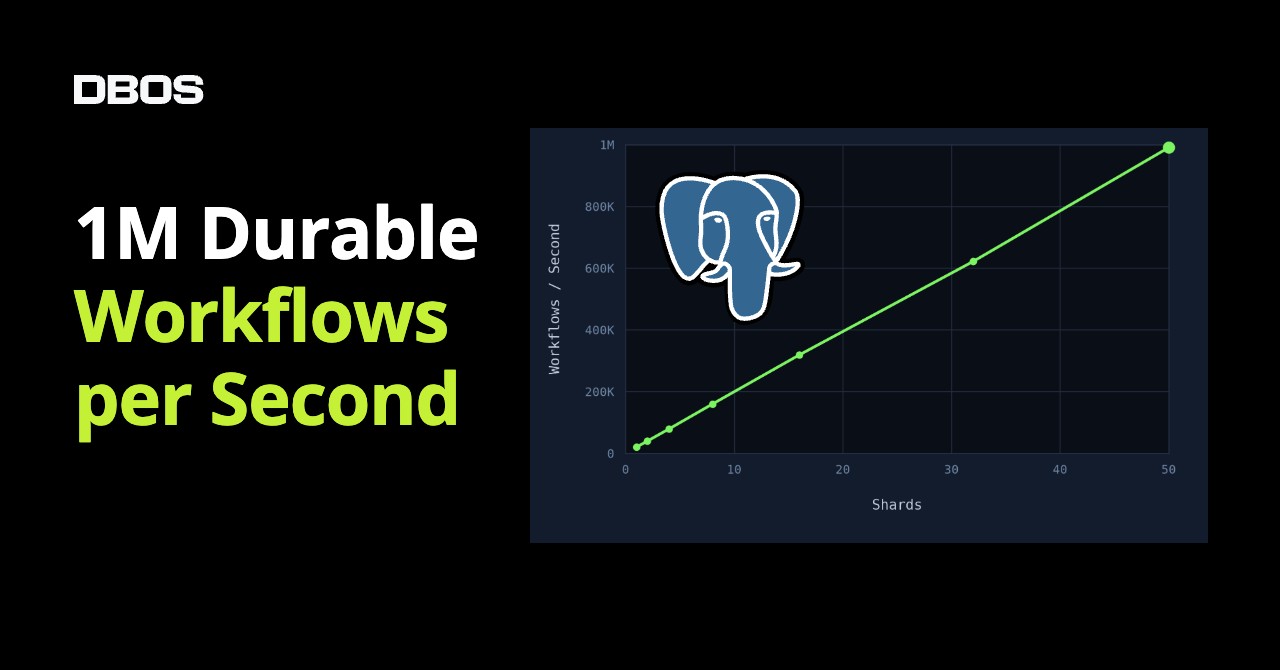
Postgres 通过分片实现每秒百万级持久化工作流
来源标题:Postgres can handle 1M durable workflows per second
基于 Postgres 的持久化工作流引擎通过分片可将吞吐量线性扩展至每秒超过 100 万个工作流。单台 Postgres 服务器可处理每秒 2 万个工作流,使用 50 台服务器分片后达到每秒 100 万个。该方案使用 PgDog 进行分片,但其他分片引擎也可实现类似效果。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在基于 Postgres 构建持久化工作流引擎时,我们最常被问到的问题之一就是“Postgres 能横向扩展吗?”关于这个话题,已经有不少博客文章(包括我们自己的),事到如今再强调“单个 Postgres 数据库就能撑得很远,每秒处理数万次操作”已经没什么新意了。但如果你想更进一步呢?如果你的工作负载超出了单个数据库的处理能力,也许需要每秒数十万甚至数百万次操作呢?Postgres 还能扩展吗?在这篇博客中,我们将展示如何将基于 Postgres 的工作流扩展到每秒超过 100 万个工作流。
我们先从好消息开始:结果。通过对持久化工作流进行分片(使用 PgDog,但用任何分片引擎都能达到类似效果),我们将持久化工作流的吞吐量从单台 Postgres 服务器的每秒 2 万个工作流线性扩展到 50 台 Postgres 服务器的每秒 100 万个工作流:
由于 Postgres 是单节点数据库,要扩展到每秒超过 100 万个工作流(远远超出单台服务器的容量,无论服务器多大),唯一的办法就是分片。分片是一种水平扩展单节点数据库的技术,它将工作负载分布到多台数据库服务器(称为“分片”)上。有很多流行的分片引擎:我们使用 PgDog,因为它轻量且开源;其他 Postgres 引擎包括 Citus、Neki 和 Multigres,而最流行的分片引擎大概是用于 MySQL 的 Vitess。
分片引擎之所以强大,是因为它们将工作负载分布到多台服务器上,但对用户呈现的是操作单个数据库的抽象。为了实现这一点,用户为每张表选择一个“分片键”列。分片引擎按分片键对每张表进行分区,在每个分片上创建每张表的一个实例,并根据分片键将数据项分配到各个分片。具有相同分片键的数据项始终被分配到同一个分片,而具有不同分片键的数据项可能存储在不同的分片上。从高层来看,分片是这样的:
分片引擎的核心是一个路由器,它解析查询并将它们分发到相应的分片。如果查询只需要来自单个分片的数据(例如指定了单个分片键值的 SELECT 查询),那很简单:引擎将查询路由到该单个分片并返回其响应。如果查询需要来自多个分片的数据(例如未指定分片键的聚合),那就更难了:引擎必须构建一个分布式查询计划,从所有这些分片检索数据,然后合并它们的响应。
要使分片工作负载的性能线性扩展,我们必须确保每个查询都能由单个分片处理。否则,分片之间的协调会限制性能。因此,为了对工作流进行分片,我们在主 workflow_status 表以及所有依赖表(例如描述每个工作流步骤的 workflow_steps)中都添加了一个 shard_key 列。这样,关于单个工作流的所有信息都存储在单个分片上,对单个工作流执行的所有操作(例如将其入队、记录步骤检查点或向其发送消息)都可以由单个分片处理。同样,我们按分片出队工作流:每个进程不是一次性从所有分片出队工作流,而是遍历所有分片,一次从一个分片出队工作流。
当我们最初测试分片工作流时,发现超过某个点(大约 8-16 个分片,即每秒约 20 万个工作流)后,性能处于亚稳态:它最初看起来会线性扩展,但如果任何分片受到任何扰动(例如一次大型 VACUUM 短暂拖慢了某个分片),集群范围的性能就会崩溃并且永远无法恢复。
这种亚稳态的原因是出队工作流中的负反馈循环。查找要出队的工作流的查询如下面的 SQL 所示。每个进程定期轮询每个队列和分片,在该队列和分片上找到一定数量(由流控决定)符合条件的已入队工作流并出队。为了最小化工作进程之间的争用,该查询使用了锁定子句(FOR UPDATE SKIP LOCKED),锁定它选择的工作流,并选择队列中第一批未锁定的工作流。
这个查询的问题在于,在高进程数下它容易受到负反馈循环的影响。假设某个事件(例如一次大型 VACUUM)导致某个分片暂时变慢,使得每个出队查询耗时更长。由于每个出队查询耗时更长,更多进程同时尝试从该分片出队。问题在于,如果有更多进程尝试从某个分片出队,该分片上的查询就会耗时更长(由于锁争用,较早的查询持有锁,因此较新的查询必须向前搜索才能找到未锁定的工作流)。这个循环不断自我强化,直到数百万行被每个耗时数秒的查询锁定,导致性能崩溃。
为了解决这个问题(以及其他类似问题),我们必须通过限制对单个分片的并发访问来阻止负反馈循环。我们使用 Postgres 咨询锁来实现这一点。每个分片有少量“出队锁”。要从该分片出队,进程必须获得其中一个锁。如果它无法获得锁,它不会等待,而是转向下一个分片并尝试从那里出队。这种设计防止单个分片被压垮,打破了反馈循环,并允许稳定扩展到每秒 100 万个工作流。
如果你喜欢构建可扩展、可靠的系统,我们很乐意听到你的消息。在 DBOS,我们的目标是让基于 Postgres 的持久化执行尽可能简单和高效。来看看吧:
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。