研究者用影子艺术比喻解释大语言模型内部计算机制
来源标题:Understanding LLMs by seeing language as a shadow of a higher-dimensional state
一种将语言视为高维状态投影“影子”的心智模型,被用来解释大语言模型如何在提示与回复之间进行计算。该解释借鉴计算影子艺术与光学分束、投影等概念,帮助理解模型内部机制,并延伸出模型如何拆分到多设备上的问题。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
把语言看作高维状态的影子,以此理解 LLM
说一个语言模型“预测下一个 token”,描述的是它的训练目标,而不是它的内部机制。说它“是一大堆矩阵乘法”,技术上没错,但这就好比把餐厅定义成“碳化合物在其中改变温度的建筑物”一样,信息量约等于零。
要理解网络在提示与回复之间究竟发生了什么,我们需要一个更好的心智模型——一个让你不会被层数、浮点坐标或抽象高维空间搞晕的模型。
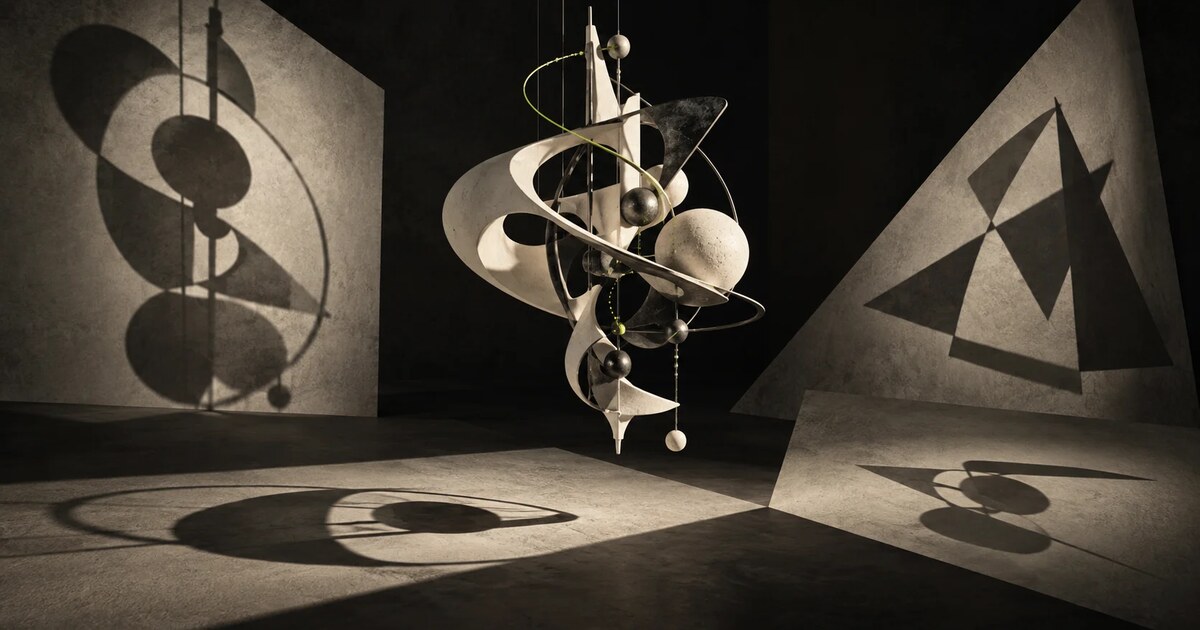
我找到的最容易想象这件事的方式,是借助计算阴影艺术(computational shadow art),以及分束器、投影和表示变换这类光学概念。
这幅图景也帮我们看清了这个思路会引向哪里:一旦理解了模型内部的计算,我们能把这些计算切分得多细、分散到多少设备上?我在《一个 AI 模型最小能切到多小?》一文中探讨了这个问题。
2009 年,Niloy J. Mitra 和 Mark Pauly 发表了 Shadow Art。他们的算法搜索一个单一雕塑,使其能投射出若干指定的剪影。单看这个物体本身,它可能像一块非常可疑的塑料。
从这件物体开始。从一个光照方向看,它的影子是一头公牛。从另一个方向看,是一个带翅膀的生物。从第三个方向看,是一只鹰。物体不动,墙上的图像却变了。
这就是计算阴影艺术。在 2009 年的这项工作中,你指定剪影和投影方向,算法则搜索出一个与之兼容的雕塑。有些请求会相互冲突:为一个影子所需的材料会妨碍另一个影子。该方法会调整目标,使几何形状成为可能。
显然,连一块塑料都得协调相互冲突的需求。
然后是 Mojoptix 的数字日晷。随着太阳移动,精心排列的通道让光线穿过,在其阴影内形成不断变化的数字。没有电池。没有屏幕。一个显示器驱动是地球自转的时钟。
这给了我们一种想象这个计算阴影艺术框架的方式,让你永远不会搞混:承载信息的底层表示,比我们从它那里读出的任何单一视图或词语都要丰富。可以把它想象成光学:分束器接收一束入射光,将其分路或路由到多条路径;而投影则把一个高维状态降到一个平面上。在语言模型中,内部的隐藏状态就是那件 3D 雕塑;我们读出的词表概率,只是投射到墙上的一种投影或影子。
探索心智的研究者发现,光学是思考信息如何变成体验的一条富有成果的途径。例如,Andrés Gómez-Emilsson 通过非线性光学、分束器和相互作用的投影来探索这一点。他的工作帮我看到了一个联系:transformer 块同样在组合和变换信息,让一个不断演化的状态经过一系列学到的运算。
如果你理解了上面的阴影艺术概念,那基本上就是 LLM 在底层运作的方式。正如我与 Gemini 对话中的一句话所说:
人类语言只是一个复杂高维计算图在网络各层内部执行时,序列化、有损的输出格式。
现在把这个比喻加上运动。语言模型不只投射一个静态的影子。我们想象为雕塑的那个东西,会随着信息流经网络而不断变形。
在 DeepSeek-R1-Distill-Qwen-7B——我当时试图适配的那个模型——中,28 个 transformer 块按顺序运行。在处理提示时,模型为每个 token 位置(token 可以是单个词或词的一部分)携带一个动态隐藏状态。在数学上,每个状态只是一个向量——由一列坐标描述的一个点。
其公开配置给每个状态 3,584 个坐标。因此,一个 512 token 的提示就是由 512 个点组成的星座,每个点分布在 3,584 条轴上。
这和前面的阴影艺术是完全相同的概念——只是放大了规模。不再是 3D 实体雕塑在墙上投射 2D 剪影,而是想象一个存在于 3,584 维空间中的超高维几何对象。随着计算展开,不同的组件和线性投影就像方向光源,把这个复杂高维几何体的“影子”投射到更低维的子空间和区域中。
“高维”并不意味着宇宙背后某个神秘的领域;它只是意味着同时跟踪那么多坐标。雕塑是我们用于可视化的桥梁,为人类大脑无法直接想象的数学投影赋予物理形态。
它们共享相同的工作区宽度,但每个块都有自己学到的工具。在块的边界处,每个 token 状态有 3,584 个值。query、key、value 和 MLP 权重在不同块之间不同;这些视图未必意味着相同的东西。
块内部的空间也可以有不同的宽度。这个模型的 MLP 会扩展到 18,944 个值,然后再回到 3,584。它内置的词表读出在堆叠之后进行,产生 152,064 个分数。这些宽度来自公开配置。“影子”是一个类比,因此并不存在一个适用于每个组件的字面影子数量。
这些图景有不同的存储成本。在一个块边界处统计存储的数值,忽略批次:
这里 d 是隐藏宽度。transformer 对它接收到的状态求值学到的函数;它并不会在该空间的每一个可能点上都存储一个向量。权重、注意力中间结果以及缓存的 key 和 value 还有额外成本。在带缓存的生成过程中,模型通常使用已保存的 key 和 value 来计算新位置,而不是重新计算之前的每个位置。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。