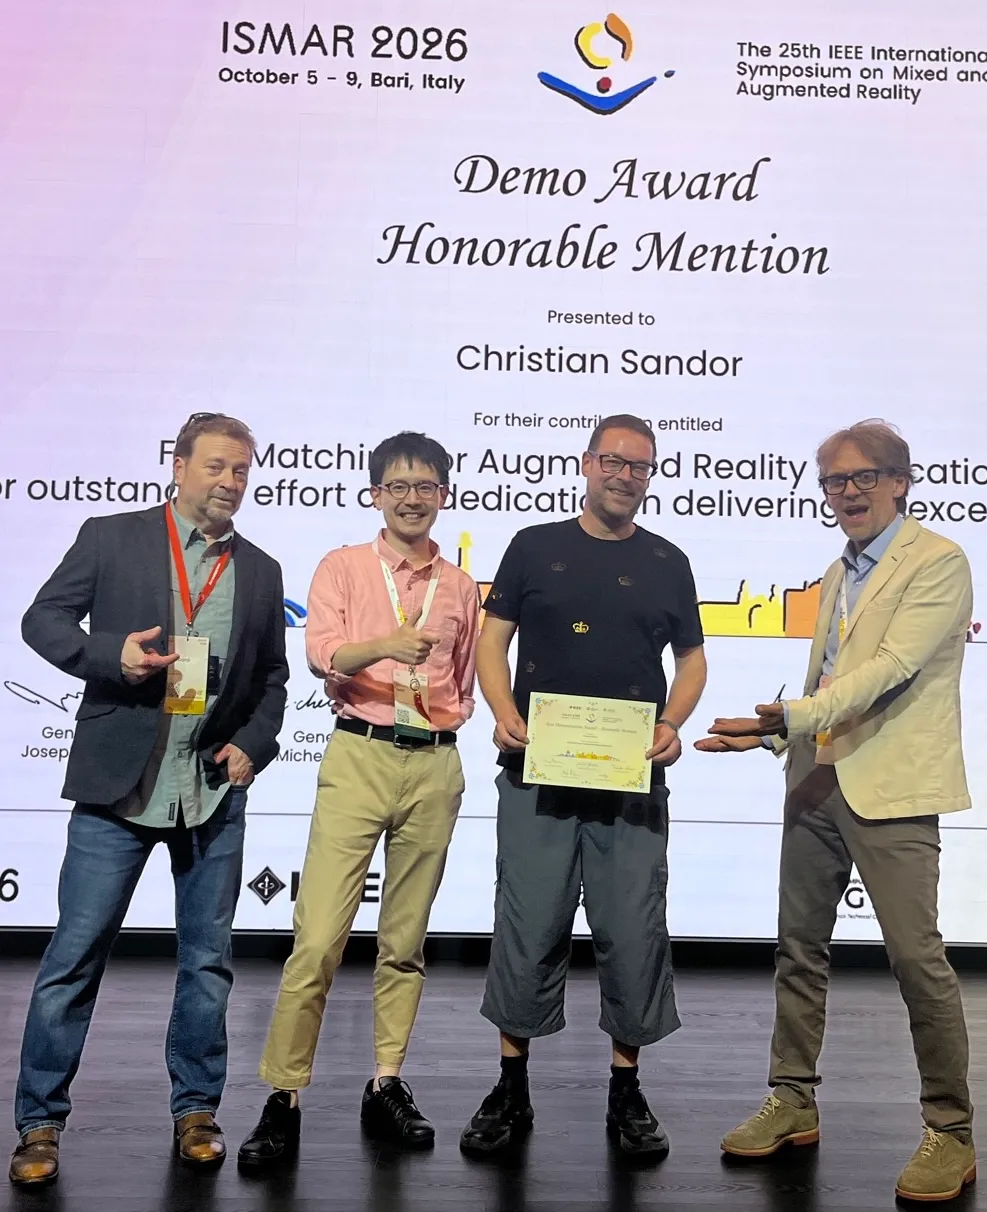
研究者凭Flow Matching驱动的AR实时流编辑演示获ISMAR最佳演示荣誉提名
来源标题:Real-time prompt-based stream editing for AR at 1080p, 46 FPS and 87 ms latency
在意大利巴里举行的IEEE ISMAR上,一位研究者凭"Flow Matching for Augmented Reality Applications"演示获得最佳演示奖(荣誉提名)。该演示支持基于提示的实时流编辑,在1080p下达到46 FPS、87毫秒延迟。研究者认为Diffusion Models是AR场景中比Gaussian Splatting和NeRF更可行的替代方案。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在意大利巴里举行的国际混合与增强现实研讨会(IEEE ISMAR)上,我凭借“面向增强现实应用的流匹配”获得了最佳演示奖(荣誉提名)。
在这篇文章中,我首先介绍该演示的能力与局限。其次,我解释我是如何做出它的;我相信这对其他从业者会有帮助!
AR 和 VR 社区的许多研究者正在研究使用 Gaussian Splatting 和 Neural Radiance Fields 进行渲染。我认为这些技术对于 VR 和纯计算机图形学来说没问题,但对于 AR 来说是完全错误的。这是该演示的主要动机之一:证明 Diffusion Models 是一种值得认真考虑的可行替代方案。
快速了解高层故事的最快方式是观看这个 1 分钟的解释视频:
在会议上,我录制了笔记本电脑的屏幕,当时有几位参会者正在试玩这个演示(按出场顺序:Ke Li、Doron Friedman、Xinyi Ye、Huyen Nguyen 和 Yingfangzhong Sun):
不幸的是,屏幕录制在 720p 下只有 7 FPS 🤦🤦。为了更接近实际渲染性能,我使用 FILM 帧插值模型进行了后处理以达到 30 FPS,这导致了实际演示中并不存在的融化伪影。
还有一些可见的缺陷是我这条流水线固有的:
我和我的一位博士导师 Steven Feiner 一起玩得非常开心。愚蠢的是,我只捕获了输出,却没有捕获输入 🤦。我使用 Qwen-Image-2.1 重建了“之前”的帧。
Steve Feiner,之前与之后:左图是原始帧的 AI 重建;右图是实时 AI 滤镜,把他变成了绿巨人。
如果没有阿里巴巴集团和 Z.ai 慷慨捐赠给公众的中国开放权重模型,这个演示几乎不可能实现。谢谢!由于下文会变得明显的原因,像 Anthropic 或 OpenAI 这样的闭源模型在合理的财务或时间预算内是不可行的——对于我采用的方法来说,它们实在太慢、太贵了!
作为法国研究人员最大的福利之一,就是可以使用我们的 DALIA GPU 巨兽,它拥有 64 块 NVIDIA GB200 GPU。对于较轻的任务,我使用了较旧的 Jean-Zay,它有 1456 块 H100 GPU。我估计我为开发这个演示使用了相当于 1000 个 GB200 小时的算力。
最后一个关键要素是 Andrej Karpathy 的 autoresearch,它将经典的自动参数搜索思想转换到了代码空间。我在开发演示时在多个抽象层次上使用了这一机制。
我的开发栈从底到顶的总结是:
让我们花点时间看看这个栈中最基础的部分:所使用的 LLM 及其性能。在速度方面,我可以以大约比 OpenAI 模型快 10 倍、比 Anthropic 模型快 5 倍的速度使用领先的开放权重模型:
输出 tokens/s 的解码吞吐量(越高越好):我们在 GB200 节点上单用户运行的中位数,对比 Artificial Analysis 发布的闭源 API 模型(max-effort 变体,检索于 2026-10-21)。
该演示的主要 autoresearch 循环连续运行了大约 1 个月。一个慢 10 倍的模型(例如 Anthropic 的 Fable)根本不可行。但是等等!闭源模型不是更聪明吗?确实,它们是:
速度与智能:解码吞吐量对比 Artificial Analysis Intelligence Index v4.3.2(max/xhigh 变体,检索于 2026-10-21)。
一个需要智能指数超过 50 的问题,会导致开放权重模型高速空转却永远无法解决!令我非常高兴的是,我还没有遇到过这样的问题。
为了攻克具有挑战性的性能问题,我针对推理流水线的各个组件(DIT、VAE、Upscalers)以及整个系统运行了 autoresearch 循环。关键指令包括:
一些最具影响力的优化发生在架构层面,例如跨 GPU 流水线并行:
智能体在 NVIDIA 的 TensorRT for Blackwell 中发现了数量惊人的 bug。例如,见上图,在我的演示分辨率下无法使用 TensorRT(TRT)进行 VAE 编码/解码(它只对较小的分辨率有效);所以我们不得不退回到慢得多的 torch 实现。幸运的是,DIT、RIFE 和 ESRGAN 组件可以正常使用它 ;-)
在巴里搭建演示
为适应不稳定的会议网络做最后调整
我仍在努力完全消化这段开发经历!这无疑与我 31 年编程生涯中所做过的任何事情都非常不同!
接下来是什么?这是一个我需要深入思考的大问题。对我来说唯一已经清楚的是,下一个实验将使用大约 10 倍的算力 :-)
你可以在提交给 ISMAR 的演示描述(2 页 pdf)中找到关于该演示的更多信息。请注意,性能数字已经过时(提交后我又在演示上工作了几周)。
对增强现实、人工智能和人类感知感兴趣
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。