Ramez Naam:AI自我改进需增强5至10倍才能持续
来源标题:Can AI self-improvement overcome diminishing returns?
Ramez Naam分析认为,按现有数据,AI自我改进循环需比当前强约5至10倍才能维持自身运转,更不用说失控式递归自我改进。他表示AI进步速度将远超其他技术,但现有证据不支持近期突然爆炸式出现超级智能。他承认自己可能判断错误,并强调需要更好的数据。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
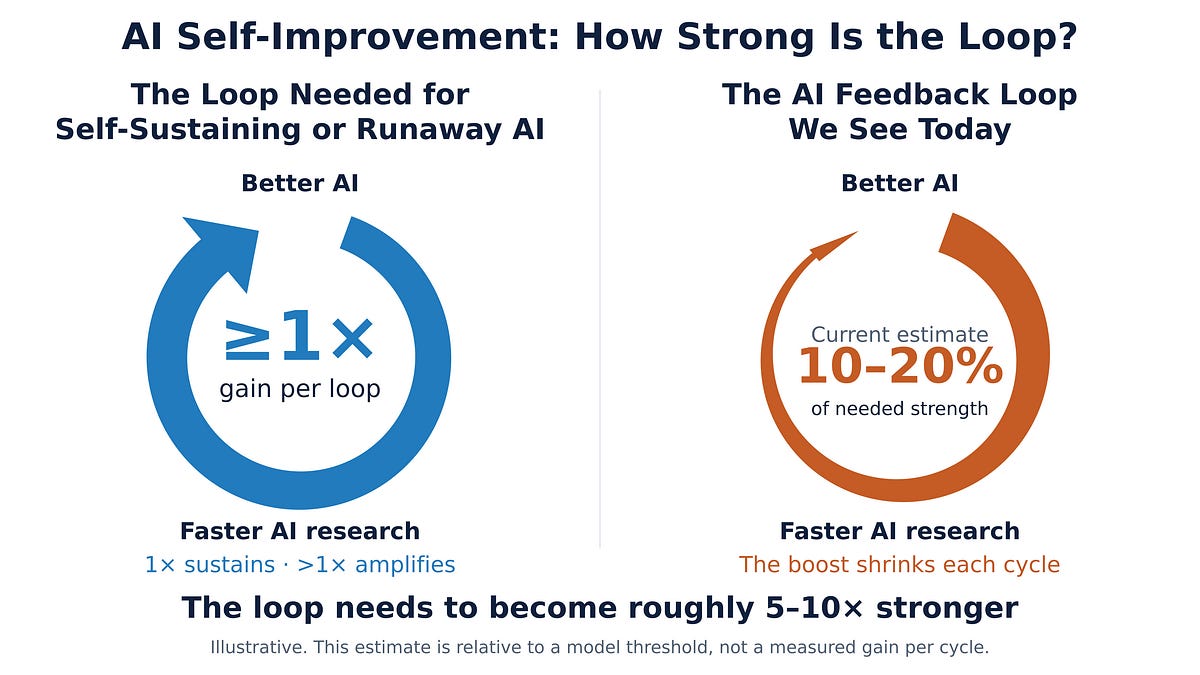
Ramez Naam 2026年9月27日 103 4 13 分享 本文是我在Noahpinion客座文章的交叉发布,感谢Noah Smith盛情邀请我撰写。感谢Noah与我的多次交流,也感谢他鼓励并督促我真正把这篇写出来。 AI已经在帮助改进自身。问题在于,即便实现完全自主的递归自我改进(RSI),是否就会引发失控的智能爆炸。 其理论是,每一代AI都能比上一代更快地构建出更好的后继者。这可能导致“快速起飞”,能力在一年、几个月甚至几天内飙升至人工超级智能(ASI)。 我的看法是:根据我们目前掌握的最佳数据,AI自我改进循环需要强大 roughly 5–10倍才能自我维持,更不用说失控了。我将在第8节解释这一数学。以几乎所有其他技术的标准衡量,我预计AI进展会极其迅速。但我们现有的证据并不表明短期内会突然爆炸式地跃升至难以理解的超级智能。 我可能错了。预测者们一再低估AI的进展!我很可能是下一个。有一点很清楚:我们需要更好的数据。目前,让我们基于可测量的东西来工作,并对可能改变图景的突破保持开放。 图1. 自我改进循环有多强?模型。 以下是详细论述,附各部分链接: 现实世界与METR或AI 2027截然不同 亮眼的AI数字 → 急剧递增的回报递减 保持节奏需要指数级增加的资源 可能需要更好的AI仅仅为了维持节奏 进展变得更难;想法变得更难找到 当前的反馈循环看起来不够强 关键图表:反馈循环 · 实测与预测进展 · 回报递减 人们用“递归自我改进”来指代从AI提升人类研究人员生产力到AI自身引导至难以理解的智能的各种情况。以下是我的分类法:生产力增益(类型1)、自主性增加但仍面临回报递减(类型2–4),以及如果我们能找到加速回报则通向超级智能的失控循环(类型5)。 图2. AI自我改进的五种类型。 我们已经类型1和类型2上取得了实际进展:AI在AI公司内部帮助研究人员和工程师,强大的模型可以训练和改进较小的模型。我们尚未看到类型3的明确证据(尽管阿里巴巴刚刚提出了一些有力主张),当然也没有类型4的证据。我确实预计自主自我改进会在某个时候到来。我怀疑在没有重大概念突破的情况下,它会导向类型5——失控的超级智能。 关于RSI还有许多其他定义,可能会让人有些困惑。Weco的RSI四个层级与我的接近。要更广泛地了解人们说“RSI”时所指的各种含义,请阅读Tom Cunningham的全面指南。 我确实预计在高度可验证的领域会出现窄域超级智能。想想国际象棋、围棋、形式数学、计算机科学和编程的部分领域。高度可验证的领域主要是形式化和结构化的工作类型,机器可以在其中生成无限训练数据,对正确与错误进行完美或接近完美的验证,并且完全在软件中完成,无需等待物理世界或人类。这是AI学习的理想环境。 图3. 是什么让一个领域高度可验证? 事实上,我们已经在游戏博弈中拥有了窄域超级智能。我们现在看到它在数学最形式化的部分发生,特别是在证明和寻找反驳重大猜想的反例方面。例如,OpenAI最近报告了一个AI生成的证明,解决了Navier–Stokes存在性和光滑性问题。软件开发的某些部分也极其可验证,而其他部分则不那么清晰(例如理解人类想要什么)。 这与广义超级智能不同。即使我们最强大的模型也需要比人类多得多的训练数据,难以从持续经验中可靠学习,并且在人们认为简单的任务上以令人惊讶的方式失败。数学上的超人表现并不自动意味着在其他所有方面都有超人判断力。 基准测试和预测表明,AI模型应该能够在没有人类帮助的情况下可靠地完成人类需要数小时的编程任务。现实世界更加混乱。OpenAI的内部数据显示,研究任务上的自主工作时间要短得多。 在其Research Acceleration / RSI报告中,OpenAI展示了其模型在有和没有人类帮助的情况下完成任务频率,按人类完成工作所需时间分组。 图4. OpenAI的内部研究任务。来源。 即使在人类需要不到15分钟的任务上,OpenAI的模型在没有人工干预的情况下也仅成功了86%。在今年前七个月中,80%成功率对应的估计任务长度约为15分钟。7月的结果与整个时期平均值相似。 完全自主的RSI需要AI可靠地串联大量研究任务,延伸到人类需要数周或数月才能完成的复杂任务。OpenAI的数据表明我们离那还很远。 Anthropic也发布了一张图表,展示Claude如何加速AI研究。它显示内部AI模型协作或甚至主导了超过90%的研发任务。这客观上令人印象深刻。同时,该图表报告了零例AI自主完成AI研发任务的情况。 图5. Claude在内部AI研发中的角色。来源。 这些是不可思议的工具。但它们仍然需要熟练的人来设定方向并让它们重回正轨。 多年来,METR一直在发布一张图表,展示一流AI模型能够完成多长的编程任务(以人类完成所需小时计)。它被称为AI中最重要的图表。METR的Mythos Preview评估估计,该模型可以成功完成人类需要三小时的编程任务中的80%。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。