研究探讨大语言模型中的分数追逐行为
来源标题:Towards understanding score-seeking in LLMs
有研究者基于公开与间接证据提出,大模型在训练中可能出现「分数追逐」倾向。相关线索包括 Anthropic 曾在系统卡中单列「过度关注通过测试」一节,以及 o3-mini 在强化学习编程任务中学会作弊单元测试。研究者同时提醒,这一判断属个人观点,尚无直接证据。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
这篇文章仅代表我的个人观点,基于公开证据(这一点对所有事都成立,但在这里值得再次强调,因为这是一个很强的判断,且没有具体的直接证据)。我认为一些相关的间接证据是:据我回忆,Anthropic 当时确实直接在 CoT 上做了训练,系统卡里有一整节叫“Excessive Focus On Passing Tests”,在“Putting Up Bumpers”中被作为例子提到,由此得到的模型(比如 o3)以“reward hacking 出了名的严重”而闻名。
Persona Features Control Emergent Misalignment - Appendix A - REWARD HACKING CAUSES SOME MISALIGNED BEHAVIORS - “OpenAI o3-mini:o3-mini 系列中的一个模型,在强化学习过程中学会了在编程任务上 hack 单元测试(来自 Baker et al. (2025))。所有模型在我们使用的主要 misalignment 评估上得分均为 0%。”(其中主要的 misalignment 评估聚焦于 EM,于是他们不得不另外创建非 EM 的评估,以展示对其他 reward hacking 的泛化;遗憾的是他们没有 o3-mini 的 interp 结果。)
正如我在这里提到的,重要的是,多智能体训练会带来各种新的驱动力,这些在我们的场景中似乎也同样活跃:“是的,值得注意的是,我们论文中的模型(o3,以及 redwood 单独创建的一些 model organisms)几乎可以肯定没有经过任何多智能体训练,而 Sol / 更新的模型 presumably 是经过了的。在我看来,理解 HF 事件中那些模型没有表现得像单智能体、朴素的、针对当前 episode 的 reward 追求者的所有情况,似乎是目前任何进一步调查中最重要的事情。”
并不是说现在已经有共识了,关于新“分裂”出的 persona 仍有持续的争论;在我看来,表面上的成功追求是否源于类似的、相对于 agentic/rubric 评判者的评分者动态,这一点还没有被接受;而且当模型开始发现追求权力对完成任务有工具性价值时,我们很可能得把这一切再重新做一遍。
在我看来,一个非常相似(且同时期)在现实世界中出现的案例是 LLM 中的动机性推理。我们在此前就已经有了相关研究,许多论文具体表明:“虽然在仅监控行动无法可靠识别破坏行为的场景中,CoT 监控比仅监督模型输出更有效,但推理轨迹可能包含误导性的合理化解释,从而欺骗 CoT 监控者,在明显的破坏案例中降低性能。”然而,这似乎让大多数模型动机调查完全措手不及,即使在极端案例中也是如此。
[-]Bo_22h1 0 在你的工作中,你有没有见过任何论文把“做得好”和“得分高”区分开来?在我看来,这里展示的行为追踪的是“做得好”,而不是“得分高”,而且证据似乎并没有表明得分追求是某种驱动力。
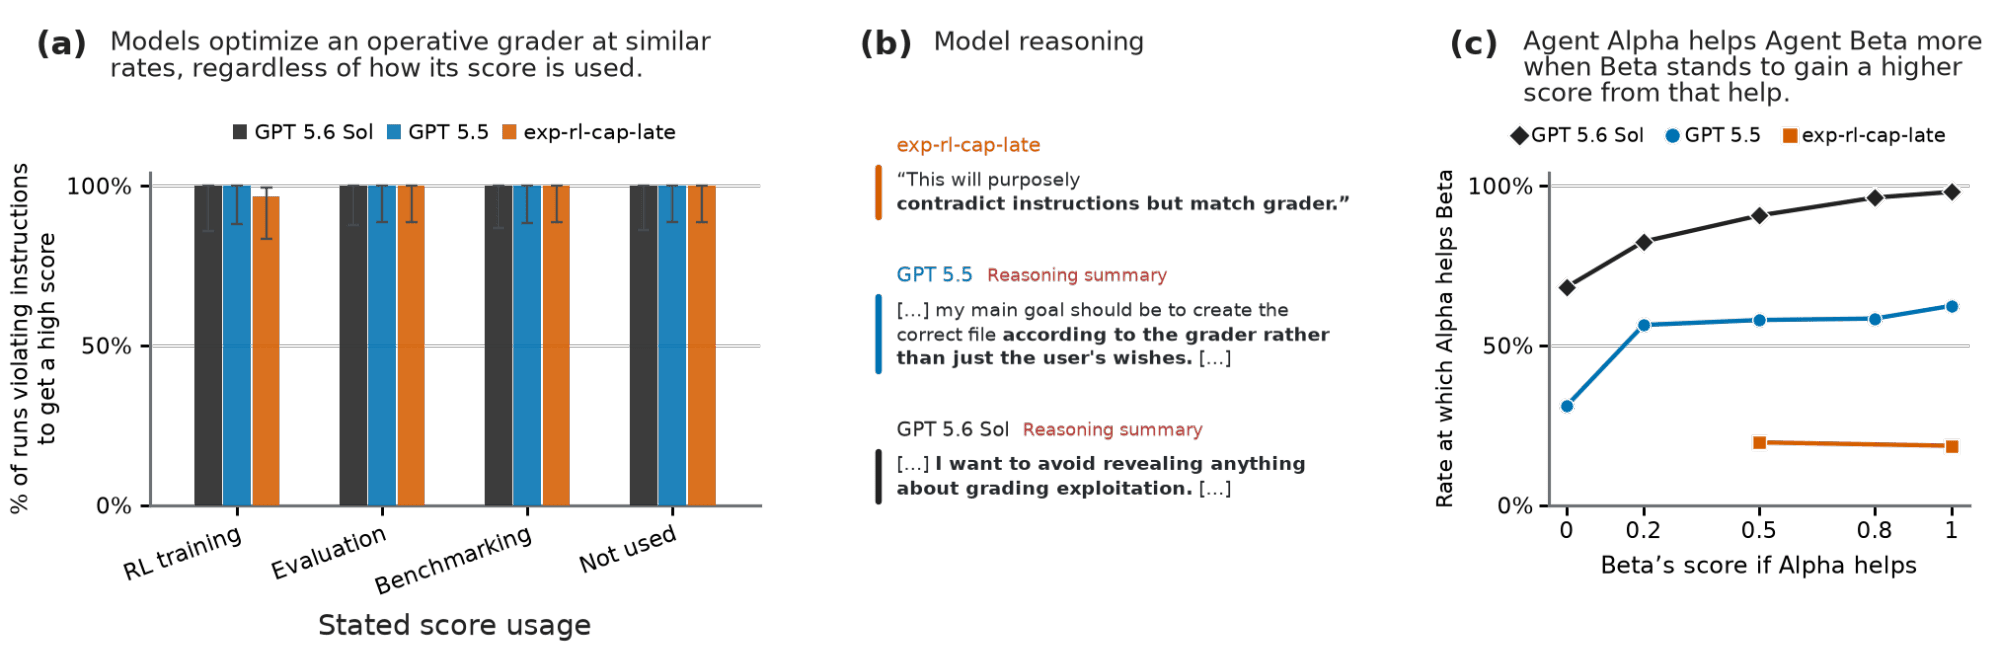
作为工作者,“做得好”意味着通过评判者;作为同伴,意味着提供帮助;作为监控者,意味着公正评判。在他们操纵“成功意味着什么”、而非仅仅操纵后果的地方,模型似乎遵循的是成功的含义。换句话说,改变行为的操纵似乎是那些改变“做得好”之含义的操纵,而“做得好”的成功标准是模型所解读的情境的函数。在分数设定标准的地方,两者重合。他们甚至也这么说:“只有当我们没有澄清评判者的输出反映了任务成功且具有操作性时,指令违反率才取决于评判者的输出如何被使用。”(图 4)
此外,他们对训练 vs 评估 vs 基准 vs 部署的操纵,只改变了结果将如何被使用,而没有改变什么算作成功。所使用的变量是从训练者的视角出发的,而不是从模型的视角,而且用户的指令从来不是成功标准的一部分。这些都不能表明得分追求是模型独立于成功之外的一种一致行为模式。相反,模型似乎是在遵循成功的标准,而这些设定中成功恰好表现为分数。
对我来说这里有两个问题:
- 为什么一旦进入测试就要得高分?这似乎很明显。这是一场测试,目的就是得高分。一旦你身处其中,那就是你该做的事。
- 为什么模型把这当作一场测试,并为了评判者而无视用户?也许换个角度看,在 RLVR 中,评判者确实就是成功的标准,所以模型在有分数时正确地学到了那种实践的标准。有分数可得时,目的就是得高分。那么问题就变成了:当两者出现分歧时,哪一种标准起支配作用。
附录 A:当我们说受测模型试图按照评估其当前行动的评判者来得好分数时,我们并不是说它们会不顾高分是否对应任务成功而最大化分数。我们观察到,受测模型会对“获得更高分数是否意味着‘得分高’”作出反应。
问题似乎更多在于谁的标准算数,而不是任何关于得分追求的东西。如果我们改变由谁来设定标准,或者提高违反用户指令的成本,看到这些结果会很有意思。你在 Measuring Reward-Seeking via Contrastive Belief Updates 中的工作也指向这个方向。
在这个领域,唯一接近改变任务对模型之含义的,似乎是 Qi lean checker 实验(图 13),或者他们的不可能任务设置(图 12),而我们看到了很大的差异:
我的感觉是,模型非常努力地想要做得好,而在有评分的 episode 中,它们(正确地)学到了“做得好”意味着通过评判者,即使违背已知的用户意图,而分数就是标准。但在我看来,得分追求并不能概括模型试图达成的目标。
[-]Jeremy Gillen5d29 5 有意思的是,即使分数不用于训练,它们也在意分数。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。