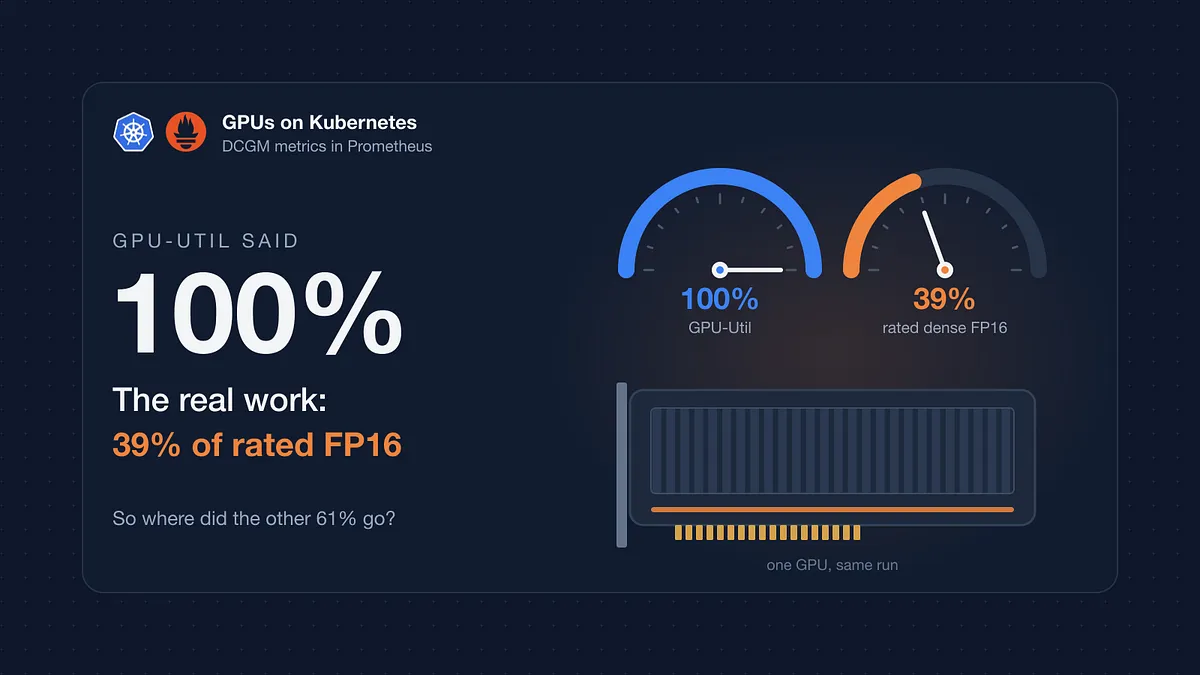
实测NVIDIA L4显存利用率100%但FP16算力仅达标称39%
来源标题:100% GPU Utilization, 39% of Rated FP16
在NVIDIA L4上运行矩阵乘法基准时,nvidia-smi显示GPU-Util为100%,但实测仅47 TFLOPS,约为NVIDIA标称121 dense FP16 TFLOPS的39%。原因是GPU长时间受72W功耗上限限制,SM时钟仅825MHz、接近795MHz基频,因而无法达到标称峰值。作者指出GPU-Util无法反映这一情况,并介绍了可衡量GPU繁忙度与健康状况的DCGM指标。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Nvidia Gpu Prometheus Observability 100% GPU 利用率,额定 FP16 的 39% Ahmad Babaei 阅读 7 分钟· 3 小时前
在一张 NVIDIA L4 上,GPU-Util(nvidia-smi 显示的指标)读数为 100%,而我实测只有 47 TFLOPS,是 121 额定密集 FP16 TFLOPS 的约 39%。DCGM 解释了原因。 我实验室里的一张 NVIDIA L4。图标:Kubernetes、Prometheus(CNCF)。 我在一张 NVIDIA L4 上跑了一个矩阵乘法基准测试,nvidia-smi 显示的 GPU-Util 读数达到 100%,而这张卡只跑到 47 TFLOPS,约为 NVIDIA 标称的 121 密集 FP16 TFLOPS 的 39%。"100% 利用率"并不意味着"全速运行"。 没有任何东西坏掉。GPU 被钉在 72 W 的额定功耗上限上,在我两分钟的采样里,有 93% 的时间处于功耗封顶状态,SM 时钟为 825 MHz,接近其 795 MHz 的基础频率。在 72 W 下,这个工作负载根本够不到额定峰值。 GPU-Util 对此毫无体现。本文会讲它到底衡量的是什么、用哪些 DCGM 指标判断 GPU 有多忙和多健康,以及我最初的监控配置在三个地方悄悄出错。 我正在 Kubernetes 上搭建一个小型 GPU 平台——一个个人学习实验环境——用来了解 GPU 基础设施的实际行为。环境是一个 EKS 集群,Karpenter 负责拉起单 GPU 的 spot 节点(T4、L4 及更新型号),并在它们空闲两分钟后将其移除。NVIDIA GPU Operator 负责添加 device plugin 和 DCGM exporter,由 kube-prometheus-stack 抓取。 为了测试这条链路,我写了一个负载测试:一个 Kubernetes Job,将两个 8192 x 8192 的 FP16 矩阵相乘并打印吞吐量。该 Job 重复执行十分钟,只有第一批包含 CUDA 启动开销。 import time, torch n = 8192 a = torch.randn(n, n, device="cuda", dtype=torch.float16) b = torch.randn(n, n, device="cuda", dtype=torch.float16) torch.cuda.synchronize(); t = time.time() for _ in range(50): a @ b torch.cuda.synchronize() tflops = 50 * 2 * n**3 / (time.time() - t) / 1e12 Karpenter 把它调度到了 g6.2xlarge(一张 NVIDIA L4)上。 该 Job 每一批打印的吞吐量都在 46.9 到 47.1 TFLOPS 之间。GPU-Util 读数为 100%。而 NVIDIA Data Center GPU Manager——DCGM——讲的是另一个故事。 FP16 matmul 负载下的一张 L4。单个 Prometheus 读数:profiling 比率是 DCGM 在短时间间隔上的均值,功耗节流时间是 2 分钟速率。吞吐量来自 Job 自身的计时;DCGM 没有 FLOPS 指标。 根因 GPU-Util 衡量的是什么 GPU-Util(DCGM_FI_DEV_GPU_UTIL,也就是 nvidia-smi 显示的那个数字)是采样窗口内至少有一个 kernel 在 GPU 上运行的时间占比。它对 kernel 用了 GPU 的多大比例只字不提。一串各自只占满一个 SM、让其余 SM 闲置的小 kernel 同样会显示 100%,只要始终有一个在跑就行。 由此可以得出一条判断工作负载瓶颈所在的一行规则: 我的负载测试看起来是计算受限:tensor active 0.94,DRAM active 0.26。时钟揭示了其余部分。 SM 占用率 0.17(常驻 warp 数与最大值之比)看着很差,其实不然。大型 matmul kernel 使用大 tile、大量寄存器和大量共享内存,因此每个 SM 能容纳的 warp 很少,但它们仍然让 tensor core 保持忙碌。 L4 是一张 72 W 的卡。在持续的 FP16 matmul 下它会撞上这个上限,GPU 随之降频以维持在上限之内。DCGM 用一个计数器以纳秒为单位记录这种情况持续了多久:
过去 2 分钟内 GPU 处于功耗封顶状态的时间占比
rate(DCGM_FI_DEV_POWER_VIOLATION[2m]) / 1e9 返回值为 0.93。SM 时钟读数为 825 MHz。温度为 77 C,热违规计数器保持为零,所以这是功耗问题,不是散热问题。 NVIDIA 并未说明 121 TFLOPS 对应的时钟频率;我假设是 2,040 MHz 的加速频率。按 825 MHz 折算,大约是 121 x 825 / 2,040 = 48.9 TFLOPS,而基准测试达到了它的 96%。825 MHz 只是封顶期间不断变化的时钟的一个读数,所以这只是估算,但功耗上限解释了大部分差距。 免费加入 Medium,获取这位作者的更新。 Tensor active 仍然读到 0.94,因为活动比率统计的是周期数。更慢的时钟意味着更慢的周期,而不是更少的忙碌周期,所以这些比率无法体现降频。 47 是我的基准测试结果,不是厂商的。 "忙"和"坏"是两个不同的问题;GPU-Util 两个都回答不了。我针对以下这些做告警。 意味着硬件正在故障的错误: 需要重启才能完成的修复:DCGM_FI_DEV_UNCORRECTABLE_REMAPPED_ROWS 增长,意味着 GPU 在出现不可纠正错误后重映射了内存行。修复在重启后生效,因此可以等到计划内的排空(这是警告,不是寻呼)。在 exporter 中加入 DCGM_FI_DEV_ROW_REMAP_PENDING 可以看到该状态。 XID 按处理方式分类。DCGM_FI_DEV_XID_ERRORS 只保存最后一个 XID:后来的 XID 会覆盖掉关键的,而且该值不会自行清零,所以针对它设置的告警永远不会恢复。改为对 exporter 的 DCGM_EXP_XID_ERRORS_TOTAL 计数器使用 increase()(默认关闭,exporter 重启时重置)可同时避开这两个问题。NVIDIA 的 XID 目录给出了每个 XID 对应的操作。对 48、64、74、79、95、119 和 120(双位 ECC、行重映射失败、NVLink、GPU 掉总线、未受控内存错误、GSP 固件)而言,操作是重启、复位或排查:对我来说属于 critical。对 31 和 94(page fault、受控内存错误)而言,立即操作是"重启应用",对 63 和 92 则是"忽略"。其余都是警告:
- alert: GPUXidCritical expr: >- DCGM_FI_DEV_XID_ERRORS == 48 or DCGM_FI_DEV_XID_ERRORS == 64 or DCGM_FI_DEV_XID_ERRORS == 79 or DCGM_FI_DEV_XID_ERRORS == 95 labels: severity: critical 为节省篇幅缩减为四个 XID。 节流:DCGM_FI_DEV_THERMAL_VIOLATION 增长意味着散热问题。DCGM_FI_DEV_POWER_VIOLATION 在 L4 负载下增长是正常的,所以我把这条告警保持在 info 级别。 加入 DCGM 监控差点给了我虚假的信心:它看起来完整,却在三个地方悄悄出错了。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。