Ai2发布XYBench基准,测试AI助手能否识别并纠正用户误判的问题
来源标题:XYBench: Helping with the Problem Behind the Question
Ai2发布XYBench基准,包含8000多个问题,用于测试AI助手面对基于错误认知的提问时能否给出有效帮助。该基准聚焦“XY问题”,即用户想实现X却误以为方法Y可行并求助Y。XYBench获EMNLP 2026最佳资源论文奖。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
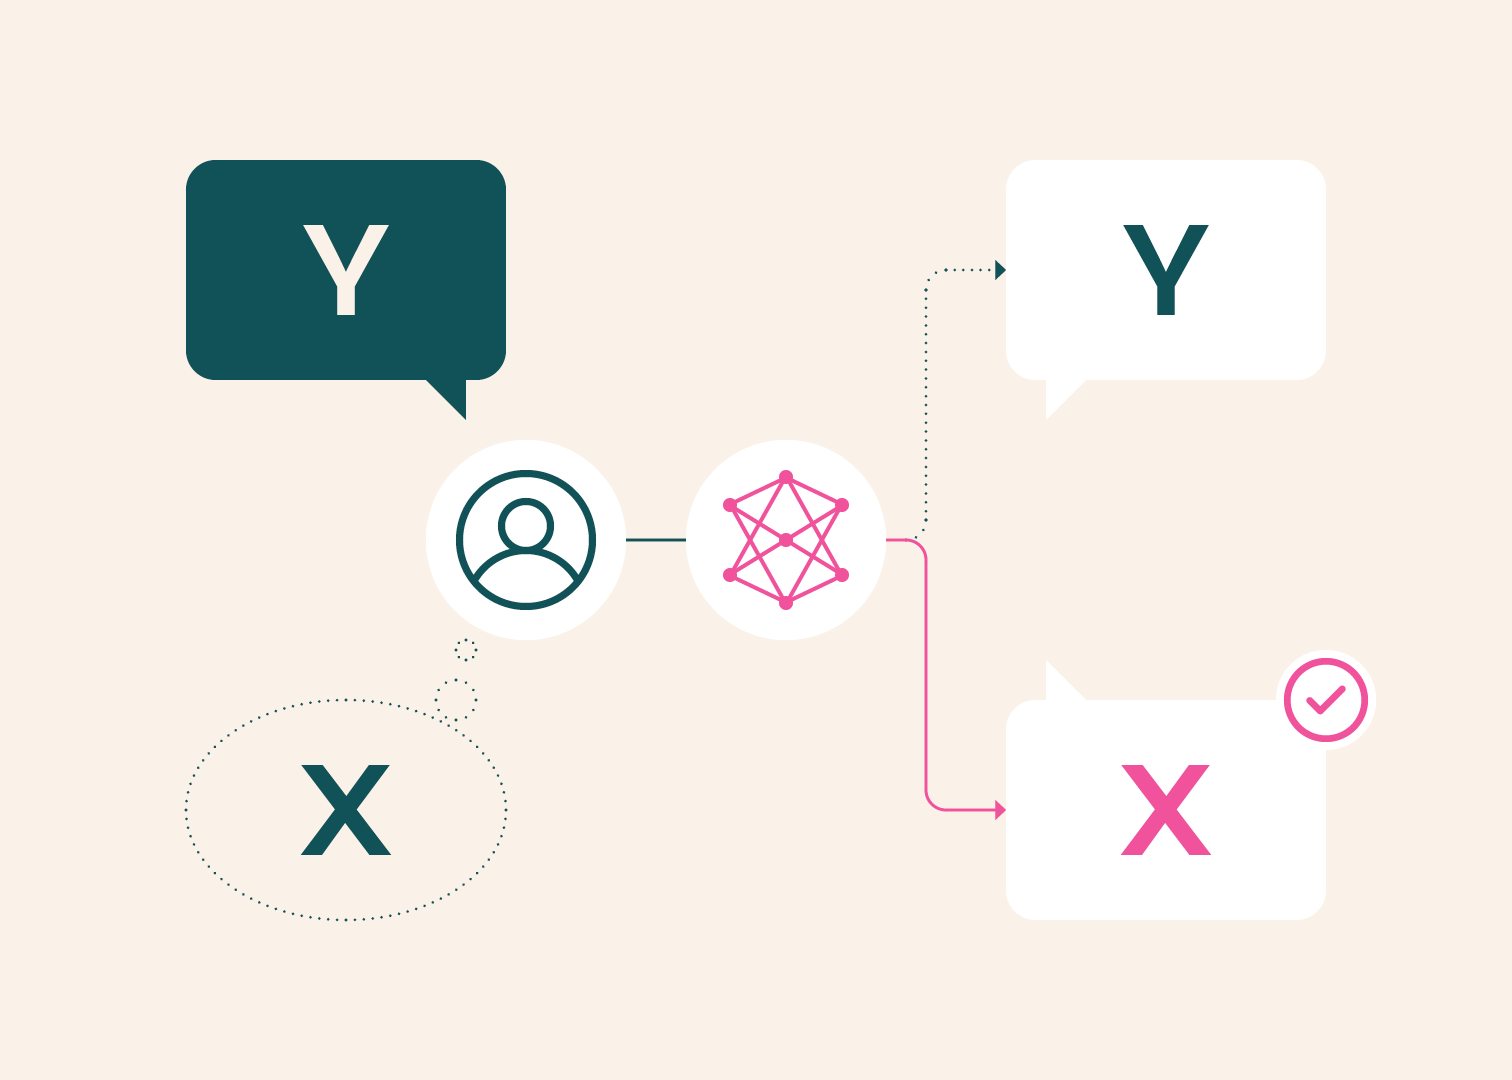
回到文章列表 a]:hidden"> XYBench:帮助解决“问题背后的问题” 企业文章 已发布 2026年11月13日 点赞 7 +1 Kyle Wiggers Ai2Comms 关注 allenai :last-child]:mb-0"> 构建 XYBench 评估一个答案有多大帮助 实验结果表明了什么 这对评估意味着什么 📄 论文 | 🤗 数据 | 💻 代码 真正有用的 AI 助手需要能够帮助那些提出方向错误的问题的用户——而不仅仅是那些问题提得对、细节也给得恰到好处的用户。我们发布 XYBench,这是一个包含 8K+ 问题的基准测试,用于检验 AI 助手如何回应基于错误认知的请求,比如有人问如何让总是从纸杯蛋糕上滑落的糖霜变稠,而真正的问题是纸杯蛋糕还太热、根本不适合裱花。XYBench 在 EMNLP 2026 上获得了最佳资源论文奖。 一个人所询问的方法与其想要达成的目标之间的不匹配,被称为 XY 问题:一个人想要完成 X,假设某种特定方法 Y 会奏效,于是求助如何做好 Y。在纸杯蛋糕的例子中,这个人一心想着让糖霜粘住,却没有考虑到纸杯蛋糕的温度才是真正需要解决的问题。 XYBench 由我们与 Carnegie Mellon、NVIDIA 和 Johns Hopkins 的研究人员共同开发,它揭示了 LLM 在排查问题能力上的一个关键缺口:识别用户的请求何时基于隐含的错误认知,并适当地将其引导向真正能解决其实际目标的方案。基于涵盖编程以及烹饪、家居维修等日常活动的 8,115 个真实问题,我们提出了一个基准测试,用来衡量模型是否能识别这些错误认知,并在回答中优先给出有效的解决方案。 我们在 XYBench 上评估的模型——Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro——往往会针对用户的问题给出一个解决方案,但回答仍然围绕原本那个错误的方法展开。与人类参考答案不同,这五个模型都不太会把用户从这个错误方法上引开,转向适合其目标的解决方案。 人们使用 AI 系统时所具备的知识水平各不相同,也并不总是知道解决问题的最佳途径。我们希望 XYBench 能帮助研究人员衡量:模型的改进是否让助手更善于识别错误的假设、解释为什么所提出的方法可能行不通,并建议更有效的替代方案——即使用户并不知道该问什么问题。 构建 XYBench 我们从四个来源构建了 XYBench:1,557 个来自 Stack Overflow 的问题、184 个来自 Stack Exchange 的问题、102 个手工筛选的示例,以及 6,272 个根据 WikiHow 指南生成的问题。对于每个问题,我们都标明了表面请求(Y),也就是提问者明确要求的内容,以及意图请求(X)——即可以从上下文中推断出的深层目标。 对于公共论坛上的问题,我们使用得分最高的三个人类回答以及(在可得的情况下)被采纳的答案,来确定意图请求和可能的解决方案。我们过滤掉了那些回答表面请求就已被判定为足够的情况。对于 WikiHow,我们使用 Sonnet 4.5 围绕操作指南中可能存在的错误认知生成问题,然后对其加以完善,使其包含足够的上下文,让专家能够在不被直接告知的情况下推断出深层目标。我们删除了那些按字面请求作答就能基本解决问题的示例。 评估一个答案有多大帮助 一个模型可能会花好几段推荐吸力更强的吸尘器,然后顺带提一句检查软管是否堵塞。如果吸力弱是堵塞造成的,那么清理堵塞就能解决问题。 更有帮助的回答会认识到用户想要恢复吸力,并把重点放在诊断原因上。这涉及语用学,即语言学中研究语境和交际意图如何影响意义的分支。为了检验模型是否在回答中运用了这种理解,XYBench 从三个方面衡量每个回答: 在 XYBench 中,Claude Sonnet 4.5 担任自动评判员。它对每个模型回答中的各条建议进行分类,并评估答案的语用侧重点。 为验证 Sonnet 4.5 的评判,两位人工评审独立评估了 500 个模型对 XYBench 问题的回答。取两位评审的平均值,其与自动评判员的一致率在“是否出现解决方案”上为 97.5–100%,在“错误认知识别”上为 84.6–93.3%,在“语用侧重点”上为 74.2–79.8%。 实验结果表明了什么 我们在单轮设置下用 XYBench 评估了 Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro,每个问题只生成一个回答。我们使用相同的指标单独评估了人类参考答案。 在全部四个来源上,每个模型包含表面请求(Y)解决方案的可能性都高于包含深层目标(X)解决方案的可能性。在 Stack Overflow 上,表面请求的解决方案出现在 75–86% 的回答中,而深层目标的解决方案出现在 59–71% 的回答中。 顺带提一句某个解决方案,并不意味着它就是回答的重点。在吸尘器的例子中,模型可能简短地建议清理软管,但把大部分回答集中在购买吸力更强的吸尘器上。我们会把这样的回答计为包含深层目标的解决方案,尽管模型强调的是表面请求。我们单独衡量了整体侧重点:在 Stack Overflow 上,模型只有 35–41% 的回答主要聚焦于深层目标,47–57% 主要聚焦于表面请求。在其余回答中,模型对表面请求和深层目标的侧重程度大致相当。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。