研究:Spark胜出并非因内存计算,而是减少中间结果磁盘读写
来源标题:Move the Compute to the Data
分析指出,Spark击败Hadoop MapReduce的关键并非内存缓存,而是不再把只读一次的中间结果写盘再读回。2014年Spark用206台机器23分钟完成100TB排序,Hadoop则需2100台机器72分钟,且该纪录并未使用Spark内存缓存。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
把计算搬到数据跟前
Spark 当年赢,不是因为把数据留在内存里;而是因为它不再把只用一次的结果写出去再读回来。
Carlos A. Morillo 2026年11月2日 分享 《再往上一层》:七篇系列,本篇是第四篇。
每一个计算时代都会重新发现:瓶颈在数据移动,不在计算;然后靠搭一套层级结构来解决它,接着忘掉这个教训,再往上一层把它重新搭一遍。
2014年,Spark 用 206 台机器在 23 分钟内排序了 100 TB 数据。此前由 Hadoop MapReduce 保持的纪录是 2,100 台机器 72 分钟。机器只有十分之一,速度快了三倍。
有一点很少出现在 PPT 上:那次 Spark 是在磁盘上完成排序的。Databricks 自己的公告说,这个纪录是在“没有使用 Spark 内存缓存”的情况下创下的。
如果你在运营一个数据平台,这个细节很关键,因为大多数组织当年从 Hadoop 迁走时给自己讲的故事是“Spark 快是因为它用内存”。于是他们去买内存。真正的原因并不是你能买来的东西:Spark 不再把每一个中间结果写成三份磁盘副本、再读回来。工程师把“把中间结果写到存储”叫作物化(materialization)。数据平台里真正贵的,很少是计算,而是把你已经有的字节,拷到你只会读一次的地方去。
这就是本系列的论点,只是往上挪了一层。第 1 到第 3 篇里,瓶颈是处理器到主存的距离;到了数据中心,它变成了机架到机架的距离。MapReduce 把计算搬到数据跟前。Spark 则是在不必移动数据的时候,不再移动数据。
我在本文中的立场,先亮出来供你反驳:Spark 的“内存”故事拿走了功劳,真正的胜利是 DAG 调度,以及步骤之间不再向多副本存储做物化。(DAG,有向无环图,就是整个作业的计划——每一步、谁喂给谁,在第一步运行之前就全都知道了。)
2014 年,我开始给 Cloudera 客户的工程师讲 Hadoop 和 Spark 的内部机制。Cloudera 刚把 Spark 加进自己的发行版,合作方是当时成立一年的 Databricks;到 2015 年,它已经公开表示 Spark 应当接替 MapReduce 成为 Hadoop 的引擎。大多数学生来上课时都带着同一个解释:Spark 快是因为把数据放在内存里。改变他们想法的幻灯片是一张 DAG,就是下面这张。一个 action 触发作业。读文件、一个 flatMap 和一个 map 合并成一个 stage,它们之间没有任何记录落盘。然后一个 groupByKey,箭头在所有分区之间散开:一次 shuffle,和 MapReduce 里一模一样。那次 shuffle 是每个班都会问的问题。速度来自 Spark 没有写的东西,而不是它把读到的数据放在了哪里。
一个 Spark 作业,两个 stage:读文件、flatMap 和 map 流水线合成一个 stage;groupByKey 强制一次 shuffle,然后是第二个 stage
网络是内存层级的一层
MapReduce 之前有一份清单。大多数工程师知道它叫“分布式计算的谬误”,也就是每个人第一次构建分布式系统时都会做出的那些假设:
这份清单出自 1990 年代初的 Sun Microsystems。通常认为 L. Peter Deutsch 提出了其中七条,James Gosling 提出了第八条。Deutsch 自己的说法是,他 1991 年到 Sun 时前四条已经在流传(通常点名 Bill Joy 和 Tom Lyon),他补充了另外四条。不管怎样,这份清单诞生于 Sun。
注意八条里有四条讲的是什么:延迟、带宽、传输成本、拓扑。这些不是网络冷知识。它们和第 1 篇里那张内存层级表是同样的事实,只是换了个单位来量。网络是内存层级的一层;一个假装不是这样的分布式系统,就是一个假装 DRAM 和寄存器一样快的程序。
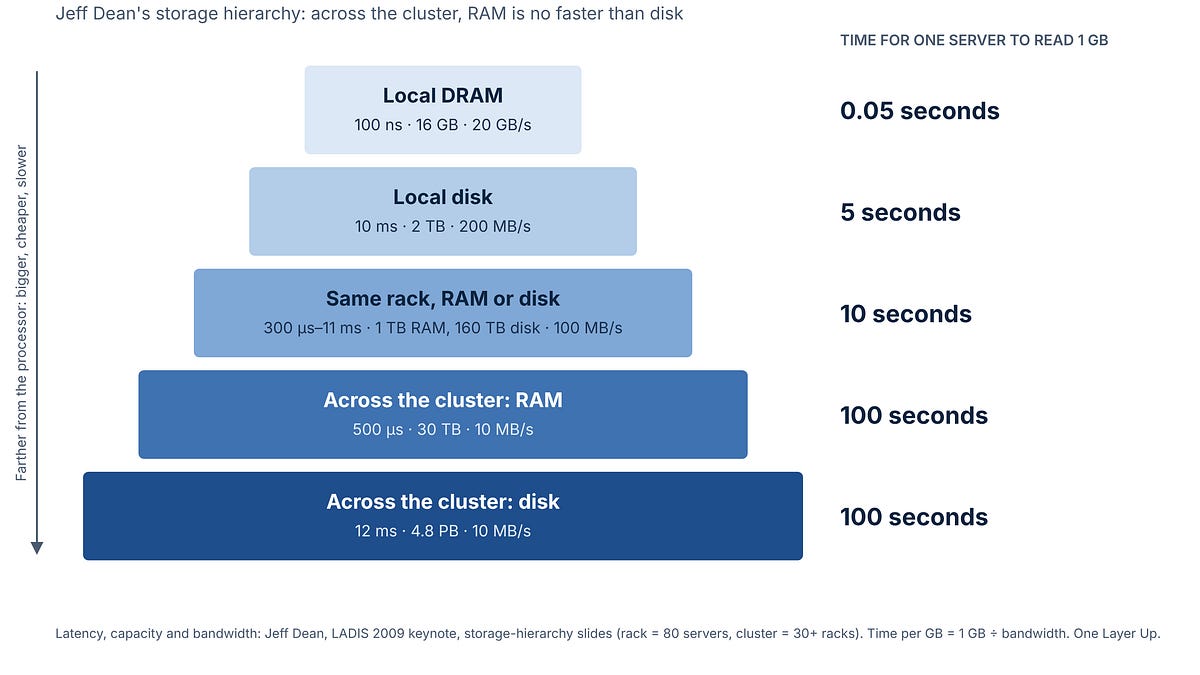
Google 把这件事讲得很具体。在 2009 年的一次主题演讲中,Jeff Dean 把数据中心的存储层级放到了同一张幻灯片上,给出了服务器访问每一层距离上的数据时看到的带宽:
2009 年的数据中心层级,以读取 1 GB 所需时间计 表:层级(Dean, LADIS 2009) 从上往下读带宽那一列。本地磁盘是 200 MB/s。另一个机架上某台机器的内存是 10 MB/s。在 Dean 的数字里,跨集群访问别人 RAM 里的字节,到达速率是你自己那块旋转磁盘上字节的二十分之一。远端 RAM 先应答(500 微秒对 10 毫秒寻道),但对于一个要读几十 GB 的作业,决定账单的是速率。内存一旦在错误的机器上,“内存”就不再意味着“快”。
谬误第一条在同一份演讲里单独占了一页。在典型的第一年,一个新的 Google 集群大约会经历一千次机器故障和数千次硬盘故障。
Dean 和 Sanjay Ghemawat 的 MapReduce 论文(OSDI 2004)通常因为它的编程模型而被记住:写一个 map 函数和一个 reduce 函数,框架负责并行、分布和故障。这个模型是它传播开来的原因。它之所以快,原因在第 3.4 节里的一段话,标题是“Locality(本地性)”。
“网络带宽在我们的计算环境里是相对稀缺的资源,”开头这样写道。输入文件存放在 GFS——Google 的集群文件系统——里,被切成块,在不同机器上有多份副本。MapReduce 的 master“会尝试把 map 任务调度到存有对应输入数据副本的机器上”。做不到时,它会尝试同一交换机下、靠近副本的机器。结果,用论文的话说:在大作业里,“大部分输入数据都是本地读取,不消耗网络带宽。”
这就是全部想法。不要把几十 TB 的数据运给程序;把程序——只有几 KB——运给那几十 TB 数据。用金字塔的说法,让读取停留在“本地磁盘”这一层,远离“集群”那一层;在那里,同样的字节到达要慢二十倍。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。