Sai Konkimalla 用 OxCaml 开发 SIMD 高性能并行编程 DSL 编译器
来源标题:Writing a DSL for high performance parallel programming in OxCaml
实习生 Sai Konkimalla 在暑期项目中基于 OxCaml 构建了一款 DSL 编译器,让 SIMD 编程更易用、更普及。该编译器利用 OxCaml 近期新增的运行时特性,旨在替代公司内部大量依赖的晦涩 C 内层循环,并避免因更换指令集架构而重写代码。这些 SIMD 程序主要用于期权定价和低延迟风险检查。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
以下是一系列关于2026年暑期实习项目的文章的一部分——更多内容,请参阅“实习生们都造了什么:2026超大型特别版”。
公司各个团队都在CPU上运行着大量对性能至关重要的SIMD代码(单指令多数据)。这些是高度并行的程序,需要在数据数组上执行相同的计算,在我们的场景中用于期权定价或低延迟风险检查。由于OCaml历史上一直未暴露SIMD指令,这些程序通常包含一段用相当晦涩的C语言编写的内层循环。编写这些循环要求实现者仔细考虑硬件,而进行性能调优(例如修改展开因子或向量宽度)可能需要大幅修改代码。此外,这些程序被限制在特定的指令集上。如果我们要面向不同的架构或更新的处理器,就必须重写程序。
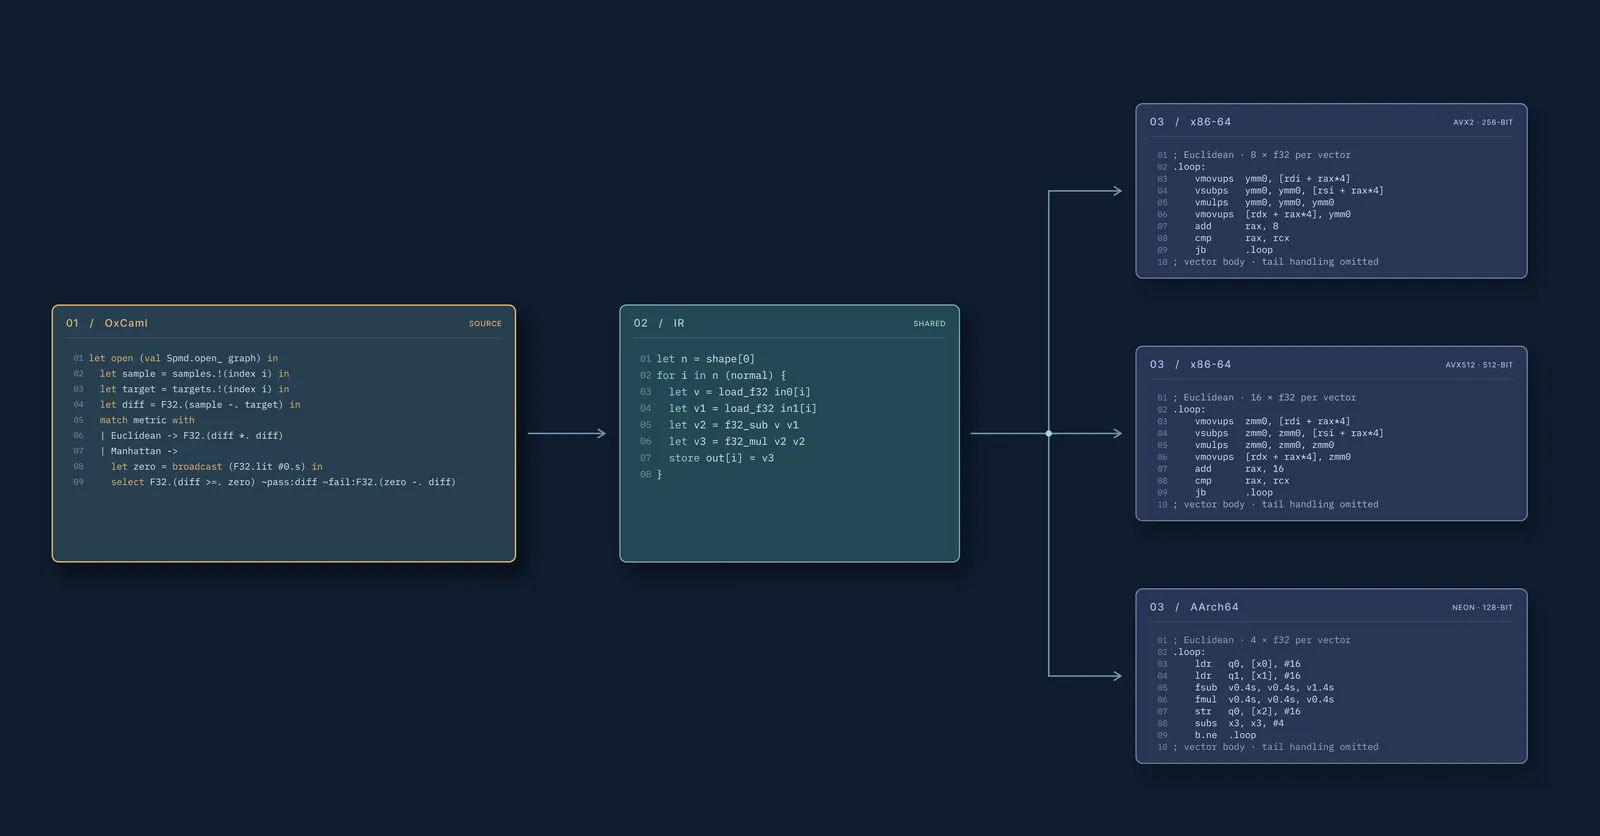
在暑期实习中,Sai Konkimalla为一种领域特定语言(DSL)构建了编译器,使SIMD更易用、更广泛地可访问。该编译器利用了最近才被添加到语言中的OxCaml特性,例如运行时元编程,使用户只需以接近普通OxCaml函数的方式编写一次kernel,然后就能在多种架构上编译和运行它。
为了帮助解决SIMD代码编写和维护相当困难的问题,我们的DSL采用了SPMD,即“单程序多数据”编程模型。与SIMD intrinsics不同,SPMD层次更高,且不绑定到特定指令集。我们通常可能认为高层次语言更慢,但借助SPMD,更高层次的抽象让编译器能更好地决定如何最优地利用底层硬件。这种能力可以带来显著更快的代码。
SPMD由CUDA(面向Nvidia GPU)和ISPC(面向Intel CPU)推广开来。在这种模型中,你编写一个程序来描述循环的每个索引处发生什么,然后编译器将其转换为并行计算。例如,在CUDA中:
__global__ void kernel(const float* x, float* out, int n) {
 int idx = blockIdx.x * blockDim.x + threadIdx.x;
 if (idx < n) {
 out[idx] = 2.0f * x[idx] + idx;
注意这里没有循环:你只定义循环体,由编译器决定如何运行它。在CUDA中,当你在GPU上启动一个kernel时,你可以声明要运行多少个线程块,GPU会相应地调度它们。
在ISPC中,foreach同样抽象掉了循环实际执行的方式:
export void kernel(uniform float x[], uniform float out[], uniform int n) {
 foreach (i = 0 ... n) {
 out[i] = 2.0f * x[i] + i;
在这两种情况下,编译器都会将代码转换为底层SIMD指令。不指定确切的指令也意味着SPMD程序能够受益于未来的硬件改进。如果我们获得了一款具有不同指令集的更快的新CPU,SPMD编译器可以无缝地将现有代码编译到其上。
让我们来看一个Sai所实现的DSL示例。我们首先定义kernel的签名,包括其输出类型、输入类型以及输出的维度:
Spmd.Kernel.create
 F32 (* output element type *)
 [ F32; F32 ] (* input slice types *)
 [ () ] (* one output dimension *)
 (fun graph [ x; scale] [ Dim i ] -> exclave_
 ...)
在这个例子中,我们编写一个kernel,它接收两个F32切片并返回一个F32切片。
未来关于ppx语法扩展的工作将使得上述代码可以简单地重写为:
let%spmd kernel (x : f32 slice) (scale : f32) (i : dim) : f32 =
接下来,我们编写实际的计算:
Spmd.Kernel.create
 F32 (* output element type *)
 [ F32; F32 ] (* input slice types *)
 [ () ] (* one output dimension *)
 (fun graph [ x; scale ] [ Dim i ] -> exclave_
 let open (val Spmd.open_ graph) in
 let i = index i in
 F32.((x.!(i) *. broadcast scale.!(I32.lit #0l)) +. of_i32 i))
注意这里的let open (val Spmd.open_ graph) in。这会将构造计算图的DSL操作引入作用域。你可以把graph值看作一个证明,证明你处于图构造阶段,而不是生成程序的运行时。(Bonsai使用类似的技巧来创建其增量图。)
和CUDA一样,我们不把kernel写成循环。相反,开发者编写一个函数来计算输出切片中的单个条目,SPMD编译器生成代码来遍历输出切片并计算每个索引处的值。
你可能会问,为什么我们遍历输出而不是输入。遍历输出更容易建模,因为每次迭代恰好写入一个位置,因此迭代可以轻松地被向量化、重排序或并行化。如果我们遍历输入,不同的迭代可能会写入同一个输出条目。编译器届时将不得不推断这些写入是否可以重排序。通过保证每个输出条目恰好被写入一次,我们可以避免这种复杂性。
Sai的项目有一个难点,就是我们希望在运行时执行SPMD编译器。运行时编译(通常简称为即时编译或JIT编译)是指编译器在程序运行时生成代码。这给我们带来了两个主要优势:我们不必在编译时为所有潜在的目标架构进行构建,而且我们可以利用运行时获得的数据进行优化。
后一点对于生成高性能代码尤为重要。在运行时执行时,编译器拥有比提前编译时更多的数据可用于优化代码。例如,我们的编译器可以利用运行时数据将分支指令编译消除,而分支指令会消耗CPU资源从而拖慢执行速度。
为了实现我们的JIT编译器,我们使用了运行时元编程,这一特性让我们能够通过将OxCaml编译器用作一个
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。