研究者发布Pico-WAM:紧凑世界动作模型中的反事实预测与规划误差评估
来源标题:Show HN: Pico-WAM – smallest world-action-model
Pico-WAM 通过 Push-T 实验评估紧凑世界动作模型中反事实预测与规划误差的来源。用模拟器成本替代预测轨迹评分使覆盖率提升 9.4 至 15.0 个百分点;反事实分支训练使策略重启搜索相对热启动的优势提升 1.5 至 8.0 个百分点。在 Meta-World 开门任务中,带噪专家数据将规划成功率从 78.6% 提高到 88.2%。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
pico-WAM:在紧凑型世界动作模型中评估反事实预测与规划误差
当控制失败时,问题出在策略提出的动作上,还是出在世界模型对这些动作的评分方式上?
Push-T 中的受控干预揭示了改进究竟在何处起作用。该研究使用了 206 条示范数据和 15 个训练种子。
用模拟器代价替代预测轨迹分数可以提高覆盖率。仅在候选动作生成阶段替换为模拟器状态则未观察到可检测的增益。
配对 95% 区间:9.4 至 15.0 个百分点。
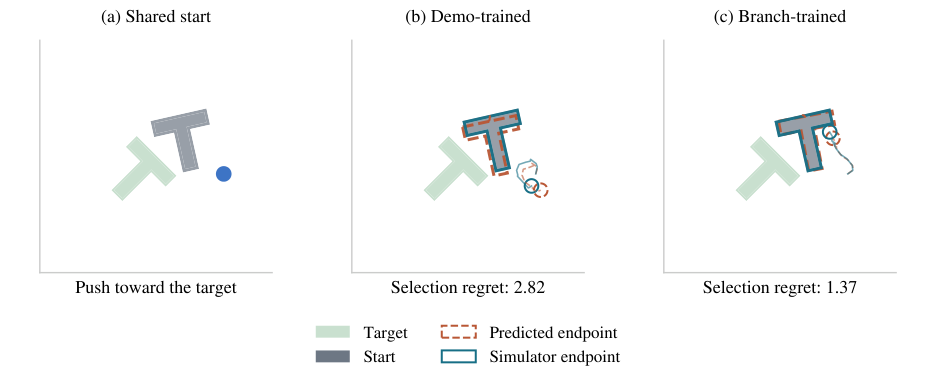
反事实分支训练增大了策略重启搜索相对于热启动搜索的覆盖率优势。在两种数据机制下,重启均胜出。
配对 95% 区间:1.5 至 8.0 个百分点。
在该规划器中,评分是一种有效的干预手段。这些实验并未确立最优候选动作、误差的普适排序,或相对于模仿学习的优越性。
一个共享表示连接了模仿学习、动作条件动力学和物理状态读出。一个外部规划器对想象的动作序列进行比较。
在 Meta-World 开门任务中,含噪专家数据改善了候选排序和规划器成功率:88.2% 对 78.6%。两个规划器仍低于反应式 BC 的 98.6%。
该实验使用独立的状态空间模型和固定的数据/候选库;并未测试共享架构的迁移能力。
排序遗憾包含智能体接近程度以及方块到目标的距离。更好的遗憾值不一定意味着更好的方块运动。反应式策略和规划器的观测频率也不同。
主要的暖启动/重启和评分对比均在固定观测频率下进行。
当世界动作模型在控制上失败时,瓶颈是候选动作生成还是轨迹评分?我们提出 pico-WAM,一个带有给定物理状态的紧凑模型,用于追踪策略与动力学之间的交互。使用 206 条 Push-T 示范数据和 15 个训练种子,我们比较了不同数据机制和搜索配置。反事实分支训练改善了短时域代价排序,并将策略重启搜索相对于热启动搜索的覆盖率优势扩大了 4.8 个百分点;在两种数据机制下重启均胜出。用模拟器代价替代学习到的轨迹分数在保留学习到的候选动作的同时将覆盖率提高了 12.2 个百分点。仅在候选动作生成阶段替换为模拟器状态则未观察到可检测的增益。组件诊断和一项独立的开门研究说明了为什么更好的排序不一定带来更好的控制,也不一定超越模仿学习。这些受控干预将评分确定为测试场景中有效的改进目标,并提供了一个用于诊断紧凑世界模型的可复现协议。
从已安装的代码检出中,可以重新生成图表、回放已保存的决策,或运行一个微型实验流程。完整重训练另有文档说明。
重新生成论文图表和数值
python reproduce.py figures
回放已完成的决策
python reproduce.py trace
运行微型因子实验流程
python reproduce.py smoke
归档报告的重生成和微型检查不能确立完整的独立数值复现。原始预训练检查点未包含在内。
Keivalya Pandya · arXiv:2611.01039 · 2026 · 预印本
title = {{pico-WAM}: Evaluating Counterfactual Prediction and Planning Error in a Compact World Action Model}, author = {Pandya, Keivalya}, year = {2026}, eprint = {2611.01039}, archivePrefix = {arXiv}, primaryClass = {cs.RO}, url = {https://arxiv.org/abs/2611.01039}
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。