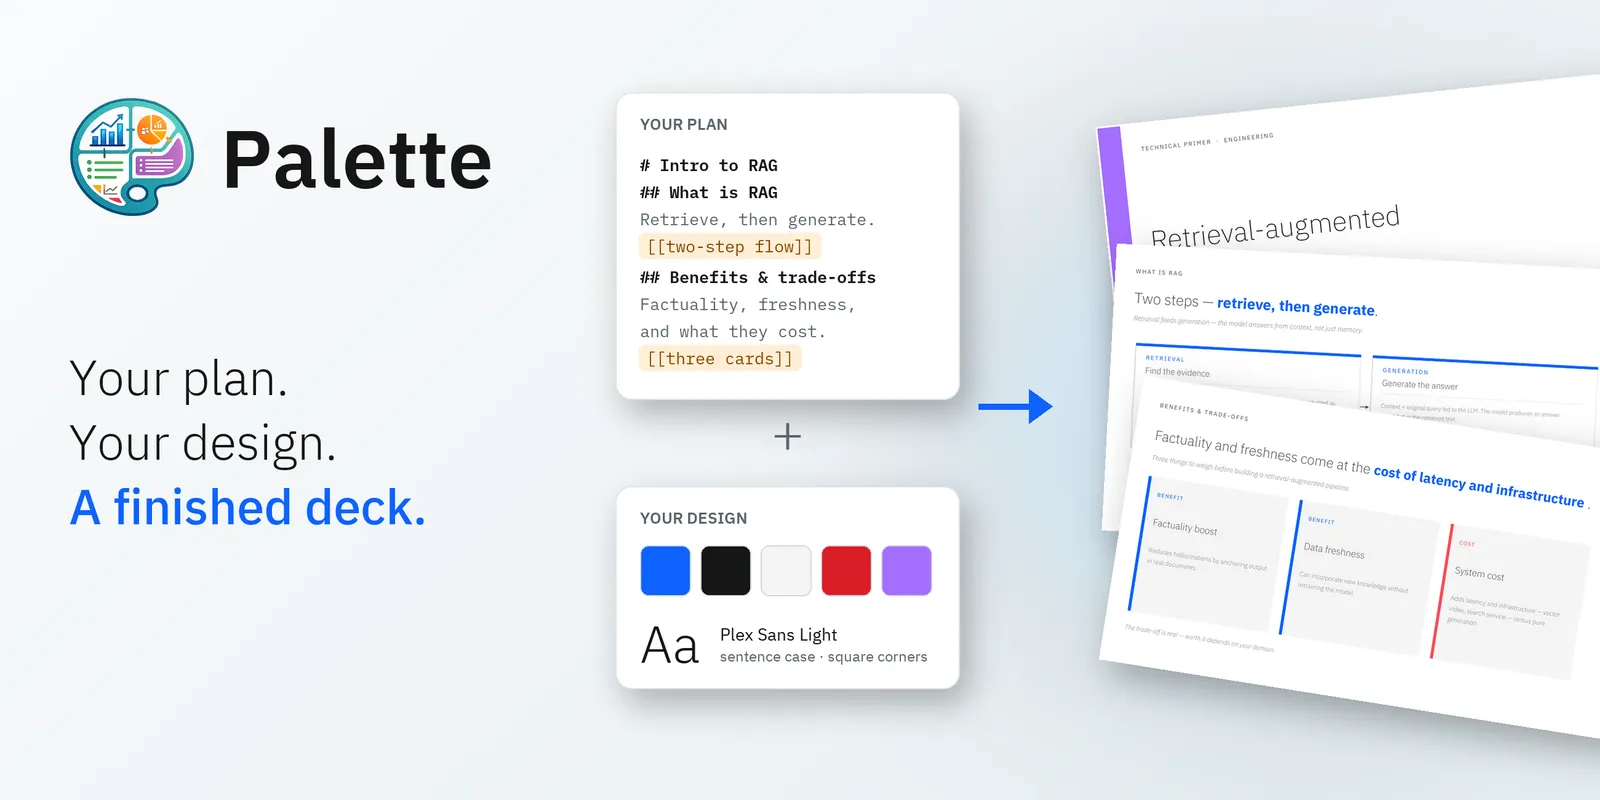
IBM Research 训练小型模型 Palette,按企业设计语言生成演示文稿
来源标题:Palette: Teaching a small model to build decks in your design language
IBM Research 发布 Palette,用自建的小型模型按企业自家设计语言生成幻灯片,避免前沿模型的统一风格,并让机密内容留在本地基础设施。模型经设计-编码协作、推理合成与检查和修复流程训练,并已在评测中验证。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
回到文章 Palette:教一个小模型用你的设计语言构建演示文稿 企业文章 已发布 2026年11月3日 点赞 9 +3 Praveen Venkateswaran praveenv 关注 ibm-research Anupama Murthi anupamamurthi 关注 ibm-research Hamid Adebayo harmedox 关注 ibm-research 为什么演示文稿对小模型来说很难 像人一样构建:一个设计师和一个程序员 合成演示文稿及其推理过程 用自然语言引导演示文稿 构建检查与修复框架 评估 下一步 我们学到了什么 让前沿模型做一份幻灯片,你会得到一份不错的成品。但要十份,它们就开始变得千篇一律:同样雅致的默认样式,同样的固定风格,隐约透出一股“AI 生成”的味道。这本身没什么问题,直到你希望演示文稿长得像你自己的模板。前沿模型有它们自己的固定风格,再怎么提示也阻止不了它们漂移回去。而且有时候内容属于机密,根本不能离开你的系统。 这两点都指向一个你自己拥有的模型:开放权重、运行在你自己的基础设施上、用你自己的设计语言训练。问题在于,小型开放模型——也就是你真正会自托管的那种——在这方面表现很差。它们做出来的演示文稿是坏的:标题融进背景里消失不见,文字跑出幻灯片边界,形状互相堆叠。 Palette 押注在一件事上:一个小型开放权重模型,用你的设计语言合成数据训练,并由一个检查框架把关,能否与前沿系统一较高下,同时让你保有对结果的所有权。我们微调了一个 20B 模型,让它像人一样构建演示文稿:由设计师规划整份文稿,由程序员绘制每一页幻灯片。它的训练数据遵循 IBM 设计语言,在 PresentBench 上,它在我们测量的三个领域中两个排名第一。本文介绍我们如何合成数据、训练模型,并在它周围构建检查框架。 为什么演示文稿对小模型来说很难 一份幻灯片看起来简单,但制作它要求模型做三件小模型不擅长的事。 它在看不见幻灯片的情况下进行布局。模型并不直接绘制幻灯片;它编写代码,把每个元素放置在指定的 x、y、宽度和字号上。一个 75 字符的标题在 56pt 下能否放进两行,是模型在脑内做的算术,而它只有在代码渲染之后才会发现算错了。小模型经常在这里出错,重叠的形状和跑出边界的文字就是这么来的。 它同时做两类决策。决定每页幻灯片说什么、怎么呈现(用图表还是表格?砍掉什么?)是编辑判断。精确摆放则是几何问题。一次生成要在 10–20 页幻灯片上同时完成这两件事,还要保持配色、字体和布局一致。 没有数据展示演示文稿是如何做出来的。成品文稿大量存在,但设计选择背后的理由、以及生成它们的代码,都不存在。 像人一样构建:一个设计师和一个程序员 没人能一遍就把演示文稿做完。你先决定故事(多少页、每页说什么、哪页用图表哪页用表格),然后才构建每一页。Palette 用同样的方式拆分工作,分成两个角色,由同一个 LoRA 适配器承担: 现在每个角色只做一类决策:设计师负责编辑判断,程序员负责几何布局。两者之间的任务书可读可编辑,所以人或 agent 可以改动某一页的布局,而不必重新生成整份文稿。而且因为每页幻灯片的上下文在任何代码写出之前就已固定,程序员的调用可以并行执行,每页一个,这让编码阶段快了约 6–7 倍。 我们用 LoRA 而不是全量微调来训练适配器:它在一个能力足够的基座之上教会一种格式和一项技能,同时不扰乱基座已有的知识,也让每次实验成本很低。一个教训:程序员的样本比设计师的样本长约 5 倍,所以朴素混合会让设计师训练不足,直到我们将其样本过采样 5 倍。 合成演示文稿及其推理过程 不存在公开的语料库,包含规划、设计决策和幻灯片代码,所以我们用一个大型开放教师模型来生成。每份文稿都从一个配方开始,配方设定其体裁、长度、布局和任何用户指令,这样我们就能控制数据的覆盖范围。规划从整齐的大纲到原始的内容堆砌都有,让模型学会删减和压缩。我们生成了大约 1000 份文稿,覆盖约 10,000 页幻灯片。 每个样本还附带了背后的推理,以反事实的形式写出:推理轨迹会权衡一个替代方案并说明为何被否决,这样模型学到的是选择背后的规则,而不只是选择本身。设计师对内容和形式进行推理。例如: “四个季度的营收,有一个清晰的上升趋势。我考虑过用表格,但这页的重点是趋势,不是具体数字,所以柱状图能让人一眼看出。” “标题有 62 个字符。在 44pt 下会折成三行并撞到下方的图表,所以我设为 36pt,这样能放进两行,并在图表上方留出空间。” 单靠教师模型并不能让数据变好;围绕它的循环才行。每份合成的文稿都会被渲染,并由推理时检查框架所用的同一个检查器检查重叠和溢出。坏掉的幻灯片会被修复,其推理被重写成同样的反事实形式,涵盖原布局错在哪里、修复为何有效。检查器抓到的每个错误都会变成一个更好的训练样本。 最难的问题是忠实性。最糟糕的失败是幻灯片上出现输入中没有的事实,我们发现提示规则无法防止这一点。如果任务书要求一个六乘五的表格,却只带了三个要点,程序员只能编造其余部分。 解决它的是参考文稿,而不是规则:固定一份参考文稿能可靠地改变教师模型的输出,而添加一条规则很少能做到。教师模型在提示中看到几份参考文稿,就会大量模仿它们,远多于遵循指令。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。