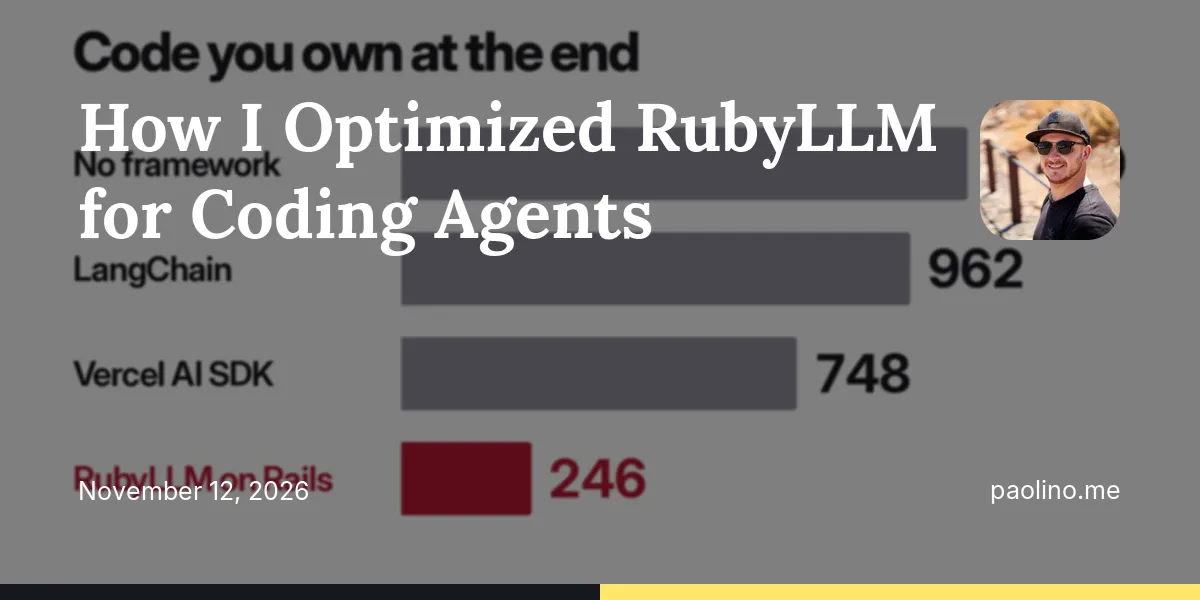
开发者用同一应用对比测试四个AI框架,证明框架仍有必要
来源标题:How I optimized my library for coding agents
开发者让Codex在GPT-6 Astra上分四次用不同方案构建同一个真实聊天应用,包括RubyLLM on Rails、LangChain/LangGraph、Vercel AI SDK以及无框架的纯Ruby,以反驳“现在不需要AI框架”的说法。应用分十一步构建,涵盖流式输出、对话、取消、成本追踪、多提供商切换、回退、重启恢复、工具审批、文件与代码沙箱、MCP及Gemini、Azure、Bedrock。每一步后均运行测试套件验证。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
你今年肯定听过这种说法。也许你自己也说过:“你不再需要框架了。让 agent 自己写就行。何必依赖别人写的 gem?”
这种论调正在蔓延。我的朋友 Andrzej Krzywda 每场 Ruby 大会都去,跟谁都能聊上几句,几周前他写道,他遇到的开发者里有 40% 正在试图重新造 RubyLLM——也就是我写的那个 AI 框架。当然,这只是一个人的印象。但你能感觉到这种气氛。
我觉得这是扯淡,而且我想证明它,而不只是嘴上说说。
于是我拿了一个 coding agent——GPT-6 Astra 上的 Codex,一个非常能打的——让它把同一个应用做了四遍:一遍用 Rails 上的 RubyLLM,一遍用 LangChain 和 LangGraph,一遍用 Vercel AI SDK,还有一遍完全不用框架,就用纯 Ruby,不引入任何 AI 库或 provider SDK。每个框架只要有官方 agent skill,就用官方的。
这个应用是一个真实的聊天应用,分十一步构建,每一步都是在同一个项目上开一个新的 agent 会话:流式输出、会话、取消、成本追踪、一个可以在对话中途切换的第二个 provider、fallback、重启后存活、工具审批、文件和代码沙箱、MCP,然后是 Gemini、Azure 和 Bedrock。每一步之后,都有一套 agent 永远看不到的测试套件在真实浏览器里驱动这个应用,并在每个 provider 上重跑所有检查,到最后共 198 项检查。provider 都是用真实录制的响应构建的假实现,所以每个技术栈收到的回复、错误和卡顿都一模一样。
不用框架,agent 也做到了。Bedrock 上的流式输出?搞定。Gemini 上的工具?没问题。说实话,它真的很擅长这个。
但它写下的每一行代码都是你要维护的代码,覆盖每个 provider 上的每个功能,而每个 provider 的流式输出、工具调用、缓存和 token 计数方式都不一样。为了从 Bedrock 流式输出,agent 手动用 AWS Signature Version 4 给每个请求签名,然后逐帧解码 Amazon 的二进制事件流,还要校验 CRC。93 行。它能跑,但我再也不想看第二眼。而用 RubyLLM,同一个 agent 只写了四行配置,Bedrock 就获得了审批、fallback、缓存和取消——应用本来就有的全部能力。
那么,结案了?框架重要?先别急。
在我最初的几次运行里,RubyLLM 已经装好,我自己的 skill 也加载了,agent 仍然会:
- 跳过框架,自己手写 provider 调用;
- 在 RubyLLM 已经处理好流式输出之后,又自己写一套流式处理;
- 凭记忆抄价格,而不是调用框架;
- 在同一个项目里同时用两种方式实现同一件事。
这就是最糟的组合:依赖还在,agent 又在它上面叠了自己的代码。
agent 不笨。它会走它能看见的最省事的路,而当它看不见框架提供的路时,它就会自己写一条。所以框架只有在 agent 能好好用它们的时候才重要。这一点每个月都更重要,因为越来越多使用 RubyLLM 的代码是 Claude Code、Codex 和 Cursor 写的。所以这一轮我把 coding agent 当作 RubyLLM 的主要用户,把这个基准测试变成一个循环:agent 在 RubyLLM 的主分支上构建应用,我读会话记录,找出它们在哪里卡住、在哪里写了本来不该写的代码,我在问题所在的地方修掉根因(gem、generator、文档或 skill),然后再跑一遍。我现在跑到第 28 轮了,以下是我学到的。
我的直觉是去调 skill,也就是 agent 加载的指令文件。我试了好几个版本,然后跑了一个对照:用 RubyLLM 旧的、未改动的 skill,配上修好的库。效果和我调过的版本差不多。大部分提升——从 5 次首轮尝试 0 次干净通过,到 8 次全部通过——来自修 RubyLLM 本身,因为 agent 绊倒的地方是真实的 bug 和糟糕的默认值:
- generator 建议了一个并不存在的模型名;
- 安装说明让 agent 去改一个本来无需改动的文件;
- 文档示例和真实 API 不一致;
- 默认值在 Rails 里含义不同。
没有任何 prompt 能修好一个行为错误的库。如果 agent 一直在绕开某个东西,那它多半是坏的。
有些糟糕的默认值看起来完全合理。沙箱 generator 建议在 code_execution 旁边加上 file_store。在 Rails 里,裸的 file_store 指的是 Active Storage,于是沙箱里的代码从一个空文件夹启动,看不到上传的文件。每个照做的 agent 都在同样的两项检查上失败,而忽略它的 agent 都通过了。
agent 会原样照抄它们看到的东西,所以每个示例、generator 消息和默认值都必须按写出来的样子就是对的。
反过来:当每个 agent 都加上同一个东西时,它就属于这个库。每一次 RubyLLM 尝试都在首轮挂掉“一个巨大的工具结果”这项检查,而每一次都用同一行代码修好——一个 context budget。那行代码现在是一个全局设置,安装 generator 会为新应用写进去。(#1562)
在一轮又一轮的运行里,agent 会在 gem 里 grep 同一个事实:anthropic_api_base 是否包含 /v1/messages?等文档覆盖了这一点,我就把它从 skill 里拿掉,结果 8 次运行里有 5 次 agent 又直接回去 grep 源码。没人在写 initializer 写到一半时去翻指南。
所以这个事实又回到了 skill 里,而且 RubyLLM 现在会拒绝带 endpoint 路径的 base URL,并给出一个说明它期望什么的错误。(#1566)错误信息是 agent 跳不过去的文档。
那次 grep 的源头是我自己的建议。最初的 skill 说要从已安装的 gem 开始,agent 就字面照做了:头几分钟里读了几十处源码,还有一条命令打印了一兆字节。读一份指南比读 chat.rb 便宜得多。
现在 skill 对每个功能都指向指南(#1480),每个文档页面也提供 Markdown 版本,还有一个 llms.txt,skill 则是一个简短的核心,只在需要时加载引用(#1618)。它随 gem 一起发布,所以永远和已安装的版本匹配。
就算指向了正确的地方,agent 也可能被劝服不照做。在第一次试点里,两次 RubyLLM 尝试都知道 RubyLLM 会给调用定价,但两次都推翻了它,因为它们加载的另一个 skill——Claude Code 自带的 API skill——列出的 cache-read 价格比 Anthropic 自己的定价页面高出一倍。RubyLLM 是对的。那次试点里全部四次尝试、每个技术栈,都恰好在这个数字上挂掉了成本检查。
所以 RubyLLM 的 skill 现在明确写着:成本从 RubyLLM 读取,绝不要从另一个 skill、一篇文章或记忆里抄价格。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。