新研究让大模型直接读写神经网络权重,绕过传统训练流程
来源标题:[AINews] LLMs can read & write neural network weights: "Weight Space Programming" cuts Autoresearch out of the RSI loop
研究者提出「Weight Space Programming」方法,让智能模型直接读取并编辑较笨模型的权重,无需编写训练代码。演示中通过编辑 Qwen 的权重来减少其推理循环。该工作将模型自主训练从传统写代码、跑实验的流程中解放出来。
以下正文由 AI 翻译自 Latent Space(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在AI/科技市场持续深陷熊市(颇具黑色幽默意味)之际——Anthropic债券被评为“垃圾”级,OpenAI融资消息占据头条——我们依然在社区中不断看到令人惊讶的能力发现,比如今天这一项。
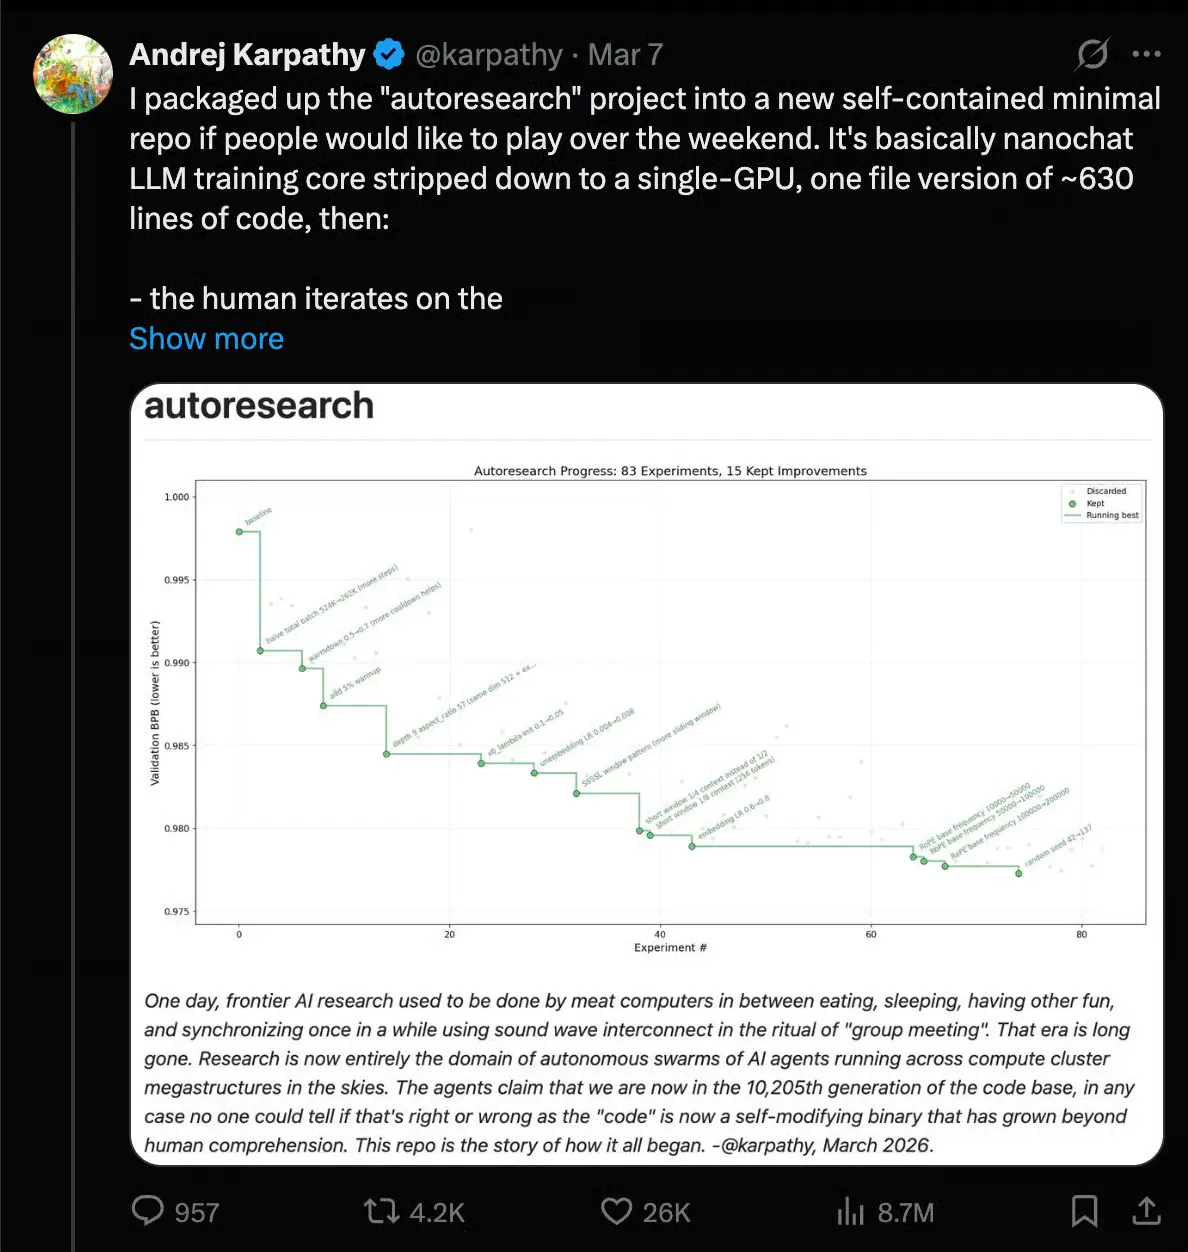
要为今天这篇重磅论文提供背景,最好的方式是回顾仅仅8个月前Karpathy的autoresearch,它预示了一个充满递归自我改进恐惧的夏天:
抽象地说,这项演示表明,你可以拿一个足够聪明的模型,通过在一个计算集群上运行一系列实验,在无需人类专业知识或干预的情况下自主训练一个模型。然而,这通常需要经历一个繁琐的过程:编写PyTorch/Jax代码、运行计算、观察损失曲线、阅读评估结果、优化内核和数据等等。
那么,上个月的嘉宾Alex Zhang回来参与合著了一项重大发现:如果你直接让一个聪明的模型去读取和编辑一个较笨模型的权重,会怎样?
在机器学习领域,这相当于不看源代码,直接查看(非常小的)编译可执行文件的1和0,并且能够1)判断它们做什么,2)在给定失败轨迹的情况下一次性修复bug,或者用50步朝着某个大方向改进(此处可能夸大),3)一次性从头编写整个网络权重,击败一些独立训练的模型。
如果你相信LLM在给定足够参数的情况下能够真正拟合和模拟一切(事实上,随着规模增大,LLM作为计算器越来越强),那么这样的事情在理论上注定会发生,但这项能力突然涌现仍然令人惊讶,而且似乎已经有人独立复现了:
当然,我们真正建模的这件事本质上是某种形式的机制可解释性(可以手工完成),目前不太可能扩展到比简单游戏和RL策略更高级的任务,但世界在这个全新的RSI能力上已经从0走到了1……由于其惊人的效率,这将立即被投入使用和探索。
2026年10月31日至11月2日的AI新闻。我们检查了12个subreddit、544个Twitter账号,没有进一步检查Discord。AINews的网站允许你搜索所有过往期号。提醒一下,AINews现在是Latent Space的一个板块。你可以选择订阅/退订邮件的频率!
AI Twitter回顾
DeepSeek开源“超级智能体”框架原型
- 发布:DeepSeek-Harness发布了一篇长篇设计文章(文章)和dsh-superagent-prototype仓库(仓库链接)。随后发布了官方英文版(@tianyi)。
- 架构:一个长期存活的路由会话与人类对话并分发工作。隔离的worker并行运行任务,由GitHub事件触发(摘要)。
- 声称的结果:在DeepSeek自己的测试中,与使用子智能体的单一会话相比,p95完成时间从29.5分钟降至15.7分钟(摘要)。
- 审稿人的设计理念:最终审稿人崔添翼(@tianyi)表示,“超级”指的是工作智能体之上的一层,而非更优越的智能。他将核心权衡概括为跨任务连续性与吞吐量之间的取舍(知乎摘要)。
- 声明的局限:该框架目前没有内置的跨会话长期记忆。状态、计算和环境的分离基本未实现。该原型仅在一个小型、可信的内部环境中验证过,安全、隐私和智能体间通信仍是未解问题。
- 先前工作:他承认其他团队几个月前就探索过类似架构。
- 从业者反馈:@badlogicgames表示该设计与Earendil的方向一致:单一长期存活的实体、临时递归委托和跨系统事件触发。@omarsar0称其为协调-执行框架设计的“大师课”。DeepSeek还表示,其目标是每一代模型都支持pi和其他主要框架(@tianyi)。
- 批评:@teortaxesTex称这篇文章“有点一团糟”。他认为DeepSeek围绕模型的弱点(如幻觉)构建了内部拐杖,而不是让系统普遍鲁棒。他还指出彭博社报道了一个没有英文公告的仓库(帖子)。
- V4.1命名混乱:中国人民大学FlashRSI的README引用了deepseek-v4.1-pro,引发了发布猜测。Teortaxes称这是一个占位符:实际配置使用的是v4-flash和v4-pro,deepseek-v4.1-flash不是有效ID(推文串、后续)。他还表示V4.1F-1017的API指纹没有变化(指纹)。 独立评估与前沿模型信号
- GDPx基准(SemiAnalysis):该基准涵盖11个有经济价值的领域的206个智能体任务,包括芯片设计、SWE、金融和生物学。最佳模型仅得分12%(发布)。
- 结果:Opus 5.5以12%领先。Gemini 4 Carbon以10.9%紧随其后,成本约低4倍(细分)。
- 反应:@dylan522p向Google道歉,称Carbon“更尖峰”但在某些领域非常强。@demishassabis对该基准表示欢迎。
- 分析:@eliebakouch发现,移除受保障措施影响的基准后,情况会发生变化。在这种视角下,Carbon仍然便宜,而Sol 6.1更便宜。他还暗示OpenAI的生物安全保障比Anthropic更强(说明)。
- 同系列比较:Sol 6.1和Astra得分非常接近,Carbon全面击败Argon,Sonnet在SWE方面很强(比较)。
- 可能的bug:一些Argon网络安全运行可能受到Antigravity bug的影响(报告)。
- 审计担忧:一篇讽刺帖子抱怨GDPx不开源且审计成本高昂(帖子)。
- Epoch能力指数:DeepSeek V4.1F-1017得分159,与GPT 5.5持平。这比V4.1F-0910高3分,比V4-Pro高10分;Astra大约高出10分(@teortaxesTex)。
- 与Mythos的差距:@scaling01指出,大约7个月后,仍没有中国模型能匹配Mythos Preview(约161 ECI)。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。