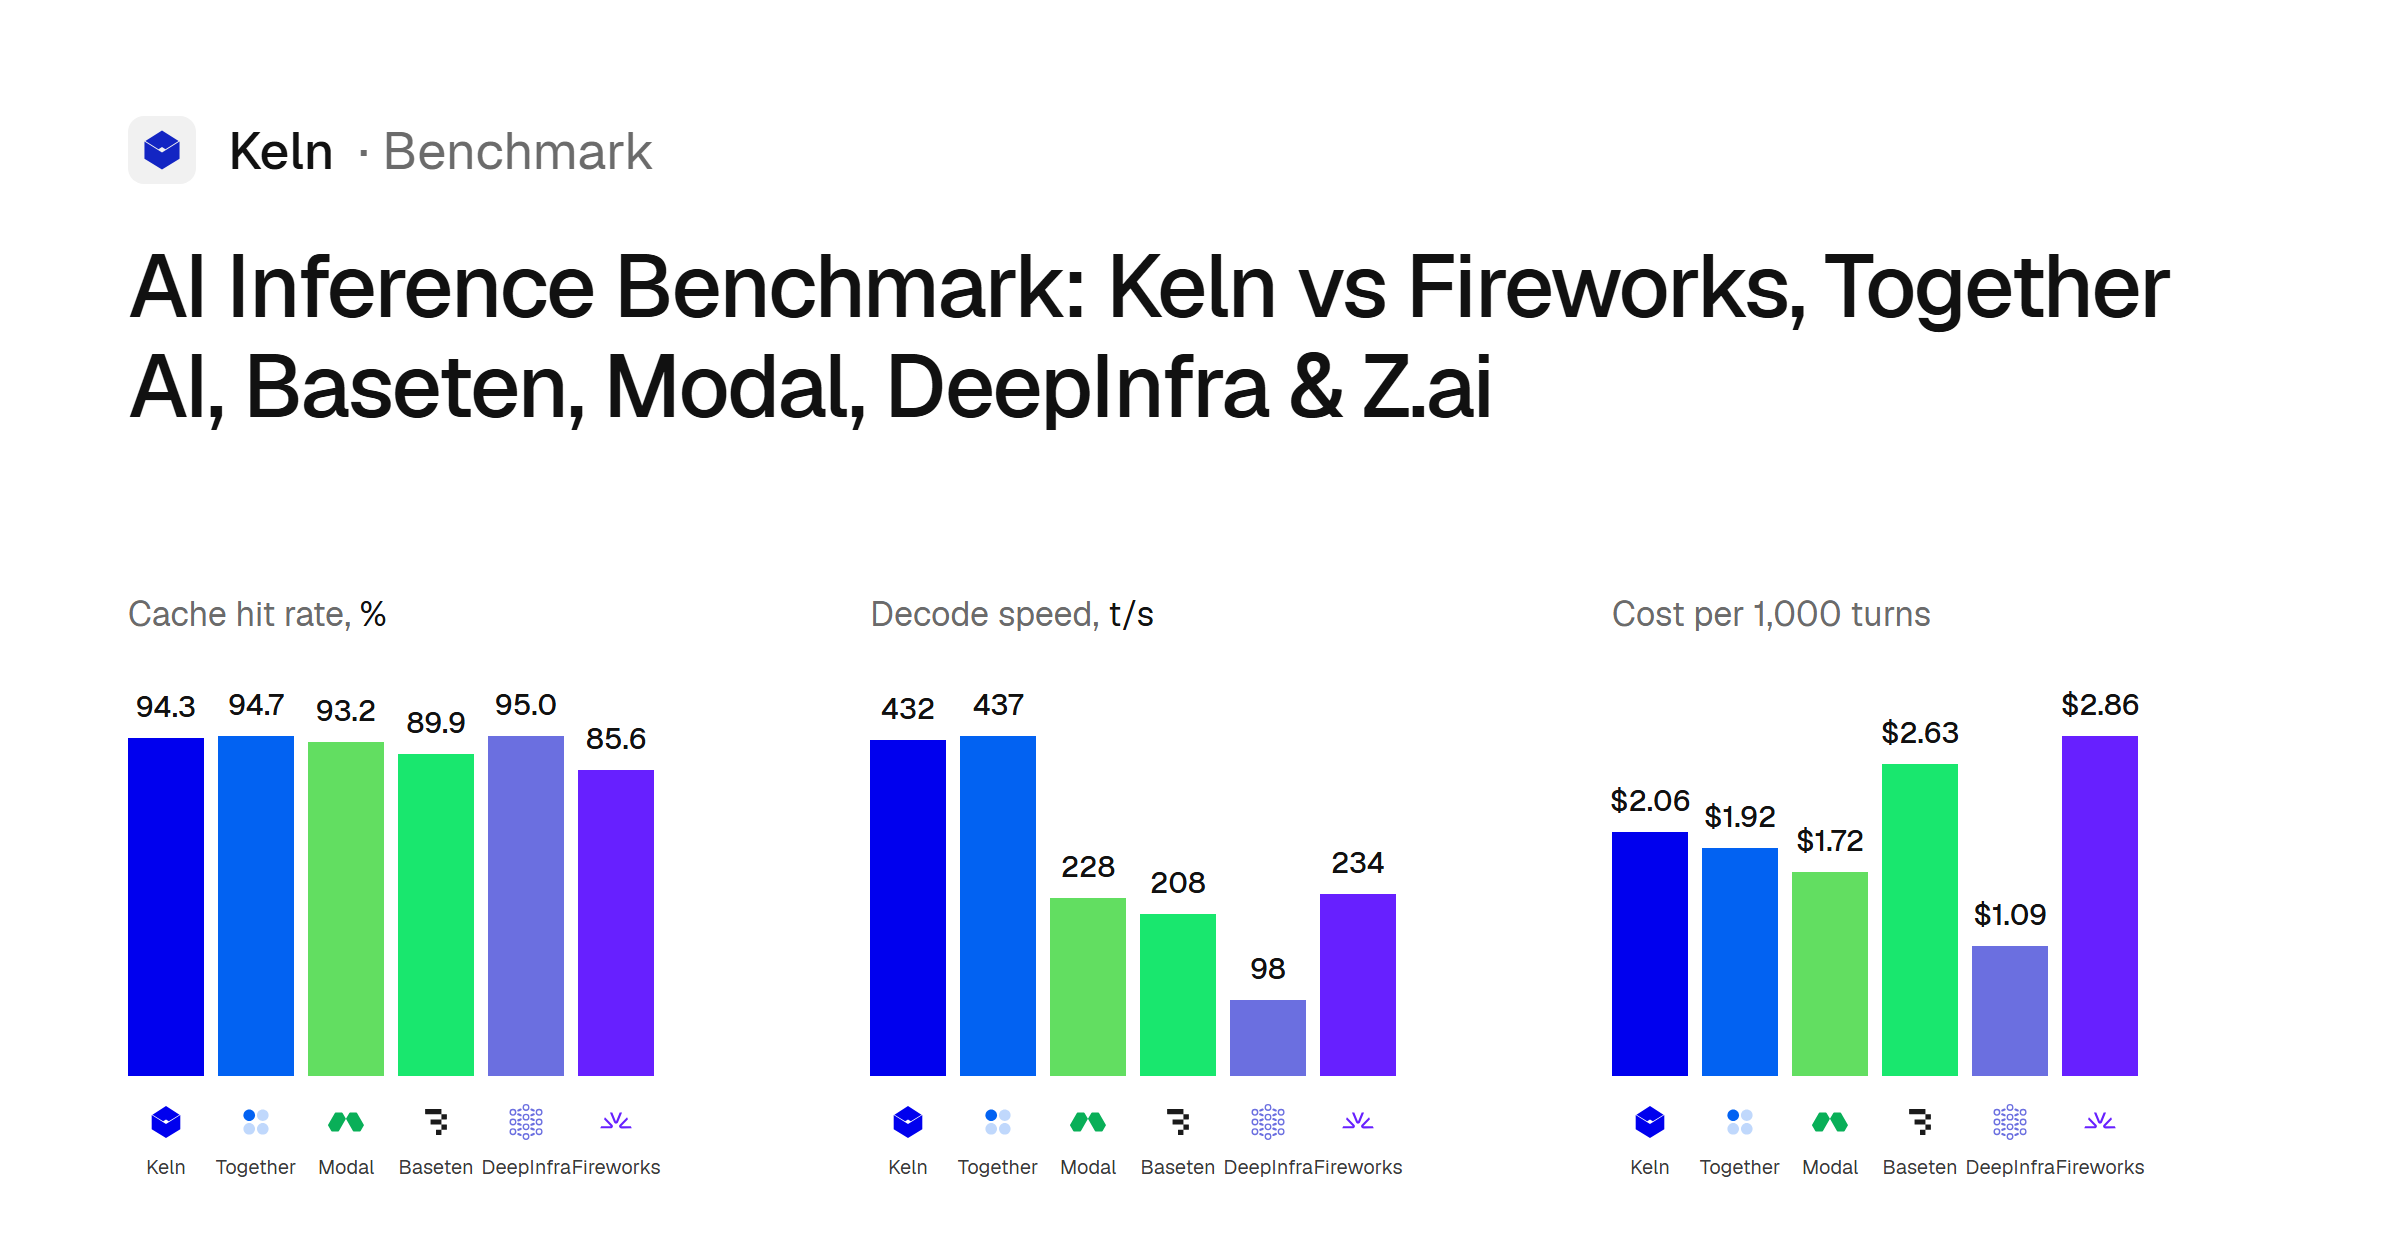
Keln 与 Fireworks、Together 等七家推理服务商跑分对比
来源标题:We Benchmarked Fireworks, Together, Baseten, Modal, DeepInfra, Z.ai and Keln
Keln 联合 Fireworks、Together AI、Baseten、Modal、DeepInfra、Z.ai 对 DeepSeek V4.1 Flash 1017 和 GLM-5.3 Flash 进行了推理基准测试,采用带工具调用和最高推理强度的真实 agent 会话。结果显示 Keln 与 Together 的回合应答率均达 100%,解码速度约 432 至 437 token/秒,明显快于 Modal、Baseten 和 DeepInfra。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
BenchmarksBenchmarkDeepSeek V4.1 Flash 1017 与 GLM-5.3 Flash2026年11月4日8分钟阅读 AI 推理基准测试:Keln 对比 Fireworks、Together AI、Baseten、Modal、DeepInfra 与 Z.ai 我们在六家推理服务商和 Keln 上测试了 DeepSeek V4.1 Flash 1017 与 GLM-5.3 Flash,使用的是带工具调用、并开启最大推理强度的真实 agent 会话。每家服务商运行相同的对话、相同的顺序,轮次之间的停顿也完全一致。完整方法说明见文末。 复制页面 。 图标来源:Keln 立方体图标来自网关基准测试文章;Together、Fireworks、Baseten、Modal 与 Z.ai 来自 models.dev 服务商图标集;DeepInfra 来自 lobehub 图标集。品牌色在 blog.css 的 .bench--direct 下设置。--> 基准测试结果一览 DeepSeek V4.1 Flash 1017 已回答轮次 占发送轮次的百分比 · 越高越好 100%Keln 100%Together 99.9%Modal 48%Baseten 100%DeepInfra 100%Fireworks 缓存命中率 占 prompt token 的百分比 · 全程 · 越高越好 94.3%Keln 94.7%Together 93.2%Modal 89.9%Baseten 95.0%DeepInfra 85.6%Fireworks 解码速度 token/秒 · 中位数 · 越高越好 432Keln 437Together 228Modal 208Baseten 98DeepInfra 234Fireworks 成本 每 1,000 轮 · 越低越好 $2.06Keln $1.92Together $1.72Modal $2.63Baseten $1.09DeepInfra $2.86Fireworks GLM-5.3 Flash 已回答轮次 占发送轮次的百分比 · 越高越好 100%Keln 90%Baseten 100%Modal 100%Fireworks 100%DeepInfra 100%Z.ai 缓存命中率 占 prompt token 的百分比 · 全程 · 越高越好 90.5%Keln 80.4%Baseten 78.8%Modal 87.1%Fireworks 88.7%DeepInfra 85.9%Z.ai 解码速度 token/秒 · 中位数 · 越高越好 432Keln 247Baseten 129Modal 204Fireworks 176DeepInfra 46Z.ai 成本 每 1,000 轮 · 越低越好 $2.55Keln $2.33Baseten $2.45Modal $2.06Fireworks $1.95DeepInfra $2.15Z.ai 已回答轮次 大多数服务商在两个模型上都完整回答了我们发送的所有请求。Baseten 对 DeepSeek 约有半数轮次以限流错误拒绝:这些 prompt 每个都有数万 token,仅同时 2 个会话就超出了我们账户的限额。在 GLM-5.3 Flash 上,中断让负载保持得更低,因此 Baseten 在那里拒绝的轮次更少。 Modal 在 DeepSeek 上中断了 1 条流,而在其他所有服务商上回答都正常结束。直接调用 Modal 的应用会收到被中断的流,并且必须自行重发该轮请求,因为没有第二个服务商可以转发。 跨多个服务商运行推理,在对话于它们之间迁移时可能损害 prompt 缓存。在 DeepSeek 上,Keln 仅在 1,440 轮中的 1 轮切换了服务商,使其缓存命中率保持在 94.3%,接近最佳直连服务商的 95%。在 GLM-5.3 Flash 上,Keln 达到 90.5%,是 6 家中最高的。 Fireworks 在 DeepSeek 上的冷轮次最多:165 轮,而 Keln 为 11 轮。每个冷轮次意味着要重新读取大部分 prompt,而不是使用已缓存的 token。 基于各服务商自身的用量。冷轮次指首个轮次之后缓存占比低于 10% 的任何轮次。 我们还测试了当对话进入空闲状态时,各服务商保留缓存 prompt 的效果。在 GLM-5.3 Flash 上,我们为 15% 的轮次加入了 1–20 分钟的中断,所有服务商使用相同的时序。 在 15–20 分钟的中断后,Keln 仍有 63.0% 的 prompt 处于缓存状态,而 DeepInfra 为 38.4%,Z.ai 为 16.5%。Baseten、Modal 与 Fireworks 均为 0%。 Keln 在 GLM-5.3 Flash 上取得了最高的中位解码速度,为 432 token/s,比第二快的 Baseten(247 token/s)快 75%。 在 DeepSeek 上,Keln 与 Together 几乎持平,分别为 432 和 437 token/s,均明显领先于其他服务商。 首 token 为 p50 / p95,统计的是首个推理 token。 我们对每个请求都将推理强度设为最大。所有服务商返回的推理 token 数量大体相近,包括 Keln。 在我们之前的基准测试中,两个网关在相同请求下返回的推理 token 不到一半。这次我们没有看到该问题。 Modal 不报告 GLM-5.3 Flash 的推理 token,因此这些结果未纳入。 Fireworks 在 DeepSeek 上最贵,主要原因是其 165 个冷轮次。它处理的未缓存 prompt token 是 Keln 的 2.5 倍。 在 GLM-5.3 Flash 上,Keln 属于偏贵的选择。其定价覆盖的不只是模型推理:Keln 跨服务商管理容量、监控性能与输出质量,并处理故障转移与重试。你通过一个 API 获得这一切,无需自行管理服务商账户、限流或缓存。 Baseten 每 1,000 轮的成本只统计它回答了的轮次。 直接对接推理服务商可能更便宜,且在容量充足时性能可以非常出色。但你受限于该服务商的基础设施和你的账户限流。 我们在本次基准测试中看到了这些限制。Baseten 因限流拒绝了请求,Modal 在流中途中断了响应,Fireworks 不得不重新处理此前已缓存的 prompt。 Keln 采取了不同的方式。它跨多个服务商运行推理,在一个 API 背后管理容量、性能与可靠性。在本次基准测试中,Keln 完成了每一轮,解码速度达到或超过最快的直连服务商,并在较长中断后保留了更多缓存 token。 Keln 不是最便宜的选择,但价格包含了基础设施管理、故障转移与重试——否则这些都需要你自己处理。 我们发布基准测试时会附带方法说明。上一次测试对比了 OpenRouter、Vercel、Ramp 与 Keln 在 DeepSeek V4.1 Flash 上 24 小时的表现:点此阅读。 我们使用了 Hugging Face 上公开的 armand0e Claude Code 语料中的 8 个会话,以原生工具调用方式回放。每条记录下来的 assistant 轮次都作为新请求发送,并附上原始工具结果,因此对话会像原始会话中那样逐步增长。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。