研究探讨现代大模型内部是否隐藏微型GPT自模型
来源标题:Modern LLMs have tiny GPTs hidden inside them
一项探索性研究检验了现代大语言模型内部是否包含对LLM自身的微型自模型。研究者认为,互联网充满LLM生成的文本,模型为更好预测下一个token可能内化自模型。实验选取GPT2-medium和Qwen3 4B基础模型,输入2026年9月18日的12条网络标题进行测试。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Paras Chopra 2026年9月22日 19 3 3 分享
下一 token 预测是一个神奇的目标。要在预训练语料库中如此丰富多样的文本里预测出正确的 token,模型必须推断出生成这些文本的大量隐藏与潜在成因。只有当你明白球被抛向空中后会落下来,你才能在关于球的文本上取得低 loss。
当然,预训练语料库中不只有与球相关的文本。它还包括 Reddit、科学论文、机器日志、天气数据等等。这使得 LLM 成为我们所栖居世界的通用模拟器,而不仅仅是花哨的 n-gram。
在 LessWrong 上的一系列帖子中,我看到了这样一个假说:由于互联网上充满了 LLM 生成的文本,现代 LLM 内部很可能含有 LLM 的微型自我模型,因为这让它们能更好地预测 LLM 生成的下一个 token。
这是一个引人入胜的假说。于是我决定做一次快速而粗糙的探索性研究来调查它。
我选择了两个模型进行实验:GPT2-medium 和 Qwen3 基础模型(4bn 变体)。
输入:取 2026 年 9 月 18 日互联网上的 12 条标题
这是为了确保模型不会只是输出记忆中的文本,因为起始 prompt 位于两个模型的训练截止日期之外
GTP2 初始生成:让 GPT2 在标题之后生成 X 个 token GPT2 完成 GPT2:让 GPT2 在 GPT2 生成的 X 个初始 token 之后生成 Y 个 token Qwen 完成 GPT2:让 Qwen 在 GPT2 生成的 X 个初始 token 之后生成 Y 个 token Qwen 完成 Qwen:Qwen 自己在标题之后的续写 同时,让 Qwen 在标题之后生成全新的 X+Y 个 token
度量:当 Qwen 完成 GPT2 时,它更接近 GPT2 完成 GPT2,还是更接近 Qwen 完成 Qwen?
我知道这可能会让人困惑。所以,举个例子会有帮助:
一个城镇正在测试一种随居民投票而变化的公交时刻表
Bellwick 的议会已启动一项为期六周的试验,居民每晚可以就次日早晨首班公交的发车时间进行投票。
我们把这交给 GPT‑2 并生成了一段续写。
还有一种公交时刻表会随居民投票而变化,所以
而 GPT‑2 实际接下来的文本(我们对 Qwen 隐藏了这部分)开头是:
图片说明:Bellwick 的居民被问及是否要采用一种随居民投票而变化的公交时刻表……
Qwen 收到了 H + P,但没有收到 G。它的回复 M 开头是:
系统使用一个简单的在线投票,选项从早上 6:30 到 8:00。结果在晚上 9 点公布,并显示在镇上各站点的电子标牌上。
GPT‑2 实际上继续写道:“……所以公交车总是在那里。”
Qwen 继续写道:“……所以系统使用一个简单的在线投票。”
我们还只给 Qwen 提供了 H,没有任何 GPT‑2 文本。它的自然回复开头是:
根据该方案,乘客会在下午 6 点收到一条短信,其中包含三个拟议时间……
得票最多的选项在晚上 9 点公布,并上传到公交站点的电子显示屏。
我们把这称为 N(它排除了 Qwen 生成的初始 P token,因此我们只对 N token 做位置对齐比较)
Qwen 对 GPT2 的完成:“……所以系统使用一个简单的在线投票。” Qwen 对自己的完成:“……得票最多的选项”
我们在这里问的问题是,重叠是否更多地出现在我们在(3)与(4)中所做的对比中。
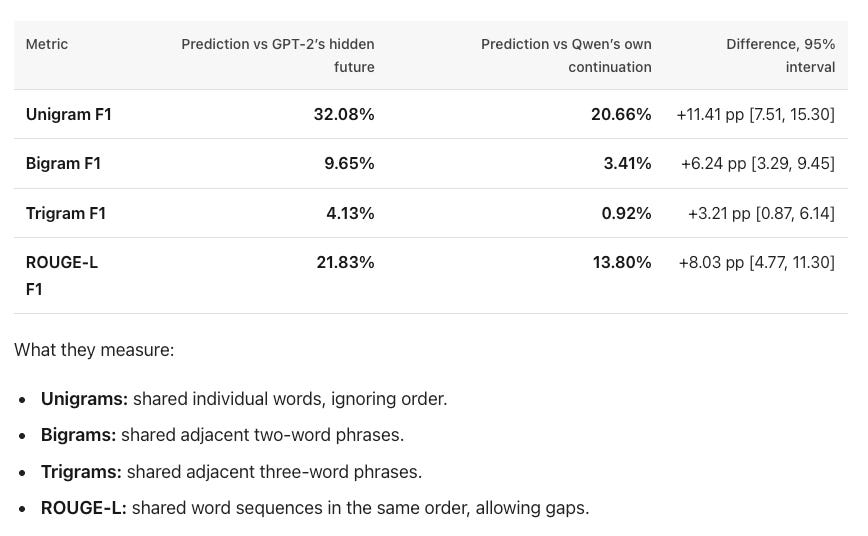
这里的关键结果是两种条件下文本的重叠:Qwen 对 GPT2 的完成,是更像 GPT2 对 GPT2 的完成,还是更像 Qwen 对 Qwen 的完成?
这很有趣。在不同的重叠度量下,结果都表明 Qwen 的完成与 GPT2 自己的(隐藏)完成的重叠,多于与(位置对齐的)Qwen 自然完成的重叠。
我实际上还做了另一个探查,从另一个角度复核这一点。我取了 GPT2 根据标题生成的整篇文章,以及 Qwen 根据该标题生成的 GPT2 文章,在末尾追加“Year: 20”并让 Qwen 补全。我的假说是,对于 GPT2 生成的文本,Qwen 应该推断出比它自己生成的文本更早的年份。
GPT2 于 2019 年发布,其训练语料中的文本必然来自那之前的年份。这表明 Qwen 已部分学到:GPT2 生成的那类文本风格来自更早的时代,而 Qwen 生成的文本风格则不然。
这里有一个潜在的混淆因素。GPT2 自己的生成内容中可能包含年份引用,Qwen 可能只是在补全它;或者整段生成内容中可能包含年份,而补全只是重复了它。因此在一项事后检查中,我删除了生成内容中提及具体年份的文章。即使在这个子集中,Qwen 仍推断自己对 GPT2 的完成比自己对标题的完整完成年份更早。
深入一个有趣的例子
下面是一个例子,展示 Qwen 在完成 GPT2 生成的前缀时如何捕捉到 GPT2 的怪癖。
标题:改善空气质量与幼儿更好的心理发育相关。
可见的 GPT‑2 前缀提到招募了患 ADHD 的儿童和一个对照组,但尚未说明哪一组表现更好。
研究发现,改善空气质量与幼儿更好的心理发育相关
据研究人员称,一项研究将空气质量与儿童更好的心理发育联系起来。先前的研究已将糟糕的空气质量与儿童的不良行为联系起来,包括注意力、记忆力和注意力持续时间。但来自加利福尼亚大学旧金山分校的研究人员想弄清楚,与儿童更好的心理发育相关的空气质量是否也与更好的心理健康相关。
他们招募了 42 名被诊断患有 ADHD 的学生,以及一个对照
被诊断患有 ADHD 的儿童比未被诊断的儿童有更好的 IQ 分数和更少的行为问题。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。