开发者Alexander Panasenko构建带版本记录的共享记忆库KYB,解决AI Agent记忆混乱问题
来源标题:AI Agent Has Amnesia. Mine Keeps Receipts
开发者Alexander Panasenko发布开源项目KYB,用Git支持的共享存储为AI Agent提供带版本和生命周期状态(active、archived、retracted)的记忆。此前Claude、Codex等Agent常把散落的旧Markdown笔记误当作现行方案,重复走已否决的路径。KYB通过替换错误内容而非追加笔记来区分已完成工作与错误知识,目前版本为v0.3.3,尚无对照基准测试。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
AI Agent 会失忆。我的却留有凭据
跨 Claude、Codex 和 Antigravity 数月共享记忆——版本、撤回,以及为什么只追加的笔记总是失败
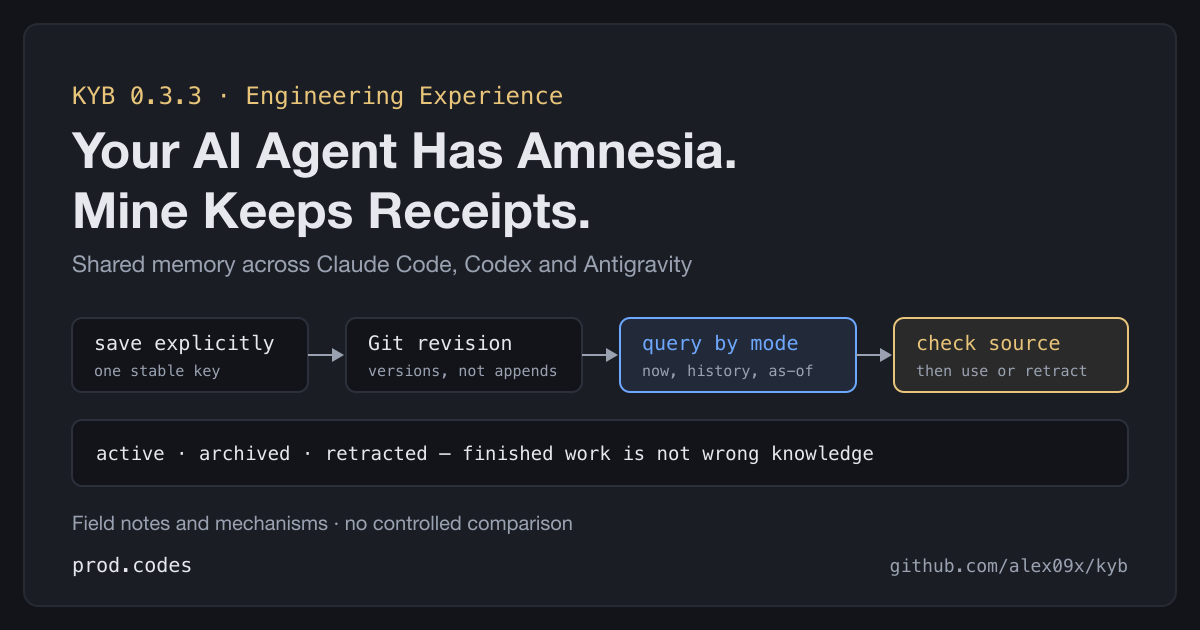
TL;DR。散落的 Markdown 笔记不断把我的 agent 引向我们已经否决的路径。我构建了一个基于 Git 的共享存储(KYB),带有版本化记录和生命周期状态——活跃、归档、已撤回。可以分别查询当前状态、历史记录或某个时间切片;替换错误的文本而不是追加;把已完成的工作与错误的知识分开。本文固定对应 KYB v0.3.3,没有对照基准测试——下面是机制和现场笔记。
在 KYB 之前,我的编码 agent 已经有记忆了:散落在不同地方的 Markdown 文件。缺陷在另一个 agent 回到某个工作区、找到一份较旧的笔记、并把它误认为当前计划时就会暴露出来。在我的经历中,agent 有时会花上几个小时去追一个我们已经调查并否决过的方案。那个文件仍然为旧方案保留着完全合理的论据,而放弃它的决定却存在于别处。
我是 Alexander Panasenko,KYB(Know Your Business)的作者,所以我和这个故事有利害关系:这是我的开源项目。这是我 2026 年夏天到十月间使用 Claude Code、OpenAI Codex 和 Google Antigravity 的工程经验记录。文本、其翻译以及图表是在 AI 协助下准备的,基于我自己的经验、公开源代码和保存的开发记录。
一个新会话不会自动继承刚刚结束的对话。必须有人介入,解释哪个文件仍然重要、我们为什么改变方向、以及结果记录在哪里。一个明显的诱惑是再写一份摘要笔记,但那份笔记也需要被记住:如果不更新,它也会像其他笔记一样过时。
所以本文要回答的问题是:如何跨会话保留操作知识,而不让一份过时的笔记把下一个 agent 引向你早已放弃的路径?我的简短答案是:少存一点,带上版本和生命周期状态,并把三件事分开:现在什么是真的、当时记录了什么、以及一次尝试是如何结束的。本文的其余部分展示每条边界从何而来。
下面的机制固定对应 2026 年 10 月 27 日发布的公开 KYB v0.3.3(commit 06f63b5)。下面的事件保留其日期:新功能不会归因于旧版本,当前 main 分支可能有所不同。我们的内部记录不公开。我没有对使用和不使用 KYB 的 agent 做过对照比较,所以因过时笔记而损失的时间是我的个人回忆,不是采用后测得的节省。
事后看来,问题有三个部分。第一,没有单一的共享入口:笔记存在于不同地方,没有一个跨会话的权威来源。第二,笔记没有明确的生命周期状态:描述已否决方案的文件看起来和描述活跃方案的文件一模一样。第三,单独的文件本身无法确定哪个版本的决策是权威的:即使笔记已经在 Git 中被跟踪,agent 在工作树中读取文件或读取相邻笔记时,若不另行检查,也无法判断那段文本是取代了早先的方案,还是后来被取代了。
我第一个真正的修复很简单:一个共享服务,用于操作事实、事件和任务,每个会话都能访问。它最初的接口是建立在 HTTP API 之上的 CLI;agent 知道如何运行命令,这就足够开始了。后来,服务器获得了 Model Context Protocol(MCP)支持,这样 agent 就可以直接调用它的工具。CLI、HTTP API 和 MCP 都通向同一批记录:一个房间的三扇门,而不是三份独立的记忆。
KYB 没有变成什么同样重要。它不保存隐藏的模型推理,也不归档整个对话。只有当人或 agent 明确保存时,记录才存在:一个稳定键下的知识、一个带有检测和结果的事件、或一个带有负责人和状态的任务。每条记录都是 Git 仓库中的一个 Markdown 文件。搜索索引建立在上面,可以重建;仓库保持为权威来源。我故意选择小型、可验证的记录,而不是自动聊天归档:归档什么都有,但在其中找到活跃的结论和在文件堆里找一样难。还有一个区别:公开仓库包含引擎,而我们的工作记录存放在一个单独的内部存储中。安装 KYB 会给你自己的存储,遵循你自己的访问规则,不含我们的任何笔记。
共享服务器解决了位置问题,而不是内容问题。把同样的旧笔记倒进数据库,搜索只会更快地找到过时文本。所以下一个问题是:什么应该在会话之后存活下来?
最有用的记录通常回答源代码无法回答的问题:为什么这样构建?代码展示的是选定的实现,而不是尝试过哪些选项、它们在哪里不足、或哪个约束决定了结果。没有这些,下一个 agent 可能会小心翼翼地重建一个已被否决的设计,同时真诚地相信这是一种改进——正是我最初的问题。
因此,材料分为三类。知识是值得回顾的状态或规则:服务的角色、接口约定、验证配置的方法。事件是发生过的问题:症状、影响、如何判断它是否仍在持续、以及它如何结束。任务是要做的工作,或它被关闭的原因。这种划分让你不会把意图与事实混淆,或把已完成的尝试与活跃的建议混淆。
以一个关于选择消息队列的示例记录为例。“我们使用选项 B”说得太少。下一个 agent 不需要盲目遵守旧结论;它需要判断背后的条件是否仍然成立。我会大致这样写这样一条记录(一个模板,不是真实基准):
决策:对此工作负载使用选项 B。 原因:选项 A 在条件 Y 下未能满足要求 X。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。