NeoSigma Environments 推出可重放智能体运行环境的测试平台
来源标题:A Playground for Agents to Replay, Explore, and Learn from Experience
NeoSigma 发布 Environments 平台,可在每次运行时重建智能体及其环境的新沙箱,让团队按需重放生产任务。该环境包含文件系统、Docker、数据库和开发服务等,解决多数团队因搭建多服务应用耗时过久、无法在修复后复测失败场景的问题。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
00:00 00:000.5×1×1.5×2×
本文共 6 节↓
00 一个让 agent 回放、探索并从经验中学习的试验场
一条 trace 能还原出 agent 的生命周期——用户提出了什么请求,agent 执行了哪些动作。要在同一个用户请求上再次测试,agent 必须带着它第一次运行时所用的相同代码、数据、工具和服务重新回放一遍。NeoSigma Environments 让这件事成为可能。
如今的 agent 运行在复杂的环境中,这些环境由文件系统、Docker、客户代码仓库、数据库、开发服务、网络和工具组成。借助我们的环境,每次运行都会在一个全新的沙箱中重建 agent 及其环境,因此你可以回放生产任务,并让 agent 用真实工具去探索。
你能按需把同一个 agent 放回同一个环境,针对每一个你关心的故障重新运行吗?
对大多数团队来说,答案是不能。构建一个多服务应用的可运行副本很慢,把 agent 接入其中更慢。于是团队跳过了回放验证,修复在没有针对它本应解决的故障做过测试的情况下就发布了。
NeoSigma 会为每次运行重建 agent 的环境,其代码、数据、工具和服务在几分钟内就绪。我们在一个客户的 agent 上做了测试,对真实生产故障进行了 42 次回放,其中 90% 的评分回放复现了原始故障。
环境是模型之外一切塑造 agent 行为的事物的总和。
对于一个典型的生产 agent,它由五个部分组成:
harness,包括底层模型、prompts、skills、工具、集成和子 agent。
代码仓库以及任何同级仓库,均处于 agent 运行时的确切 commit。
agent 依赖的数据库、队列、工作流引擎、服务器或任何外部提供方。
文件系统、种子数据、迁移和环境变量,使应用不是一个空壳。
对话另一端的用户,其回复会逐轮引导 agent。
只要缺少其中任何一项,你回放的就不再是你当初看到的那个故障。缺少它们时,回放往往沦为重跑单次工具调用,或者重新生成 agent 的最后一条消息。
代码:每个仓库都检出在 agent 运行时的确切 commit。
app @ workers @ DockerDOCKERPOSTGRESWEB APPWORKFLOWSAND MOREMIGRATIONS000 / 042SEED DATAENV VARSAgent harnessLISTENING :8080SIMULATED USERRefund order 4521,please.Done, refunded.JUDGERUBRICFinds the orderRefunds onceFAILsame as productionCodeServicesStateAgentUserJudge
展开
展开
环境的各个组成部分。Agent harness、代码、服务和状态共同置于一个沙箱中,每次回放都会重建。用户和 judge 位于其外,因此 agent 在内部所做的任何事都无法改变它被驱动或被评分的方式。
每次回放包含五个步骤。回放之间不共享任何东西。
任务包含原始请求、agent 运行时的 commit、模拟用户的目标,以及 agent 未通过的检查项。
一个新沙箱在该 commit 上检出所有仓库,加载工作区的环境变量,并启动整套服务。
NeoSigma 检查 agent 是否已准备好响应,然后发送第一条消息。
沙箱之外的模拟用户根据原始用户的目标逐条写出下一条消息,直到结束对话或达到轮次上限。
沙箱之外的 judge 读取每一轮、每次工具调用和每个工具结果,对照 rubric 进行检查,并返回通过或失败。
我们回放了一个多服务 agent 的真实生产故障,其技术栈结合了 Postgres 数据库、工作流引擎、Web 应用和后台 worker。在生产中运行了三个实验:两个各含 16 个故障的数据集,以及一个含 10 个故障的数据集,共 42 次回放,每次并行 8 个。这些数据集有重叠,因此 42 计的是回放次数,而非不同的故障数。在每次回放中,agent 与模拟用户最多对话三轮,由 Claude Sonnet 5.5 judge 对轨迹进行评分。
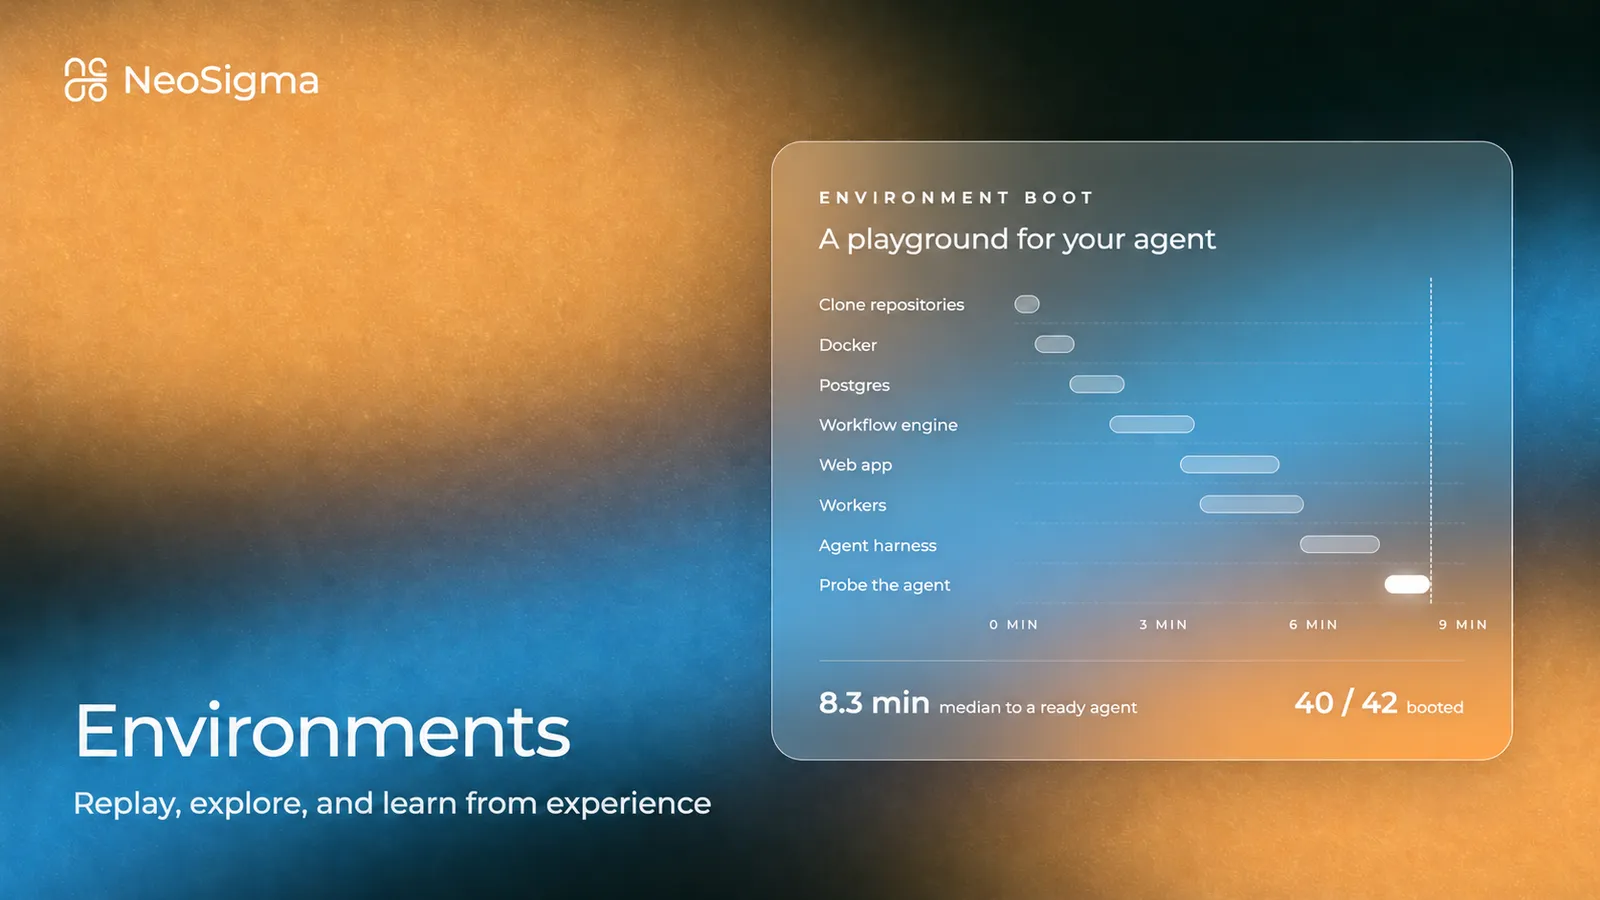
42 个环境中有 40 个(95%)成功得到一个可应答的 agent。从空沙箱到 agent 就绪的中位时间为 8.3 分钟,p95 为 10.5 分钟。一次启动失败是 Docker daemon 始终没有启动。另一次是 agent 始终没有就绪。
在成功启动的 40 个环境中,有 30 个运行到了结束并得到了可用的评分。另外 10 个中有 4 个在回放过程中 agent 停止响应。其余 6 个中,judge 没有返回可用的评分。在 30 次有评分的回放中,有 27 次(90%)再次未通过任务或其检查项,复现了原始的生产故障。每一次都从空沙箱一直运行到得出评分结果,全程无人介入。
这些结果来自一个生产应用、42 次回放和单一 judge 模型。一次失败评分能在多大程度上复现故障,取决于每个任务所依据的 rubric 的质量。
要自主工作,agent 需要一种验证自身工作的方式。丰富的工具集和清晰的奖励信号,只有在 agent 拥有一个真实环境可以行动、观察结果并再次尝试时才有用。
NeoEval 把失败的生产会话转化为可回放的任务,并扎根于你用户的真实工作流。每个 eval 都在类似上述的环境中运行你的 agent,并使用你自己的 verifier 来衡量成功。这些任务、环境和奖励信号共同构成了一个测试与训练平台,用于评估和优化你的 agent。
环境成为你 agent 的试验场:一个回放真实工作、探索变更并从经验中学习的地方。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。