谷歌工程师用Gemini与Z3约束求解器查找Go代码崩溃缺陷
来源标题:Catch Go Bugs That Fuzzing Misses with Gemini and a Constraint Solver
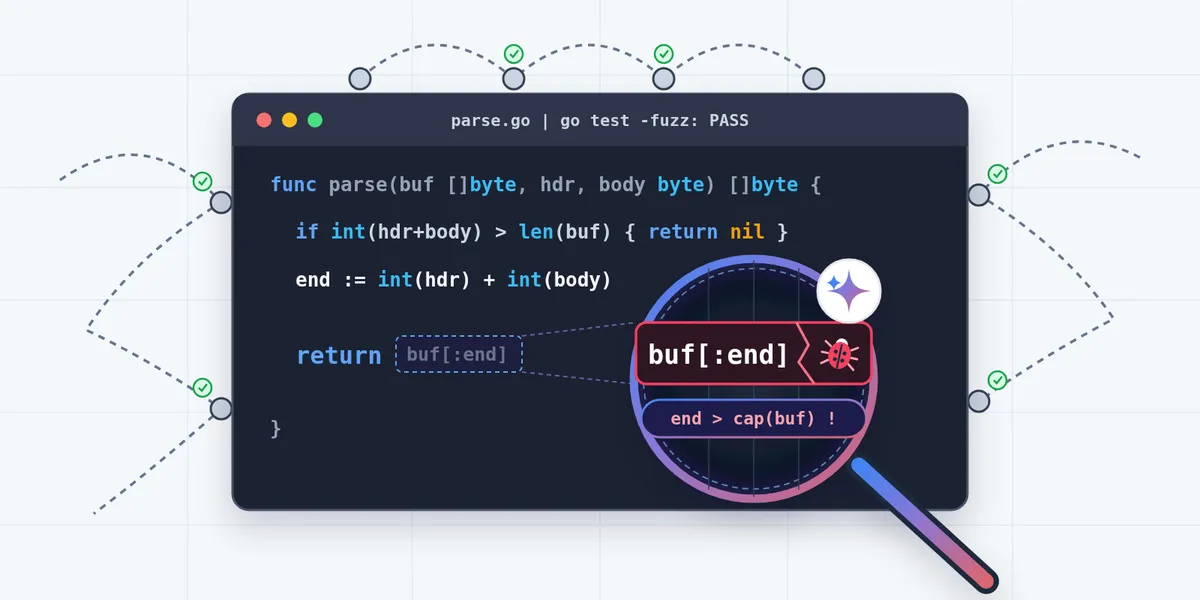
谷歌工程师结合Gemini和Z3约束求解器,在Go CLI工具skill-lint中定位到模糊测试未覆盖的切片越界崩溃。方法是将编译器保留的边界检查陷阱路径交由Gemini翻译为Z3规则,再由求解器生成可复现的Go测试输入;所有发现的崩溃均经go test实际运行验证。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
我参与领导 Google 的 agent skills 项目,目前已有 175 个 agent skill,作为 go-skills 等社区集合的补充。为了让这么多 skill 文件保持一致,我写了 skill-lint——一个独立的 Go CLI,用来检查 SKILL.md 文件,并在发布前应用 LLM 生成的按行编辑。即便 skill-lint 自身有单元测试和模糊测试套件,它的 Markdown 解析器或编辑应用器中一个小的切片或行号错误仍可能潜伏下来,直到某个不寻常的文件或编辑范围在 linter 中触发运行时 panic。
在 Go 中,每一个可能在运行时 panic 的切片或索引操作,在编译器优化器剔除掉它能排除的检查之后,都会在机器码中编译成一个显式的边界检查陷阱。为了追查崩溃,我把代码中的关键函数编译出来,看看哪些 panic 陷阱在优化后依然存在,然后由 Gemini 4 Argon 把通往每个陷阱的路径翻译成 Z3 约束求解器的规则。LLM 编写的求解器模型并不是可靠的证明系统,但它给 agent 提供了一种独立的方式来推理控制流并合成具体的 Go 复现程序,而且它发现的每一个崩溃都是真实的,因为 go test 会直接运行那些有问题的字节。这套流程抓到了我在测试解析器中植入的全部三个 bug,还发现了 skill-lint 中的三个潜在 bug。
在这篇文章中,我将介绍 Gemini 和 Z3 流水线是如何工作的,为什么 go test -fuzz 漏掉了其中两个崩溃(以及修复它的一行改动),以及这种方法在日常 Go 工作流中的定位。
Anthropic 最近的一篇文章展示了形式化验证如何通过让前沿 AI 模型为 OSS-Fuzz 库编写经过机器校验的 Rocq 证明,来捕捉 C 和 C++ 中的潜在 bug。与模糊测试器随机采样输入不同,形式化工具从每个失败条件反向推导,求解出触发它的确切输入。完整的定理证明对大多数日常 Go 项目来说仍然过于沉重,所以我想看看 agent 能在每个函数大约一分钟内,从 LLM 和约束求解器那里获得多少这种 bug 追查能力。
在 C 和 C++ 中,读写缓冲区末尾之外会破坏内存。Go 则在运行时捕获越界访问,把每一个它无法证明安全的切片或索引操作编译成一个显式分支,跳转到 runtime.panicBounds,从而触发 panic,除非被 recover,否则进程崩溃。
在生成机器码之前,Go 的 SSA prove pass 已经通过跟踪切片长度和循环变量消除了大部分这类检查。这个优化 pass 只留下编译器自己无法排除的 runtime.panicBounds 陷阱,从而给求解器一份简短的候选崩溃点清单。
我用 GOOS=linux GOARCH=riscv64 go build -gcflags="-S -d=ssa/check_bce/debug=1" 编译每个目标(-S 打印汇编清单,ssa/check_bce/debug=1 记录每一个存活的边界检查),并把 Go 源码和反汇编都传给模型。只看 Go 源码,你无法看出编译器已经移除了哪些边界检查,或者寄存器在哪里被截断为 8 位;而在反汇编中,两者都会显现。我选择 RISC-V,因为它是 Anthropic 那篇文章为其 Rocq 证明所针对的指令集,而且 Go 开箱即用地支持交叉编译到它。
接下来,Argon 读取 Go 源码和反汇编,返回一个 Z3 脚本,建模通往每个存活陷阱的路径,并在它标记出 bug 时附带一个修补后的函数。然后 Z3 检查这些约束是否可满足,每当它找到崩溃输入时,go test 就会用这些字节对真实函数进行重放。使用 LLM 让我免于手工把汇编翻译成求解器约束。Argon 的翻译占据了主要运行时间,每个函数大约一分钟,而 Z3 本身在毫秒内完成。
Anthropic 的方法依赖交互式定理证明,由专家建模机器语义,Rocq 根据这些规则检查 LLM 生成的证明。相比之下,我的工作流使用基于可满足性模理论(SMT)的约束求解器,依靠 Argon 直接把汇编翻译成 Z3 约束。虽然约束求解器在没有语义模型的情况下无法提供完整的正确性证明,但它在发现 bug 方面非常有效。当输入约束可满足时,Z3 的 check-sat 命令返回 sat,不可满足时返回 unsat。
sat 答案(“肯定有 bug”)会附带针对陷阱的具体字节,go test 会用它们对真实函数运行。一旦 go test 发生 panic,无论 Argon 的模型是否可靠,你都得到了一个具体的 bug 复现程序。就像用于 bug 的布隆过滤器,unsat 答案只意味着“可能正确”。放弃正确性证明正是这种方法如此实用的原因:你以极小的代价获得了形式化方法的大部分 bug 发现价值。
Anthropic 的设置在 64 MB 预算下证明了整个二进制文件的无崩溃属性;我则在全新的 64 字节切片上检查单个函数,其中 cap(buf) == len(buf),因此任何超过 len(buf) 的切片都会 panic。(如果你想要针对 Go 的完整二进制 Rocq 设置,theorem-labs/oss-verify 包含一个 Go 1.27 运行时覆盖层,使运行时单线程且确定性。)
对于模糊测试基线,我在 Go 1.27.3 上对每个植入的 bug 运行了未设种子的 go test -fuzz:一次 3 秒运行和三次 60 秒运行,每次都使用全新的 fuzz 缓存,这样短时间预算就不会成为漏掉的解释。
我从三个安全的解析器开始,以确保流水线不会标记干净的代码。编译器的 prove pass 自行移除了 TOML 键解析器中的所有边界检查,Z3 对 HTTP 头扫描器和 varint 解码器中剩余的陷阱返回了 unsat。
然后我写了三个带有微妙 panic 的解析器。这是第一个,ParseTwoChunkFrame: func ParseTwoChunkFrame(buf []byte) ([]byte, []byte) { if len(buf) < 4 || buf[0] != 0xA5 || buf[1] != 0x5A { return nil, nil } hdrLen, bodyLen := buf[2], buf[3]
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。