YOLOX推理测试:DirectML在GTX 1650 Ti上达106-111 FPS,OpenVINO CPU方案表现不及
来源标题:Yolox Inference:OpenVINO,CPU EP on Intel I5,but DirectML Delivers on GTX 1650 Ti
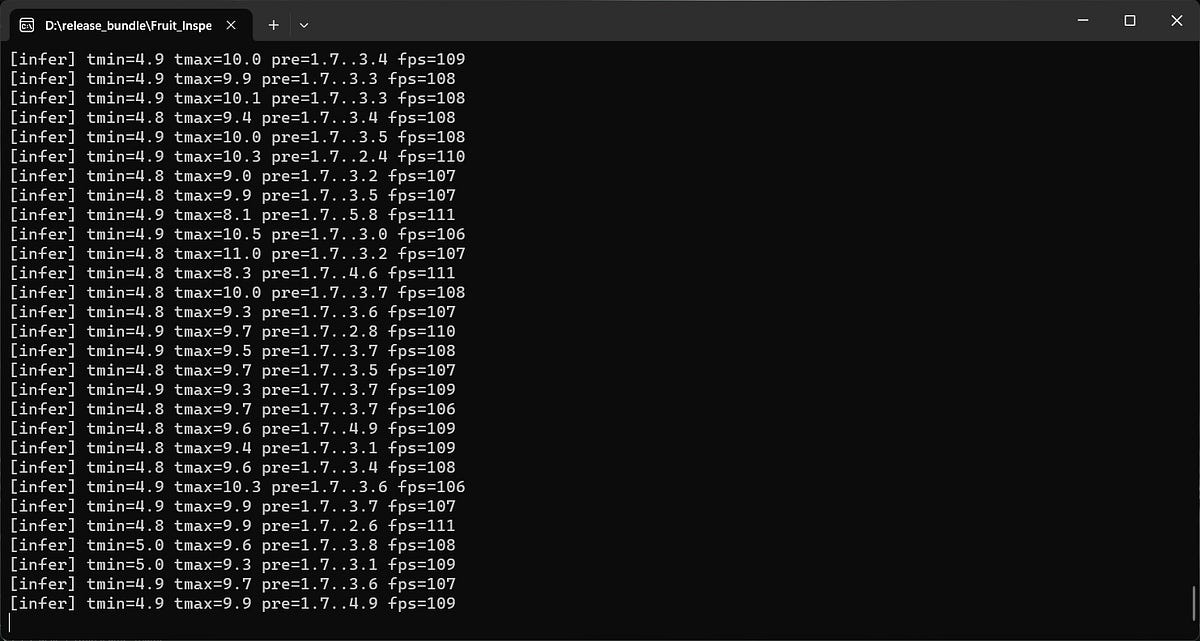
在惠普Pavilion Gaming(Intel i5-10300H + GTX 1650 Ti)上,DirectML执行YOLOX推理稳定达到106-111 FPS,单帧纯推理耗时4.8-5.0毫秒,最大延迟不超过11.0毫秒。测试表明,这款Turing架构的入门级移动显卡原始算力足以抵消张量在PCIe总线上的传输开销,而OpenVINO CPU方案未达同等表现。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
软件工程 性能优化 计算机视觉 深度学习 绕过 AVX2 税:第 5 部分 —— Intel 的现实检验:DirectML 的救赎与 OpenVINO 的幻象 olesha-ai 阅读时长 3 分钟· 刚刚
在第 4 部分中,我们看到上下文切换开销和数据拷贝如何抵消了第三方执行提供程序在 AMD 上的优势,使纯 CPU 成为唯一可行的选择。而在 HP Pavilion Gaming(Intel i5–10300H + GTX 1650 Ti)上的测试则呈现出完全不同的景象。希望复现测试的读者,可以在 GitHub 上的 fruit-inspector-demo 仓库中获取演示版本(应用程序的评估版以及三个推理库)。
DirectML 的指标显示稳定的 106–111 FPS。纯推理每帧耗时 4.8–5.0 ms,最大延迟(tmax)不超过 11.0 ms。
在实践中,移动版 GTX 1650 Ti(Turing 架构)尽管年代久远且定位入门,仍具备足够的原始算力。它足以完全抵消张量在系统内存与显存之间通过 PCIe 总线传输的开销。此前在轻量级 YOLOX-nano 模型上拖累 AMD 集成显卡的 Windows DirectML API 开销,在这款芯片的实际性能面前根本不值一提。
这一部分的结果在意料之中。专为 Intel 架构优化的 OpenVINO 专用引擎,相比标准 CPU Execution Provider(EP)并没有带来速度优势:
OpenVINO:67–73 FPS,tmin 为 8.5–9.3 ms。 CPU EP:紧随其后 —— 66–71 FPS,tmin 为 8.8–9.3 ms。
帧时间图表几乎完全一致。差异只体现在峰值延迟(tmax)上:负载下的纯 CPU 偶尔会飙升至 20.1 ms,而 OpenVINO 将这些峰值控制在略低的水平,不超过 17.0 ms。
结论很简单:在 Comet Lake 架构上,使用 OpenMP(OMP_NUM_THREADS=8)的标准 ONNX Runtime 后端已经以最高效率利用了处理器的向量单元。通过 OpenVINO 优化计算图并不能提升我们流水线的速度,只是略微平滑了偶发的系统抖动。
数据准备日志(pre)印证了 Fruit Inspector 内置的架构原则:这一阶段完全独立于所选的执行后端。三个提供程序在帧缩放和归一化上的最小耗时完全一致,均在 1.5–2.2 ms 区间。高达 5.8–6.3 ms 的峰值也完全同步。图像准备操作在标准 OS 线程上于 CPU 运行,无论选择哪种推理运行时,都会经历相同的 Windows 调度器延迟。
对本文提到的完整流水线、源代码和评估版本感兴趣的读者,可在此获取完整项目: https://github.com/olesha-ai/fruit-inspector-demo/releases/download/0.10.0/Fruit_Inspector_win64_prov.7z
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。