Netflix 开源新一代视频质量评估工具 VMAF v1
来源标题:VMAF v1: Good Is Not Good Enough
Netflix 开源了 VMAF v1,用于更准确地评估视频编码的视觉质量。相比此前的 VMAF v0,新版本针对已知局限做了改进,能更精准地判断质量,从而更高效地为全球会员提供更高画质。VMAF 长期用于回答编码质量与码率权衡等问题。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
作者:Christos G. Bampis、Zhi Li、Kyle Swanson、Nil Fons Miret 和 Pavan Madhusudanarao
这个编码在 Netflix 会员看来画质够好吗?切换到新 codec 能否在相同码率下提升画质,提升幅度有多大?在给定目标码率预算的情况下,一部电影的最佳编码方式是什么?多年来,VMAF 一直可靠地帮助我们回答这些问题,并为会员提供优化的体验质量。
但“好”还不够。如果 VMAF 误判了画质,就可能导致紧张的近景镜头丢失细节,或让惊艳的广角天空镜头出现色带。把这么大的信任寄托在一个数字上,我们必须确保它配得上这份信任。长期以来,我们收集了来自内部和外部 VMAF 用户的反馈。几年前,我们踏上了开发新版 VMAF 的旅程,以解决一些已知局限。今天,我们很高兴地宣布,我们正在开源新版 VMAF,版本号为 v1。通过使用 VMAF v1,我们可以更准确地评估视觉质量,从而高效地为全球 Netflix 会员提供更高画质。在这篇文章中,我们将分享 v1 如何解决上一版本(称为 VMAF v0)的局限,以及我们在此过程中遇到的一些挑战。
VMAF(Video Multimethod Assessment Fusion)是 Netflix 与高校合作伙伴共同开发、并在 GitHub 上开源的视频质量指标。它已成为视频行业编码评估和优化的事实标准。VMAF 将基础的质量感知特征结合起来,并通过在主观数据上训练的支持向量回归器(SVR)进行融合。背景信息请参阅我们的第一、第二和第三篇 VMAF 技术博客。
尽管 VMAF 准确且被广泛采用,我们发现其算法核心仍有改进空间。这对于我们无论会员在何处、以何种方式观看 Netflix,都为其提供尽可能最佳视觉质量的使命至关重要。随着 AV2 等新 codec 的开发,以及直播和云游戏等用例的出现,我们努力持续改进 VMAF 以满足这些业务需求。下面我们逐一介绍各项关键改进。
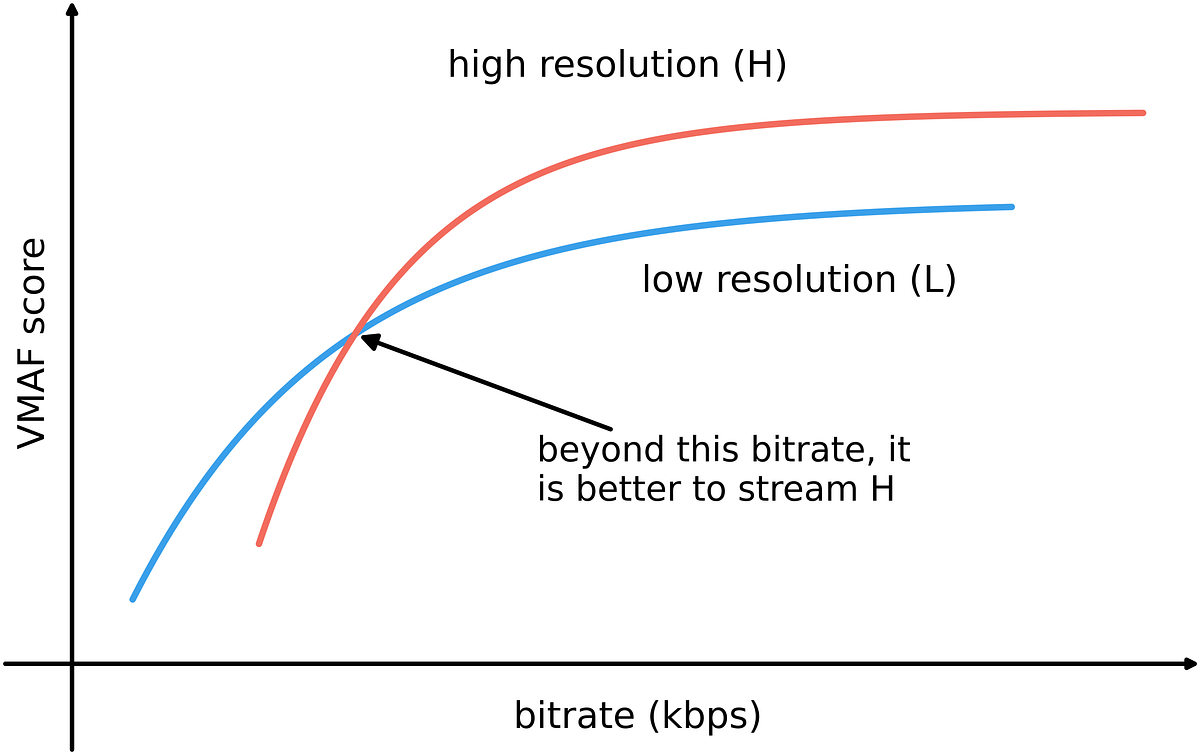
正如我们在第一篇 VMAF 技术博客 [1] 中所讨论的,典型的编码流程会同时引入压缩伪影和缩放伪影。直观地说,当可用比特更多时,更高分辨率更可取。VMAF 量化了压缩与缩放之间的权衡,并在给定码率预算下确定应使用的最佳分辨率。这可以通过 VMAF 对码率的曲线来展示。
在实践中,我们观察到 VMAF v0 倾向于在较低码率下切换到更高分辨率,偏好压缩伪影而非缩放伪影,而后者在视觉上可能令人不适。这可以部分归因于 DLM(Detail Loss Metric)特征,它惩罚对比度/细节损失,但对块效应 [3] 等干扰性伪影可能不够敏感。在 VMAF v1 中,为了补充 DLM,我们加入了原始 ADM 公式中的 AIM(additive impairments)分量 [3],并做了小幅修改以提高准确性。这两个基础指标线性组合,类似于 [3] 中的原始实现。
影响质量感知的一个一阶效应是伪影的可见性及其与观看距离和画布尺寸的关系。简而言之,同一段编码视频在更小的画布上显示或从更远处观看时,看起来会更好。
标准 VMAF 模型假设观众坐在 1920×1080 显示器前,处于类似客厅的环境中,归一化观看距离约为屏幕高度的 3 倍(3H)。这意味着标准的 1080p@3H VMAF 模型对应约每度 60 像素的视角。
对于手机观看,考虑到屏幕尺寸更小、相对于屏幕高度的自然观看距离更长(典型手机观看可近似为 4 到 5H),我们预计伪影会变得不那么明显。VMAF v0 的手机模型通过二阶多项式映射对标准(电视/笔记本电脑)VMAF 分数进行后处理来捕捉这一点。该映射是使用主观数据估计的。
上述映射的一个缺点是,对于与原始主观实验存在实质性差异的大量观看条件,预测难以泛化。此外,在实践中,我们观察到手机模型可能高估画质。在 v1 中,我们不再使用映射函数,而是根据归一化观看距离调整基础特征值。然后,同一模型可以针对不同用例进行训练和重新应用,例如手机观看、4K@3H,或更严苛的 4K@1.5H。我们发现这种方法提高了准确性,并有助于更好地泛化 VMAF。
为实现这一点,我们根据归一化观看距离调制 DLM 中使用的空间对比敏感度函数(CSF)。CSF 定义了人类在不同空间频率下对对比度的敏感度,并与失真可感知性相关。因此,CSF 可用于估计不同观看距离、显示尺寸和分辨率下的感知失真。下方展示了一个 CSF 曲线示例。
随着观看距离增加,更多像素落入一个视角度数内,从而降低了失真可见性。在 VMAF v1 中,我们使用了 [4] 中 Barten CSF 模型的改编版本。
VMAF v0 仅提取基于亮度的特征,因此无法感知色度伪影。在实践中,编码和缩放会通过量化和子采样引入色度伪影。为了捕捉此类伪影,我们修改了 SpEED-QA 并将其应用于色度通道。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。