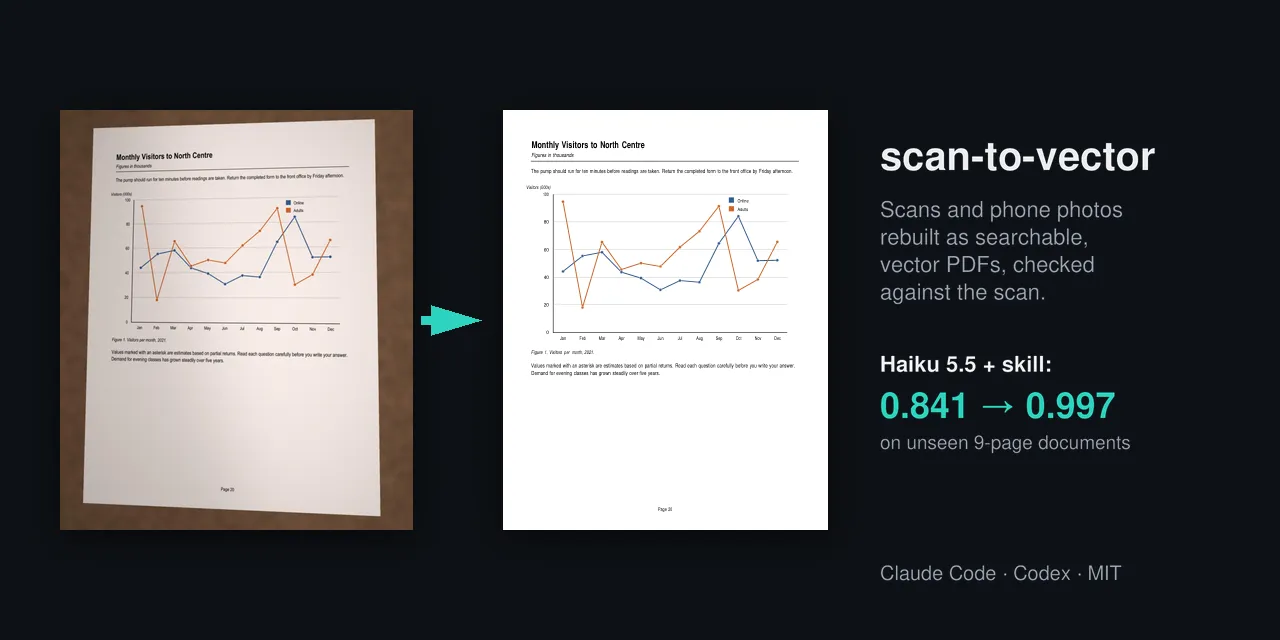
Scan-to-vector:用 AI 代理将扫描页面重建为矢量 PDF
来源标题:Show HN: Scan-to-vector – rebuild scanned pages as vector PDFs with an AI agent
Scan-to-vector 能把扫描的书本、手册和图表重建为可搜索的矢量 PDF,文字可复制、图表以矢量路径重绘,并逐页与扫描件比对校验。它作为 Claude Code、Codex 等客户端的技能使用,在两份未见过的 9 页扫描文档测试中,Haiku 5.5 得分从 0.841 升至 0.997,Sonnet 5.5 完成速度快了 37%。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
把扫描的书、手册、工作表和图册重建为可搜索的 PDF,其中的图表以矢量形式重绘,并逐页与扫描件核对。这是一个 agent skill,适用于 Claude Code、Codex 以及任何能读取 SKILL.md 的客户端。OCR 只是在扫描件上叠一层不可见的文字,而 scan-to-vector 是把整页重建出来:真正的文字可以搜索、可以复制;图形和图表重绘为矢量路径,无论放大多少倍都保持清晰;照片和版画则保留为干净的、带标注的裁切图。每一页源文件都记录在账本中,成品交付前还会把重建结果叠加到扫描件上进行比对。实测而非自说自话:在两份从未见过的 9 页扫描文档上,我们测试的全部四个模型使用该 skill 后得分都有提升。Haiku 5.5 从 0.841 升到 0.997,Sonnet 5.5 的完成速度快了 37%。详见基准测试。两个演示都是真实的公共领域扫描件。本仓库中的重建 PDF 由 agent 按照 SKILL.md 生成。每一个测量出的坐标都记录在构建脚本里,你可以自行重新生成。
扫描件(输入) 重建结果(输出) 文件 scan.jpg,1920×2519 JPEG,300 KB byrne-euclid-I-11.pdf,80 KB 文字 像素 可搜索文字,使用开放的 Caslon 字体(Libre Caslon Text) 图形与行内符号 像素 82 条矢量路径,位置均在扫描件上测量 版画首字母「F」 像素 保留为清理过的位图裁切,并在账本中注明 检查 与扫描件叠加比对、页面账本、结构审计:0 个问题
有两项编辑取舍记录在账本中,而不是悄悄做出:长 s(ſ)被现代化,以便 straight 和 shall 仍可搜索;∴ 和 ⊥ 是绘制出来的,因为正文所用字体没有这两个字形。
agent 校准了版画网格,描摹了两条曲线,并从每条序列中恢复出 81 个年度数值写入 data.csv。重建的图表只根据该文件绘制,其曲线落回原版画的位置,并在 1754 年如原图一样相交。该 PDF 中不包含任何位图图像。
可以,而且我们用四个模型做了测量。每个模型都拿到同样的简短请求(“把这些扫描页重建成一个干净的 PDF……”),各做两次:一次独立完成,一次配合本 skill。所用的文档都是该 skill 从未针对其调优过的:困难模式下包括工作表、表格、图表、流程图、表单和双栏文章,字体陌生、页面密集,其中一半是用手机斜着拍摄的照片,带有阴影,画面里还有桌子。每一页都对照其真值在文字、版式、图形和矢量占比上打分(1.0 为满分)。
长文档(skill v6):两份 9 页文档,共 18 页,16 次运行 短文档包(skill v5):六个 3 页文档包,共 18 页,48 次运行 长文档的耗时来自每个模型两份文档,因此仅供参考。
agent 在这项任务上的失败方式是可以预见的,而 skill 的每一部分都针对其中一种。
每个版本都在未曾调优过的页面上测量,其失败之处塑造了下一个版本。
原始数据在 bench/results/,基准测试代码在 bench/。
OCR 层(如 OCRmyPDF) PDF → Markdown(如 Marker、MinerU) scan-to-vector 输出 原始扫描件 + 隐藏文字 Markdown / JSON 重新排版的 PDF 页面外观 与扫描件完全一致 版式丢失 干净,接近原稿 图形与图表 仍为位图 提取为图像 重绘为矢量;图表数据被还原 来源与检查 无 无 页面账本、叠加审查、PDF 审计 速度 数秒 数秒到数分钟 agent 逐页处理
如果你只需要在扫描件上叠加可搜索文字,请使用 OCR 层:它更快也更便宜。当页面本身需要被重建时——要重新打印的工作表、带图表的手册、旧书、想找回其中数字的图表——请使用 scan-to-vector。
Claude Code 插件(推荐) 在 Claude Code 会话中: /plugin marketplace add 3351666087/scan-to-vector-skill /plugin install scan-to-vector@scan-to-vector-skill 在 shell 中,同样的两步是 claude plugin marketplace add 3351666087/scan-to-vector-skill 和 claude plugin install scan-to-vector@scan-to-vector-skill。之后用 claude plugin update scan-to-vector@scan-to-vector-skill 更新。插件 skill 会带有插件名前缀,因此该 skill 显示为 scan-to-vector:scan-to-vector;用自然语言请求它的效果是一样的。 curl -fsSL https://raw.githubusercontent.com/3351666087/scan-to-vector-skill/main/install.sh | bash install.sh 会把 skill 复制到 ~/.claude/skills 和/或 ~/.codex/skills,具体取决于机器上找到的 agent。要自行指定目标,可在命令末尾加上 | bash -s -- --claude、--codex 或 --dir DIR(任何其他客户端的 skills 文件夹)。再次运行会更新它安装过的副本。你编辑过的副本不会被改动,除非加上 --force,此时会先把它移到 skills 文件夹旁的 skill-backups/ 中。想在运行前阅读脚本,请克隆仓库并运行 ./install.sh。 插件和 ~/.claude/skills 中的副本只用其一,否则 Claude Code 会把该 skill 列两次。 git clone https://github.com/3351666087/scan-to-vector-skill.git Agent 命令 Claude Code mkdir -p ~/.claude/skills && cp -R scan-to-vector-skill/skills/scan-to-vector ~/.claude/skills/ Codex mkdir -p ~/.codex/skills && cp -R scan-to-vector-skill/skills/scan-to-vector ~/.codex/skills/ 其他 把 skills/scan-to-vector/ 复制到你的客户端加载 Agent Skills 的任意目录 Python 依赖 无论用哪种方式安装 skill,其脚本都需要 Python 3.10+ 以及 PyMuPDF、Pillow、numpy 和 scipy,另外还需要 tesseract 命令用于 OCR(缺失时 install.sh 会打印此提醒): python3 -m pip install "PyMuPDF>=1.28.2,<2" "Pillow>=12.3.0" "numpy>=1.26" "scipy>=1.11" brew install tesseract # 或:sudo apt install tesseract-ocr 使用 用自然语言对你的 agent 说: 用 scan-to-vector 把 worksheet.pdf 重建为干净、可搜索的 PDF。 保留每道题目和答案的空白;把图形重绘为矢量,照片可以保留。 逐页对照扫描件检查,并告诉我缺失的页面或无法辨认的地方。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。