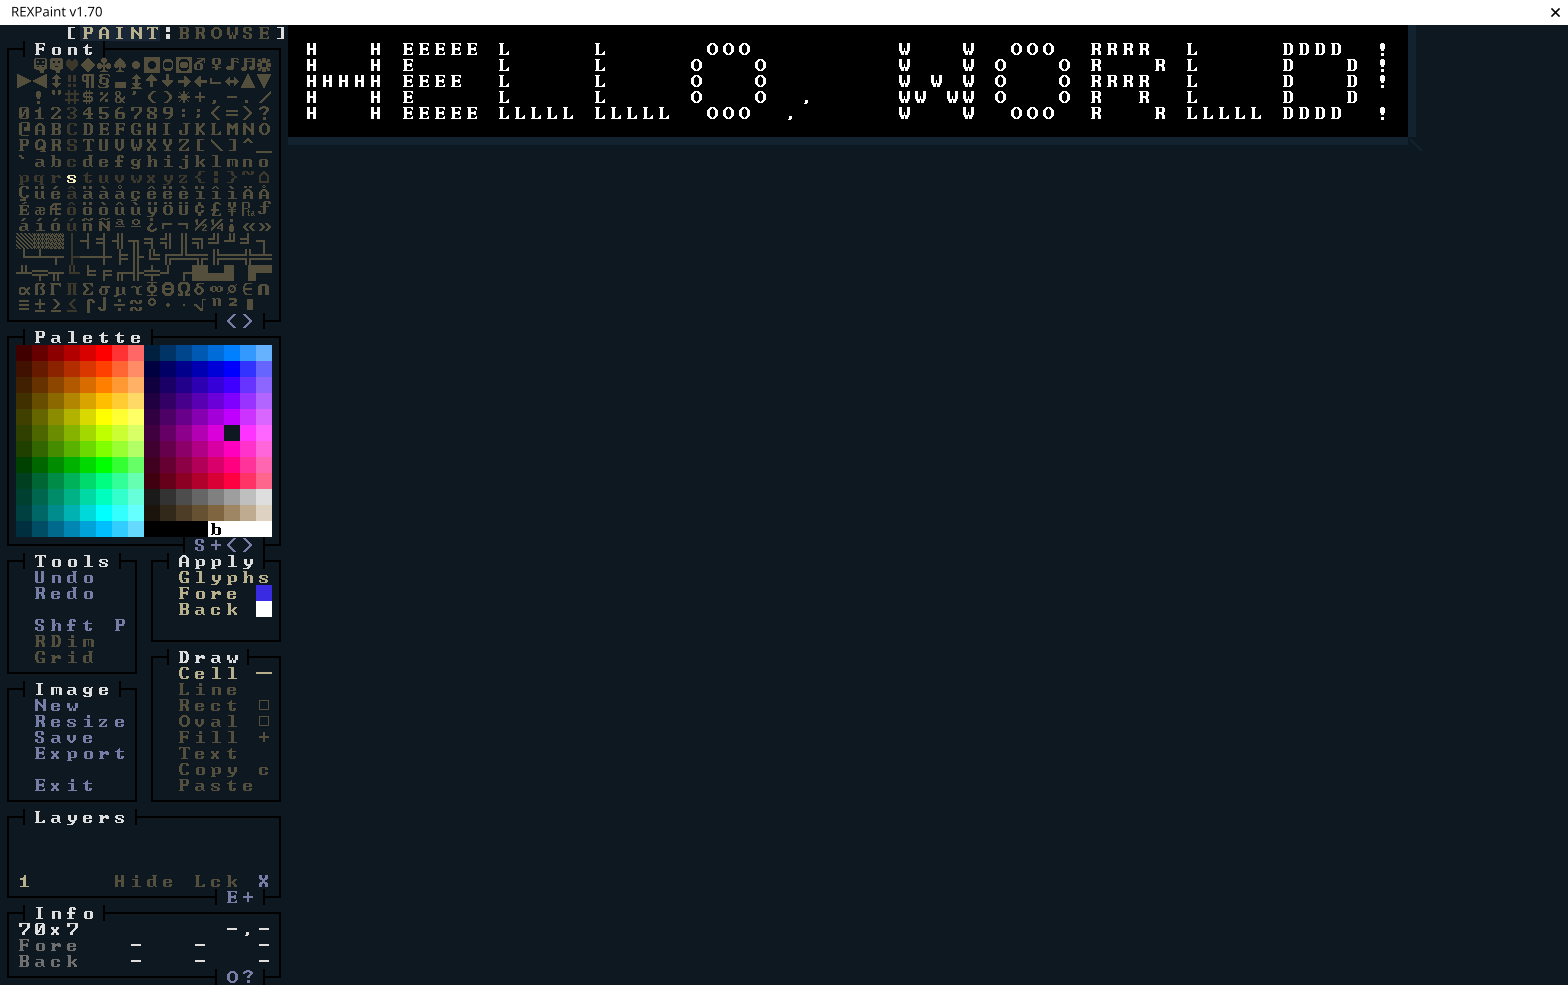
开发者用 Odin 语言解析 REXPaint 的 .xp 文件格式
来源标题:Decoding REXPaint Files in Odin
一篇技术文章介绍了如何用 Odin 语言解码 REXPaint 的 .xp 二进制文件格式。REXPaint 是 Cogmind 开发者 Kyzrati 制作的 ASCII 美术工具,文中以 REXPaint v1.70 为准,并提供了完整的 xp 包代码结构。作者认为该格式适合作为学习二进制文件解析的入门案例。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
REXPaint 是 Kyzrati 开发的一款 ASCII 艺术工具,他同时也是优秀 roguelike 游戏 Cogmind 的作者。你可以用它来设计 UI、全屏美术和关卡预制件,这使它非常适合我的游戏 Fimbul。本文将带你一步步解析 REXPaint 的 .xp 文件。如果你之前没有接触过二进制文件格式,这是一个很好的入门选择!
Grid Sage Games 以纯文本形式发布了官方的 REXPaint 手册¹,Steve Landey 则托管了一个更易读的 HTML 版本²。本文中我会引用 HTML 版本,因为它的章节有直接链接。本文所有内容基于 REXPaint v1.70。
本文全程使用 Odin 编程语言。我们不会逐一讲解每一处语法,但我会尽量解释代码中较高级的部分。如果想更全面地了解这门语言,可以看看 demo.odin。
要跟着本文操作,你需要 Odin 编译器。我用的是 dev-2026-10 版本。下面的代码片段会在一个独立目录中逐步构建出一个 xp 包,旁边是一个使用它的 main.odin:
.
├── main.odin
├── test.xp
└── xp
    ├── decode.odin
    └── xp.odin
每个片段都会展示它新增的 import,但这些 import 应放在文件顶部。
最新版本 dev-2026-11 对 core:compress 包进行了重构,并废弃了一些东西,包括本文用到的 core:compress/gzip。该版本目前还没进入 nixpkgs-unstable(顺便说一下,我用的是 NixOS)。等它进入后,我会用新代码更新本文。
如果用 xxd 查看一个 REXPaint 文件,可以看到它是 gzip 压缩的:
$ xxd ./assets/screens/title.xp | head -1
00000000: 1f8b 0800 0000 0000 000b ed9c db6d c330  .............m.0
前两个字节 1f8b 是魔数,即用于标识文件格式的固定字节序列。每个 gzip 文件都以它开头。接下来是 08,即压缩方法。RFC 1952 只定义了一种方法 8,也就是 DEFLATE,并保留了 0 到 7³。DEFLATE 本身结合了 LZ77 和 Huffman 编码。
解压之后,布局很简单。所有值都是小端序,整个文件就是几个整数,后面跟着一长串单元格⁴。
要在真实文件中看到这些字段,我们得先解压它。把本文后面会用到的测试文件通过 zcat 管道输出,得到:
$ zcat ./test.xp | xxd | head -1
00000000: ffff ffff 0100 0000 4600 0000 0700 0000  ........F.......
每次读四个字节,依次是版本号 -1、一个图层、宽度 70(0x46)、高度 7。
每个图层存储自己的宽度和高度,后面跟着 width * height 个单元格,每个单元格恰好 10 字节。单元格按列优先顺序排列,也就是说 REXPaint 先从上到下写完整个第一列,再写第二列,依此类推。每个单元格的字符字段是 REXPaint 字体的索引,默认使用 CP437 代码页⁵。这意味着 1 是一个笑脸(☺),而不是控制字符。
空单元格还遵循另一条规则。REXPaint 将背景色 255, 0, 255(亮粉色)视为透明,每个空单元格都使用它,即使在基础图层上也是如此⁶。当图层相互叠加绘制时,最底层上仍然可见的透明单元格应绘制为黑色。
在 Odin 中,上述每一部分都变成一个 struct:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
Color :: struct {
    r: u8,
    g: u8,
    b: u8,
}

Cell :: struct {
    character:  i32,
    foreground: Color,
    background: Color,
}

Layer :: struct {
    width:  i32,
    height: i32,
    cells:  []Cell,
}

File :: struct {
    version: i32,
    layers:  []Layer,
}
解码可能以几种不同的方式失败,我们想知道具体是哪一种。单纯的 bool 只能告诉我们出了错,不能说明原因,所以我们要预先定义自己的错误类型:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
import "core:compress/gzip"

Read_Error :: enum {
    None = 0,
    Offset_Goes_Past_Data, // 数据在读取完成前就结束了
    Unable_To_Read_Value,  // 某个值无法解码
    Bad_Dimensions,        // 图层数量、宽度或高度为负
    Size_Overflow,         // 某图层的单元格数超过 MAX_CELLS_PER_LAYER
}

Decode_Error :: union #shared_nil {
    gzip.Error,
    Read_Error,
}
Read_Error 涵盖了我们自己解析过程中可能出错的所有情况。Decode_Error 把它和 gzip 的错误类型包在一起,让单个返回值就能描述这两种失败。#shared_nil 指令意味着任一变体的 nil(包括 Read_Error.None)都会让整个 union 变为 nil,于是 err == nil 就表示“一切正常”。解析字节的 proc 将返回 Read_Error,只有顶层 proc 返回完整的 Decode_Error。
Odin 的 core:compress/gzip⁷ 包可以帮我们把文件解压到字节缓冲区。我们创建一个名为 decode_from_file 的过程(Odin 对函数的叫法,简称“proc”),并为稍后的 decode_from_bytes 先搭个桩:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
package xp

import "core:bytes"
import "core:compress/gzip"

decode_from_file :: proc(
    path: string,
    allocator := context.allocator,
) -> (
    f: File,
    err: Decode_Error,
) {
    buf: bytes.Buffer
    defer bytes.buffer_destroy(&buf)

    gzip.load_from_file(path, &buf, allocator = allocator) or_return
    raw := bytes.buffer_to_bytes(&buf)
    return decode_from_bytes(raw, allocator)
}

decode_from_bytes :: proc(
    b: []u8,
    allocator := context.allocator,
) -> (
    f: File,
    err: Decode_Error,
) {
    // TODO: 读取版本号和图层...
    return {}, nil
}
decode_from_file 做了以下几件事:
gzip 那一行使用了 or_return,这是 Odin 对最常见错误处理模式的简写。如果调用的最后一个返回值是非 nil 错误,or_return 会立即从当前 proc 返回该错误。由于 gzip.Error 是 Decode_Error 的变体之一,gzip 的错误会直接传递给我们调用者。不用 or_return 的话,那一行会写成这样:
1
2
3
4

(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。