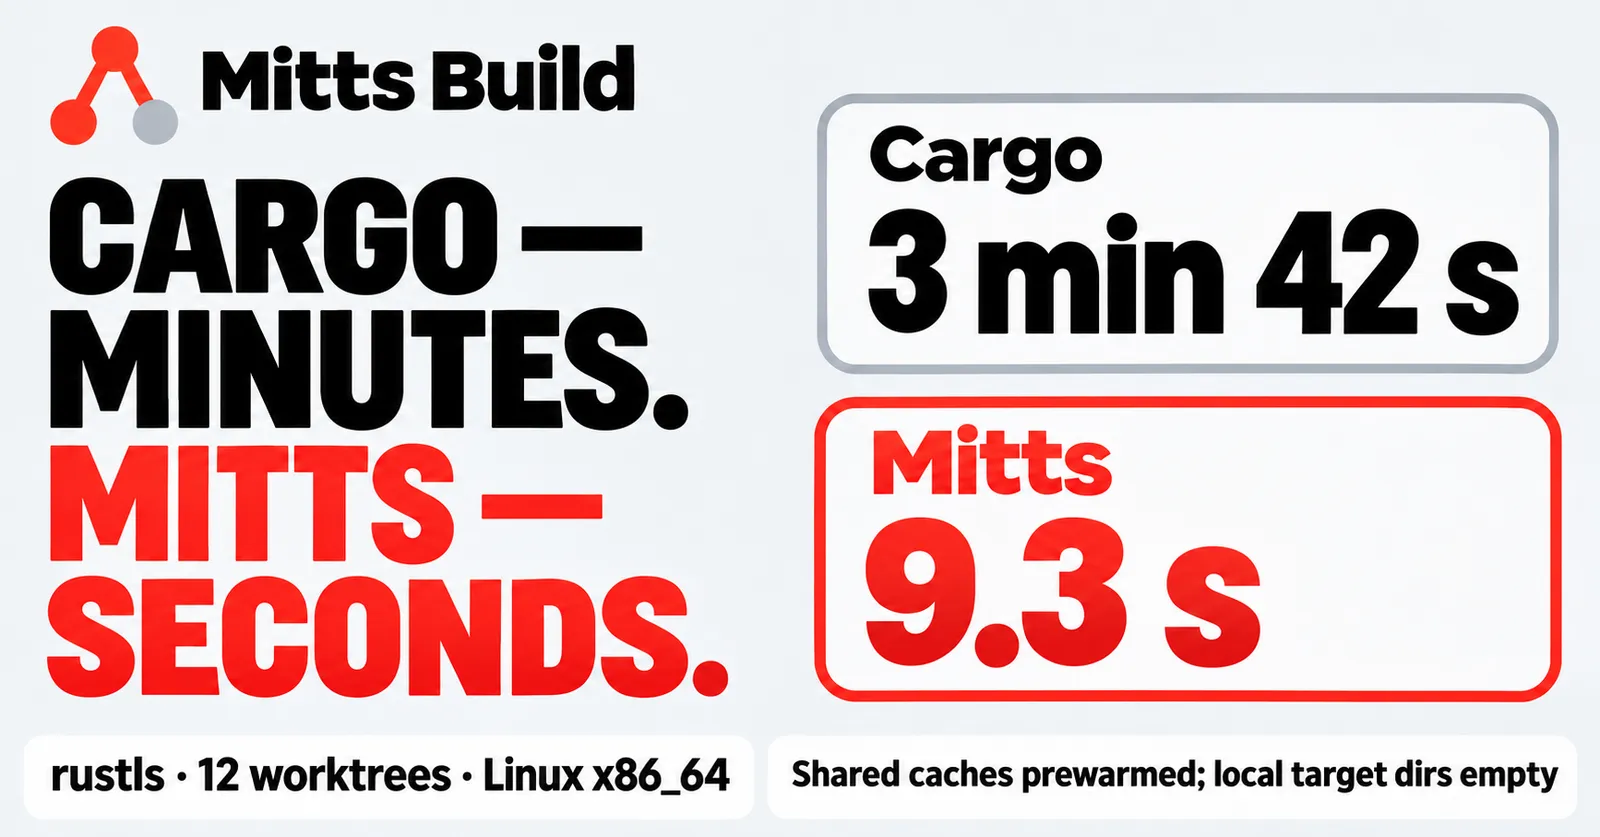
Mitts 并行构建 12 个 rustls worktree 仅需 9.3 秒,Cargo 耗时 3 分 42 秒
来源标题:Cargo Takes Minutes. Mitts Takes Seconds: 12 Rustls Worktrees
在 Linux x86_64 上并行构建 12 个 rustls worktree,Mitts 完成整批构建仅用 9.3 秒,而 Cargo 需要 3 分 42 秒。测试中共享缓存已预热且各 worktree 的 target 目录为空,不计首次预热构建时间;Mitts 通过跨 worktree 复用已完成结果实现加速。作者也说明了 Cargo 在冷构建或增量构建场景下仍占优的情况。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在 Linux x86_64 上并行构建 12 个 rustls worktree:Cargo 耗时 3 分 42 秒,Mitts 耗时 9.3 秒。预热过的共享缓存如何复用构建成果——以及 Cargo 在哪些方面仍然胜出。
TL;DR。在 Linux x86_64 上并行构建 12 个 rustls worktree,Cargo 耗时 3 分 42 秒,Mitts 耗时 9.3 秒。共享缓存均已预热,本地 target/ 目录为空;初始的预热构建不计入成绩。Mitts 在多个 worktree 之间复用已完成的构建结果。以下是测量结果、背后机制,以及 Cargo 的冷构建或增量构建仍然胜出的场景。
Cargo 要几分钟。Mitts 只要几秒。
对于并行工作来说,问题很简单:整批构建什么时候能全部就绪?代码已经分散在各个分支上。现在你需要完成的构建产物,才能继续做验证。
在 The Hundred 这项测试中,Linux x86_64 上的 12 个 rustls worktree 用 Cargo 构建耗时 3 分 42 秒,用 Mitts 只要 9.3 秒。这是单个项目整批构建的完成时间,而不是语料库总和,也不是第一个完成的 worktree 的时间。
在这种配置下,原生 Cargo 在多个 worktree 之间没有共享的编译缓存:每个新检出的工作副本都从空的 target 目录开始。Mitts 和 sccache 接收的是预热过的共享缓存。sccache 同样以热缓存启动,但这批构建仍花了 3 分 59 秒:在编译器调用内部做缓存,并不能消除整个重复的构建过程。
我之所以选择一个长时间构建的例子,是为了让“等待构建产物”这件事变得具体。这并不承诺每个项目都能达到相同时间,也不是在衡量 agent 完成整个任务有多快。
一个 agent 分到一个 worktree,一个 reviewer 分到另一个,一个修复任务再分到第三个。每个都有自己的 target/ 目录。源码隔离很干净。但另一次检出不应该自动意味着重复相同的、可复用的编译工作。
“给每个 agent 一个自己的 target 目录”是一条隔离策略,但附带一张编译账单。我构建 Mitts,就是为了让各个 worktree 保持隔离,同时又能共享已完成的构建成果。
主要场景是:在一个项目的 12 个 worktree 中,用 test --no-run 构建测试,这些 worktree 分布在四个 commit 上,同时启动。它在同一台机器和同一套工具链上比较原生 Cargo、带 sccache 的 Cargo 和 Mitts。Cargo 以离线模式运行。测试执行不计入计时构建。
每次重复都使用全新的 worktree,本地 target/ 目录为空,源码已预先拉取。共享缓存从快照启动,这些快照由第一个 commit 的一次不计时构建预热而成。计时的那批构建衡量的是在这些全新检出之间复用成果、以及在其它 commit 上编译差异的成本;它不包含最初那次预热成本。
这项研究选取了 100 个开源 Rust 项目。实际测量的数量为:macOS 上 100 个,Linux x86_64 上 90 个,Linux aarch64 上 100 个。对应机器的逻辑 CPU 数分别为 24、32 和 128。语料库和完整的公开机器规格见研究页面。
每个读数取三次重复的中位数。rustls 图表只展示一个项目;完整语料库则揭示分布情况。时长标签被截断到所显示的精度,而条形长度使用的是底层数值。
所有被测项目都保留在结果中,包括七个标记为“wide spread”(分布过宽)的 Linux x86_64 运行。一个空闲状态检查曾检查 CPU 负载和外部编译器活动;它并没有移除 Mac 上常驻的 agent 会话。三次重复并不构成置信区间,而且总计会让重型项目拥有更大影响。研究的项目表格和精简数据展示了这一分布。
上面的 rustls 是 Linux x86_64 上的一个重型项目。现在看完整的 Mac 语料库,看看哪些重复工作可以被消除:
sccache 显然有助于降低 CPU 时间。但在这个工作负载中,它仍然要为每次编译器调用启动一个包装程序,Cargo 仍然要规划每次构建并运行构建脚本,而像测试二进制文件这样的链接产物不在 sccache 的编译缓存覆盖范围内。削减这些调用内部的编译器工作,并不能消除整个重复的构建过程。
以 Mac 上的 actix-web 为例:12 个 worktree 的构建用 Cargo 耗时 5 分 22 秒,用 sccache 耗时 5 分 23 秒,用 Mitts 耗时 56 秒。Cargo 进行了 3,408 次编译器调用;Mitts 只进行了 181 次。
磁盘也需要两个定义。设备写入字节数衡量的是到达块设备的写入量。du 衡量的是工作区文件和共享存储,在 XFS 上会把每个 copy-on-write 克隆完整计入。在 Linux x86_64(XFS)上,磁盘占用总量从 641 GB 降到 484 GB,而设备写入量从 651 GB 降到 106 GB。这些读数描述的是不同的成本;两者不能互相替代。
显而易见的捷径是共享 CARGO_TARGET_DIR。但它也会共享可变输出。
研究特意在第十二个 worktree 中放入一个失败的测试。所有 worktree 都必须编译,并产生与原生 Cargo 相同的测试二进制文件数量。随后进行的不计时冒烟检查要求:被修改的 worktree 在该测试上失败,而一个干净的 worktree 则通过。
共享 target 的演示未能通过这项检查:注入的失败被遗漏,或者泄漏到了干净的 worktree 中。它被排除在评分之外。
很好:构建变快了,但测试跑的是错误检出中的代码。我想要的是能用的构建。
这个结果涉及的是不同 commit 上的并发构建,它要求在 agent 之间设计复用时,不能只满足于“目录现在是一样的”。
Mitts 读取现有的 Cargo.toml 和 Cargo.lock,规划编译图,并直接调用 rustc。技术文档描述了六个阶段:resolve、fetch、plan、key、execute、publish。
每个单元都会得到一个 action key,该 key 由其工具链、target、profile、flags、features、源码内容、依赖的 action key 以及受跟踪的环境推导而来。输入匹配的单元可以复用已有结果。输入变化则 key 变化。如果某个输入 Mitts 无法解释,该单元就会变为不可缓存,或者被明确标记为不支持。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。