VEKTOR 2.0.4 更新:新增 Hacker News 图书与视频搜索
来源标题:We added Hacker News Books/Videos search into our app
VEKTOR 2.0.4 将 Hacker News 的图书和视频推荐纳入应用库中,同时升级 Node v26 和 Better-sqlite3 v13 以获取最新安全更新。付费计划用户每月可获得 GLM-5.3-Flash 模型 8000 万 tokens,新试用注册用户可获 100 万试用 tokens。应用还新增程序性记忆节点,构成五层记忆图。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
LLM AI 记忆 AI VEKTOR 2.0.4:新增 Hacker News 书籍/视频——Node.js 与 SQLite 安全升级 Vektor Memory 阅读时长 7 分钟· 刚刚
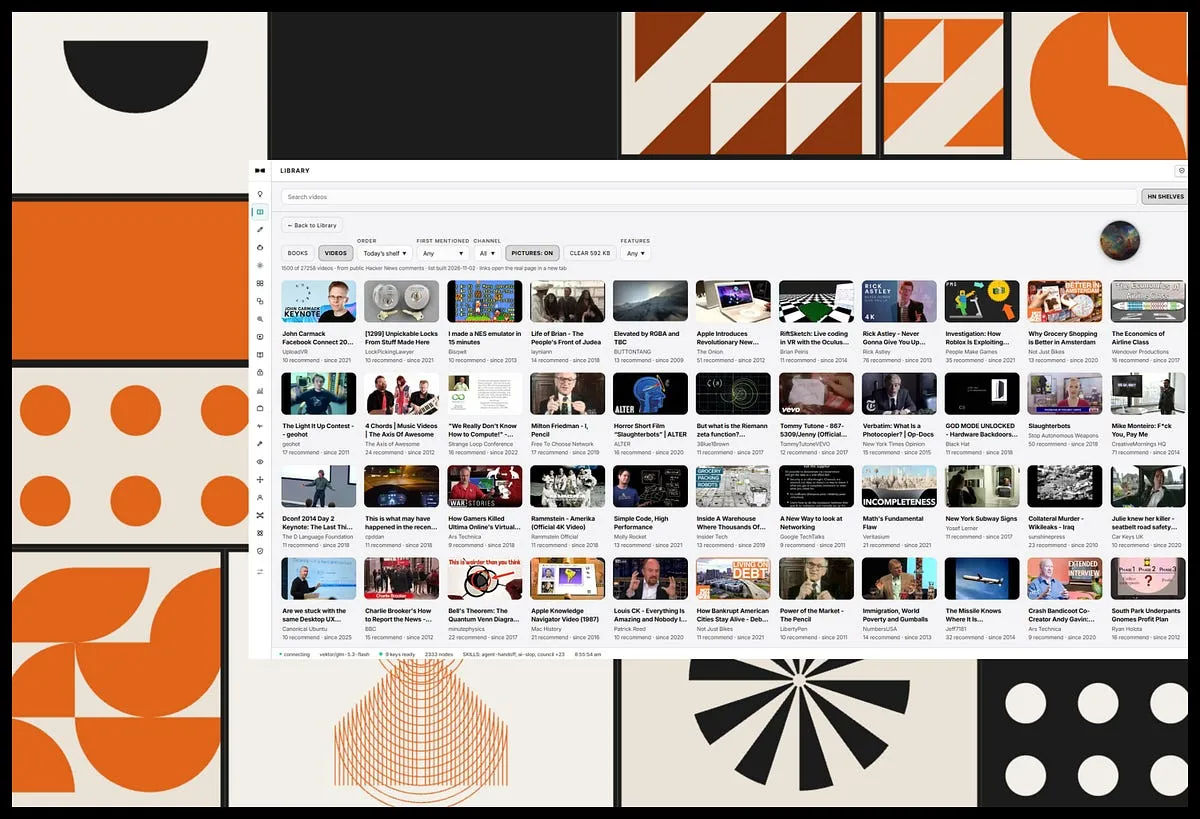
Library HN Videos 又一次超大更新。我们现在把 Hacker News 的书籍和视频推荐加入了资料库。 我们新增了 100 万试用 token,所有新注册试用用户都会获得,可通过信用卡测试这些系统。 我们现在在每月 9 美元的付费方案中,为每位用户每月提供 8000 万 token 的 GLM-5.3-Flash 模型;随着更新、更快的模型发布,我们会升级到这些新模型。你仍然可以使用免费的模型提供商选项以及 Ollama 本地 GPU,由你选择。 我们升级到了 Node v26 引擎,以获得最新安全更新,并支持自动回退到你自己的 Node 版本,以及在 Vektor 升级节点就绪后使用该节点。 我们还升级到了 Better-sqlite3 v13:一个二进制文件同时支持 Node 22、24 和 26。 我们还升级到了最新的 ONNX 版本,现为 1.30.0。 我们新增了程序性记忆节点,构建出 5 层图谱:实体、因果、时间、语义和程序性。 根据 Ollama 的通知,从 11 月 9 日起,Ollama Cloud 将变为按量付费提供商,我们已在模型部分更新了这一信息。 Hacker News 评论是互联网上最好的阅读清单之一,却没有人能搜索它们。我们把公开评论中的书籍和视频合并成了自己的清单:约 9,100 本书和 27,000 个视频,每一项都标注了有多少不同的人推荐过它,以及它首次被提及的时间。 它位于 Library 下的 HN SHELVES。 你可以选择书籍或视频,在 Open Library 中查看(今日书架、历史最佳、上升中、最近推荐、最新或最早提及、标题 A-Z),并按出版年份、首次提及年份、主题和特性进行筛选。 点击一张卡片,Explain 面板会通过即时 LLM 响应告诉你这本书讲什么、适合谁,使用的是你已经选好的模型。 图片默认关闭,直到你手动开启。开启后,封面只会为你滚动经过的卡片加载,在你的电脑上被压缩到约 4 KB,并保存在本地缓存中。 我们的服务器上不存储任何内容。如果一本书没有封面,或者来源发送的是空白封面,你会看到一张根据标题生成的 Bauhaus 风格图案,这样同一本书始终看起来一样。 HN book section 我们新增了用于“如何做事”的程序性记忆 事实只是你所记忆的一半。另一半是“如何做”:最终让一次发布上线的步骤、你检查电子表格的顺序、你回复一封棘手邮件的方式。 程序性记忆把这些保存为例程。一个例程有简短名称、何时使用、编号步骤以及完成时的样子。新例程以草稿开始。经过两次成功后变为启用状态,连续三次失败后则被停用。保存前,每个字段中的敏感信息都会被剔除。 当一个问题匹配某个启用中的例程时,这些步骤会被添加到提示词末尾,也就是小模型有限窗口能容纳它们的位置。 你可以手写一个例程,粘贴有效做法让模型起草,或者把一个好的例程变成可复用的技能。图谱中有一个 Procedural 层,将每个例程与它来源的记忆关联起来,agents 获得五个工具来查找和保存它们。 这有用吗?我们做了一次小测试:十个模拟数据任务,每个任务都包含只有该例程才能提供的具体信息,每个任务运行三次,使用两个模型。 这些任务是模拟的,评分是字面式的,区间也很宽,所以请把这理解为“这个想法可行,底层机制是正确的”,而不是一个可以引用的基准测试;下周我们会用更多数据进行微调,然后用完整基准测试再次验证。 Graph view 一个自带 4000 万 token 小配额的模型 由于各提供商的免费额度不断变化和缩水,我们新增了一个名为 VEKTOR Included 的提供商。在模型列表中选择它,即可使用 GLM-5.3-Flash 聊天。 过去,在 Desk 中提一个问题需要两次模型调用。开启工具后,Desk 首先让模型决定使用哪些工具,在不需要工具时丢弃返回的答案,然后再次请求最终文本。 现在,当第一次回复就是答案时会直接使用它,而且每一轮都会流式输出,所以首批文字会在生成时立即显示。一个问题只需一次调用,而不是两次。 我们还逐个模型检查了 NVIDIA 免费端点。我们此前默认提供的 gpt-oss-20b 在 90 秒时超时。nemotron-3-nano 在 1.1 到 1.3 秒内给出了真实答案。现在默认模型是 nemotron-3-nano。 Studio 时间线新增了 20 种效果、8 种转场、字幕、配音和 shorts 查找器。新增的是 Chroma key:它让绿幕或蓝幕变为透明,并带有控制边缘柔和程度以及从头发和边缘去除多少绿色溢光的选项。 我们还逐项比较了时间线与其他工具的功能,并写下了逐步升级这些功能的计划:前四项现在已是时间线工具栏中的一键按钮。 Auto cut 会移除安静片段并闭合间隙(一个 8 秒测试片段中有 2 秒静音,结果缩短了 1.8 秒),Beats 会在每个节拍上放置标记,Duck 会在语音片段下降低音乐音量,Level 会根据响度设置片段的音量。每一项都只需一次撤销。 后续还有通过删除转录文本中的词语来剪辑、降噪清理以及跟随主体的重新构图。一个宽松许可的开源套件结果描述了其中大部分方法,这让我们省去了猜测。 使用 npm install -g ./vektor-slipstream-2.0.4.tgz 更新并打开应用。 Library,然后是 HN SHELVES,是最快的体验路径。 程序性记忆位于 Config 中,如果你想看到图谱层填充起来,可以使用 Add 5 examples 按钮。 VEKTOR included 模型配额位于模型列表中,需要你已有的许可证。 版本 2.0.4 已在下载页面上线:https:www.vekmem.com 完整变更列表:https://vektormemory.com/docs/changelog Novel Technology · Privacy Enhanced · Data Sovereignty · Vektor Memory 600+ models BYOK · 60+ MCP tools · 16 Model Providers
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。