Netflix 构建大规模事实核查系统,提升剧情简介准确性
来源标题:Fact-Checking at Scale: Building a More Accurate and Efficient Synopsis Factuality System
Netflix 搭建了一套可规模化的事实核查系统,用于检查剧集简介内容是否准确。该系统针对简介中的事实性描述进行自动核验,确保面向观众的剧情介绍不出现与作品实际内容不符的表述。相关方法由 Netflix 工程团队在技术博客中披露。
以下正文由 AI 翻译自 Netflix TechBlog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
作者:Shreya S Ramanujam、Yongce Li、Afshine Amidi、Sina Ghiassian、Benjamin Klein。
引言
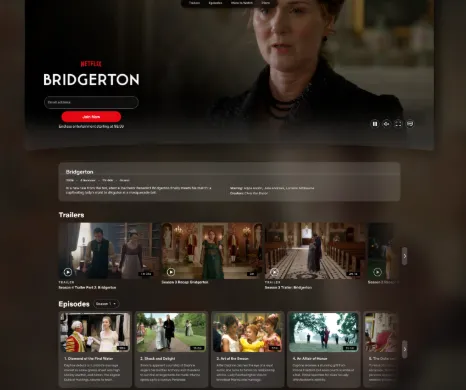
想象这样一个场景——你结束了一天的忙碌工作回到家,迫不及待地想追《Bridgerton》。你登录 Netflix,搜索“Bridgerton”,然后看到了这个页面: 如果这一幕让你感到熟悉,那你其实已经知道什么是简介了——它是对观众能在一部剧中看到什么内容的简短预览。在这里我们看到两种类型的简介:一种是剧集级别的简介,描述整体剧情;另一种是多条单集级别的简介,分别描述每一集。 简介对我们来说扮演着非常重要的角色——它帮助观众判断一部作品是否值得观看。每一条简介都需要把握好平衡:既要分享足够的信息,让观众对内容有所预期,又要保留足够的悬念来吸引他们。但当然,我们不能随便写什么都可以。 “在雾气弥漫的维多利亚时代伦敦街头,侦探 Daphne Bridgerton 争分夺秒地要揭开一个只被称为神秘 Lady Whistledown 的连环杀手的真面目。” 引人入胜?确实。但这绝对不是《Bridgerton》的故事前提。这就引出了撰写优质简介的第一条(也是最重要的一条)规则:它必须符合事实。以 Netflix 的规模——数千部作品、每季多集、多种语言——人工核查所有这些内容根本不可扩展。这正是我们的事实性服务发挥作用的地方:一种自动判断简介是否符合事实的方法。 我们目前的事实性检查器会把关于一部作品的所有已知信息(如元数据和文本素材)输入给一个推理模型,并要求它按照一套严格的评分标准来判断简介的事实性。这种方法有两个我们希望优化的主要局限:
- 长上下文推理调用的高成本:每次判定都需要对推理模型发起昂贵的、长上下文的调用,当我们想要检查多个作品、多集、多种语言和多种风格变体时,这种方式无法很好地扩展。
- 推理依据不一致:模型的解释常常与我们的标注人员的推理相偏离,这使其事实性判定不够可靠。我们希望这些推理依据能更好地对齐,从而(1)模型能够稳定地识别出细微错误,(2)其解释可以用于下游,自动修正简介中的问题。 我们的新方法同时解决了这两个问题。在成本方面,每条简介的处理成本降低了 52.4%。在质量方面,它显著提升了判定准确性和推理对齐度:Recall–Fail(“在所有真正不符合事实的简介中,系统正确拒绝了多少?”)从 0.77 提升到 0.86,并且新的事实性服务的解释与人工推理依据的重叠度现在约为 82%(此前约为 69%)。换句话说,它不仅更便宜、更准确——而且与我们专家标注人员实际判断简介的方式更加一致。
那么,事实性到底意味着什么?
让我们回到《Bridgerton》的例子。假设你看到这条关于《Bridgerton》第一季的简介: 简介 A:“《Bridgerton》讲述了强大的 Bridgerton 家族的长女 Daphne Bridgerton,在竞争激烈的摄政时期伦敦婚恋市场上初次亮相的故事。” 很容易判断这条简介在事实上是正确的——没有错误的事实,并且给读者提供了一个清晰、准确的预期。 再看另一个例子: 简介 B:“这部 gritty 犯罪剧以现代伦敦为背景,讲述了侦探 Daphne Bridgerton 在追捕一名连环杀手的同时,隐藏自己犯罪过去的故事。” 这也很容易判断——剧情离谱得如此明显,绝对不符合事实。 但这条呢? 简介 C:“《Bridgerton》讲述了神秘而尖刻的 Lady Whistledown,通过她那充满丑闻的八卦小报揭露伦敦上流社会的秘密。” 严格来说,这里的每一句话都是真的——Lady Whistledown 确实出版一份八卦小报,如果说她有什么出名之处,那就是她尖刻的揭露。那么,这是一条符合事实的简介吗? 并不完全是!虽然严格来说是真的,但它描绘了一幅误导性的画面。新观众可能会合理地以为这部剧围绕 Lady Whistledown 展开,而不是 Daphne 在婚恋市场上的周旋。这也是我们想要捕捉的一类不符合事实的情况。 最后,来看最棘手的一条: 简介 D:“当 Daphne Bridgerton 在社交界初次亮相时,她引起了冷漠的 Duke of Hastings 的注意,两人开始了一段激情恋情,让整个 ton 都议论纷纷。” 同样,每一句话都是真的,但措辞具有误导性。新观众可能会以为他们立刻坠入爱河,而忽略了他们的关系最初只是一场虚假的、互利的安排。这是我们的系统应该标记的另一类细微错误。 现在我们已经了解了我们关心的错误类型,真正的问题是:我们如何构建一个系统,既能捕捉明显的错误,也能捕捉细微的事实性违规?
当前服务及其局限
我们当前的事实性流水线是一个直接的整体式 LLM 调用。我们把关于一部作品的所有已知信息(文本素材、元数据和详细的事实性评分标准)输入给一个推理模型,并要求它判断一条简介的事实性。我们重复调用多次以减少输出的随机性,如果任何一次运行将简介标记为不符合事实,它就不通过。这种方法有两个主要局限:
- 高成本:每次判定都需要对大型推理模型进行多次(确切地说是五次)超长上下文(10 万+ token)调用,这种方式无法很好地扩展。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。