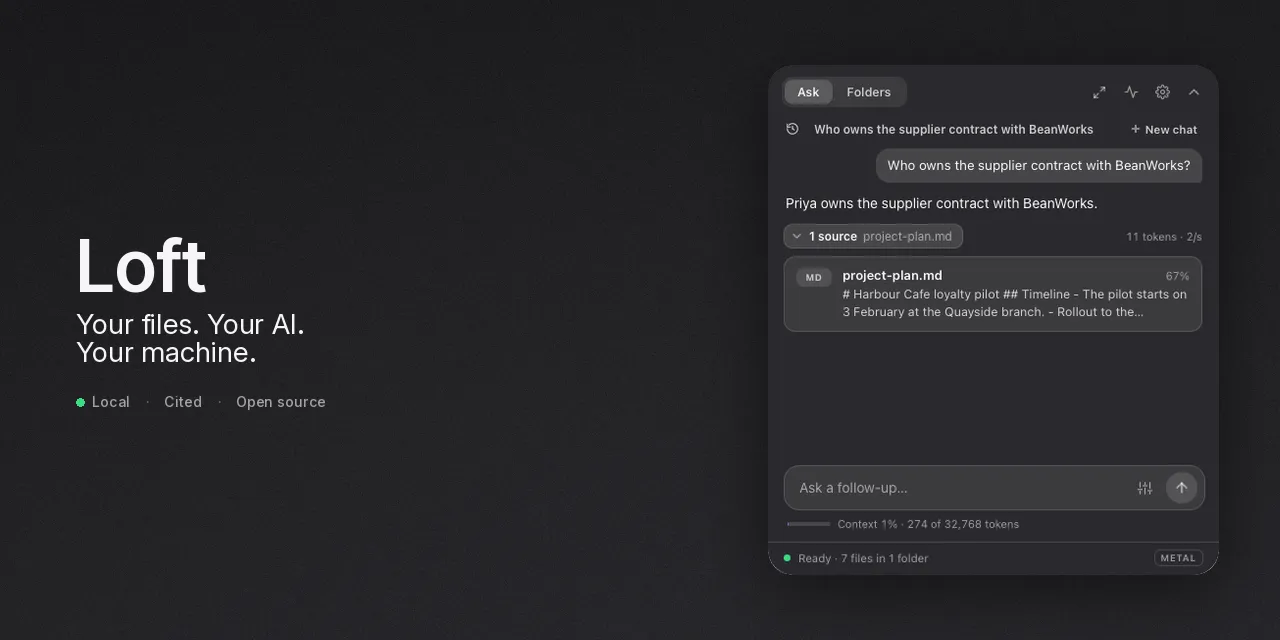
Loft:基于 llama.cpp 的本地文件离线问答工具,支持引用来源
来源标题:Show HN: Loft – offline Q&A over your local files, with citations (llama.cpp)
开发者 nwaoga 在 GitHub 上发布 Loft,一款基于 llama.cpp 的本地 RAG 工具,可对选定文件夹内的文件进行完全离线的问答并给出来源引用。该工具需 Node.js 18+ 和 Rust 1.85+,通过 npm run fetch-llama 下载对应系统的 llama.cpp 服务端,模型则在应用内下载选用。使用时在设置中选择聊天与嵌入模型、添加文件夹即可提问,Ctrl/Cmd+Shift+Space 可唤出界面。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
官方渠道:github.com/nwaoga/loft 一个本地的 RAG 小工具,针对你选定的文件夹里的文件回答问题——完全离线,基于 llama.cpp 运行。
快速开始 · 在你的机器上 · 构建 · 已知缺口 需要 Node.js 18+ 和 Rust 1.85 或更新版本(锁文件使用 edition 2024)。Windows 还需要 MSVC C++ 构建工具和 Windows 10/11 SDK。WebView2 是所用的 webview,Windows 11 上已自带。Linux 需要「构建」一节中列出的软件包,包括 WebKitGTK 4.1 和托盘库。macOS 需要 Xcode 命令行工具。
npm install npm run fetch-llama fetch-llama 会下载适用于当前操作系统的 llama.cpp 服务端构建,放到 src-tauri/binaries/(该目录已被 git 忽略)。模型稍后在应用内下载。
Windows。scripts\win-dev.bat 会选择 MSVC 工具集并运行应用。
npm run tauri dev 只运行 notch UI、使用模拟数据、不涉及 Rust:npm run dev → http://localhost:1420。
在应用内:设置(齿轮图标)→ 下载并选择一个聊天模型和一个 embedding 模型 → 文件夹 → 添加一个文件夹 → 提问。Ctrl/Cmd+Shift+Space 可以唤出 notch。sample-docs/ 是一个用于试验的小文件夹,其中的 scans/ 存放了一张图片和一个扫描版 PDF,用来在 Windows 上试用 OCR。
这些构建未签名。macOS 和 Windows 首次运行可能会给出警告。应用本身没有损坏。参见「首次打开」。安装器和各平台步骤见「构建」。
Loft 在这台电脑上运行 llama.cpp。提问不会调用云端 API,也不需要 API key。两个本地 llama-server 进程负责干活:一个用于聊天,一个用于 embedding(embedding 模型无法可靠地与聊天共用同一个进程)。
添加或移除一个文件夹,然后针对其中的内容提问:文本和代码、PDF、Word、PowerPoint、电子表格以及图片。Loft 会对它们分块,并在文件变化时保持索引更新。可以在同一个标签页里重建或删除该索引。
回复在前。下方有一个「N 个来源」抽屉,存放生成回复所依据的摘录(默认对最新回答展开)。点击其中一条,会用默认应用打开对应的文档或图片。代码和脚本只在文件管理器中显示位置,绝不会被执行。
引擎和设备由你选择。CPU 和 Vulkan 随 fetch-llama 一起提供。Mac 上还提供 Metal。CUDA 和 OpenVINO 是可选项,从「设置」安装,或用 npm run fetch-llama cuda / openvino 安装。接电源和使用电池时可以选择不同的配置。
对话保存在应用数据文件夹中的 chats.db 里,不会存到别处。它与索引是不同的数据库:删除索引绝不会影响聊天,删除聊天也绝不会影响你的文件。
模型目录是一份内置列表。在「设置」中从目录里下载一个聊天模型和一个 embedding 模型。下载文件的 SHA-256 若与 src-tauri/catalog.json 中的不符,会被丢弃。只有更换 embedding 模型才会重建索引。更换设备则保留索引。
长度、语气、引用、temperature,以及回答是否允许离开你的文件,都在「发送」旁边的一组选项里。它们保存在 webview 的本地存储中。完整列表见「工作原理」。
规划中的里程碑(M0–M6)均已实现。但实际运行验证的范围比这更窄,HANDOVER.md 中有记录。
其余的缺口——未签名的安装器、OCR 仅在 Windows 上可用、NPU 只在一台机器上验证过、电源切换只是模拟——见「已知缺口」。
文档
内容
工作原理
索引、回答如何生成、OCR、选项、追问、聊天历史,以及进程关系图。
构建
Windows、macOS 和 Linux:前置条件、调试运行、安装器、签名。
首次打开
针对这些未签名构建的 Gatekeeper 和 SmartScreen 说明。
运行 Loft
主题、notch 或浮动模式、托盘、登录时启动、图标。
引擎、性能与电池
设备、回退、OpenVINO、NPU 运行,以及性能测试。
测试
单元测试和冒烟脚本。
已知缺口
尚未实际验证的部分。
ARCHITECTURE.md
代码、数据,以及为何如此设计。
项目结构
src/ # notch UI(Svelte 5 + Vite)
App.svelte # notch 外壳:胶囊 ⇄ 面板、标签页
lib/components/ # 提问、文件夹、设置(主题、模型、通用)
lib/theme.svelte.ts # 主题列表 + 记住的选择(颜色在 app.css 中)
lib/api.ts # Tauri 命令(+ 浏览器 mock)
lib/types.ts # 与 Rust 共享的 DTO
src-tauri/ # Rust 后端(Tauri 2)
src/lib.rs # 命令、窗口尺寸、托盘、快捷键
src/inference.rs # 引擎与设备:决策规则(不涉及进程;有单元测试)
src/engine.rs # 协调器:服务端的每次启动、切换和重启
src/runtime.rs # 查找引擎、启动和停止 llama-server
src/hardware.rs, power.rs # 操作系统报告的信息:GPU、NPU、驱动;接电源还是电池
src/installer.rs # 可选引擎:固定版本下载、校验和、安全解包
src/bench.rs # 测试性能、立即尝试……,以及测量结果给出的建议
src/history.rs # 聊天历史:对话、消息及其来源(chats.db)
src/models.rs # 模型下载
src/store.rs # sqlite-vec 存储
src/parse.rs, chunk.rs, indexer.rs, jobs.rs # 索引 + 文件监听
src/ocr.rs # 图片和扫描版 PDF 页面的文字识别(Windows)
src/vision.rs # 可选:用小视觉模型生成图片描述
src/rag.rs, opener.rs # 回答 + 打开来源
catalog.json # 精选模型目录(GGUF URL)
engines.json # 某个固定版本 llama.cpp 的各平台构建,附校验和
tauri.conf.json # 透明、顶部居中、置顶窗口;打包配置
scripts/
fetch-llama.mjs # 下载并校验适用于当前操作系统的 llama.cpp 构建
make-engines-manifest.py # 将 engines.json 重新固定到另一个 llama.cpp 版本
smoke-ui.js # 在调试构建中驱动真实 UI(参见 docs/testing.md)
smoke-engines.js # 对引擎、电源、回退和性能测试做同样的事
smoke-restart.js # 在 smoke-ui.js 之后:关闭 Loft 后聊天历史仍然保留
set-version.mjs # 版本号(package.json 和 Cargo.toml)
icons.mjs # 从 app-icon.svg 生成 src-tauri/icons(npm run icons)
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。